

3.1 KNN算法介绍
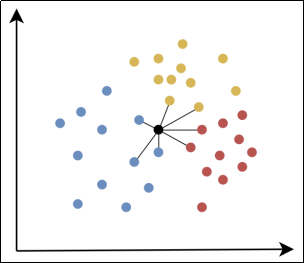
K近邻算法(K-Nearest Neighbors,KNN)是一种基本的分类与回归方法,属于监督学习算法。其核心思想是通过计算给定样本与数据集中所有样本的距离,找到距离最近的K个样本,然后根据这K个样本的类别或值来预测当前样本的类别或值。
3.1.1 工作原理
计算距离:计算待分类样本与训练集中每个样本的距离。
选择K个近邻:根据计算的距离,选择距离最近的K个样本。
投票或平均:
- 分类任务:统计K个近邻各类别的数量,将待分类样本归为数量最多的类别。
- 回归任务:取K个近邻的平均值作为预测结果。
3.1.2 关键参数
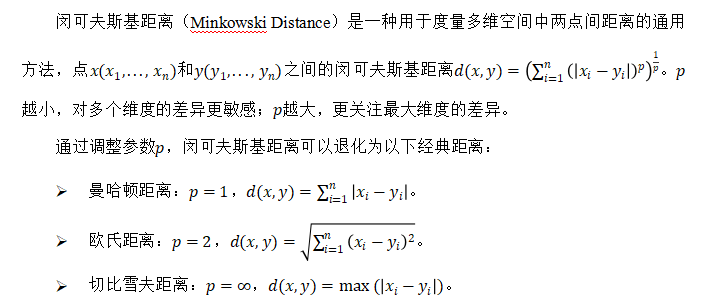
距离度量方法:选择合适的距离度量方法,常见的有欧氏距离、曼哈顿距离、切比雪夫距离、闵可夫斯基距离等。
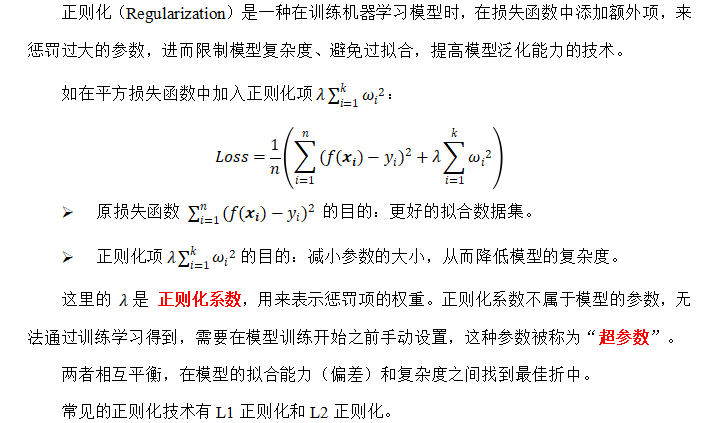
K值:K值的选择对结果影响很大。K值过小容易过拟合,K值过大则可能欠拟合。
3.1.3 优缺点
KNN优点:
- 简单直观,易于理解和实现。
- 无需训练过程,直接利用训练数据进行预测。
KNN缺点:
- 计算量大,尤其是训练集较大时。
- 对噪声数据较敏感。
3.1.4 API使用
1.分类
from sklearn.neighbors import KNeighborsClassifier

knn = KNeighborsClassifier(n_neighbors=2)  # KNN分类模型,K值为2
X = [[2, 1], [3, 1], [1, 4], [2, 6]]  # 特征
y = [0, 0, 1, 1]  # 标签
knn.fit(X, y)  # 模型训练
knn.predict([[4, 9]]) # 预测2.回归
from sklearn.neighbors import KNeighborsRegressor

knn = KNeighborsRegressor(n_neighbors=2)  # KNN回归模型,K值为2
X = [[2, 1], [3, 1], [1, 4], [2, 6]]  # 特征
y = [0.5, 0.33, 4, 3]  # 标签
knn.fit(X, y)  # 模型训练
knn.predict([[4, 9]])  # 预测
3.2 常见距离度量方法
3.2.1 欧氏距离
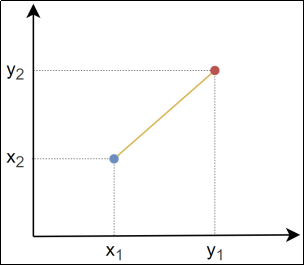
欧几里得距离(Euclidean Distance)是指连接两点的线段的长度。

3.2.2 曼哈顿距离
曼哈顿距离(Manhattan Distance)是两点在标准坐标系上的绝对轴距之和。
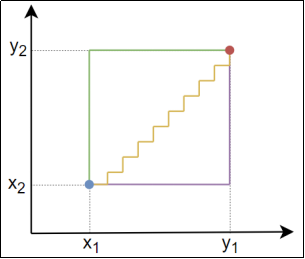

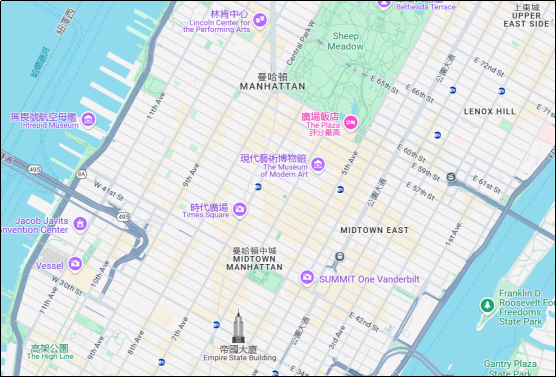
曼哈顿距离得名于纽约曼哈顿的街道布局。由于曼哈顿的街道多为规则的网格状,车辆只能沿水平和垂直方向行驶,无法直接斜穿。因此,两点之间的实际行驶距离是沿街道行走的距离,而非直线距离。
3.2.3 切比雪夫距离
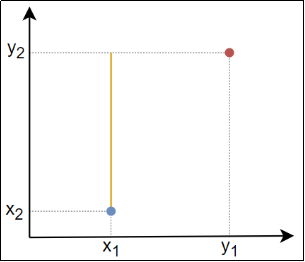
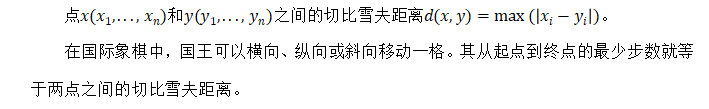
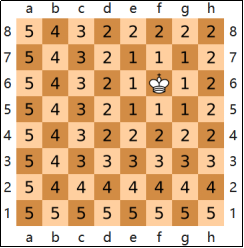
切比雪夫距离(Chebyshev Distance)是两点各坐标数值差的最大值。
3.2.4 闵可夫斯基距离
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END










请登录后查看评论内容