



4.1.8 存在问题
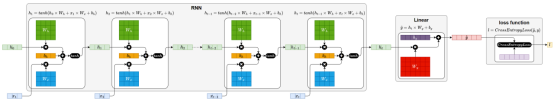
尽管循环神经网络(RNN)在处理序列数据方面具有天然优势,但它在实际应用中面临一个非常严重的问题:长期依赖建模困难。这指的是:在训练过程中,当输入序列很长时,模型难以有效学习早期输入...
4.2 LSTM
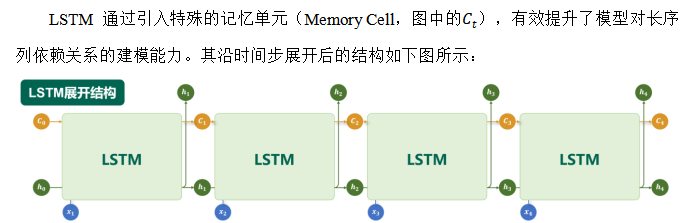
4.2.1 概述 为了缓解RNN梯度消失或者梯度爆炸的问题,Hochreiter和Schmidhuber于1997年提出了长短期记忆网络(Long Short-Term Memory, LSTM)。 4.2.2 基础结构 各部分具体说明如下: 记忆单元...
小节四:Working Memory 怎么设计才不会变成“第二个垃圾桶”——生命周期、边界与质量控制
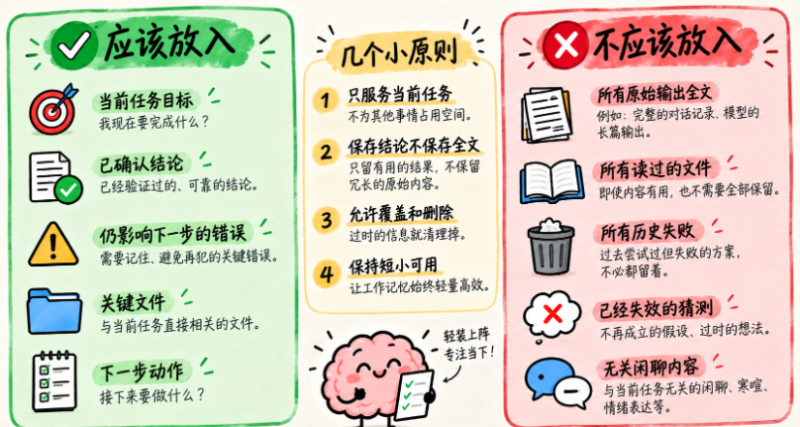
很多同学学到这里会进入另一个极端:既然 Working Memory 这么有用,那是不是多存一点更稳?其实恰恰相反,Memory 一旦没有边界,很快就会变成第二个垃圾桶。下面这张图,左边讲“应该放什么”...
2.5.5 交叉验证
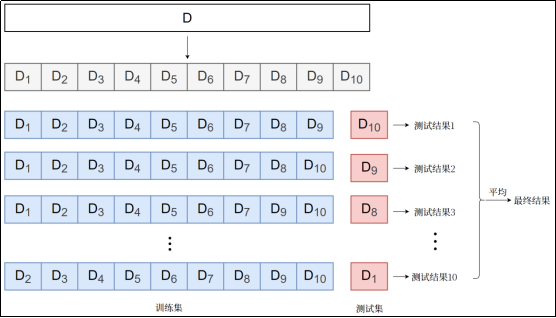
交叉验证(Cross-Validation)是一种评估模型泛化能力的方法,通过将数据集划分为多个子集,反复进行训练和验证,以减少因单次数据划分带来的随机性误差。通过交叉验证能更可靠地估计模型在未知...

6.4 张量转换
6.4.1 张量元素类型转换 1)Tensor.type(dtype)修改张量的类型 import torch tensor1 = torch.tensor([1, 2, 3]) print(tensor1, tensor1.dtype) # 使用type方法修改张量的类型 tensor1 = t...
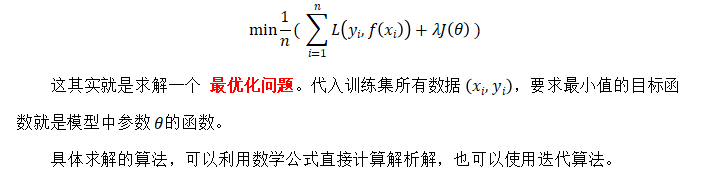
2.6 模型求解算法
正则化可以有效防止过拟合,增强模型的泛化能力。这时模型的评估策略,就是让结构化的经验风险最小,即增加了正则化项的损失函数最小,称为 结构风险最小化(Structural Risk Minimization,SRM...
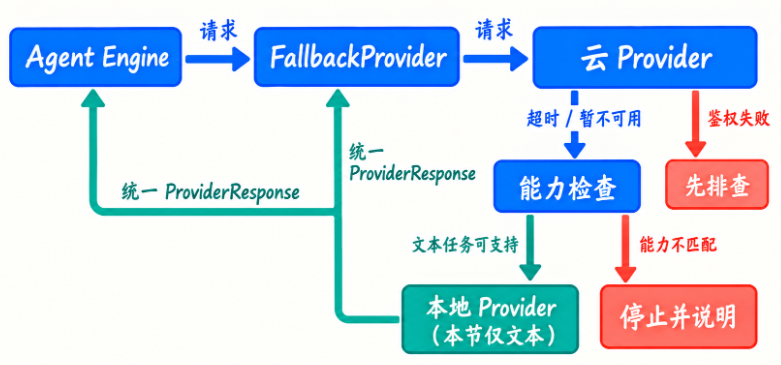
案例分析二:云模型故障时自动切本地——Provider 抽象为什么是 Fallback 的前提?
场景背景 假设 Data Analysis Agent 正在公司内部使用。 正常情况下使用云模型。 但偶尔会遇到: 超时 限流 网络异常 Provider 服务不可用 如果模型不可用,整个 Agent 就停了。 团队希望,云模...
第一章 NLP导论
1.1 定义 自然语言处理(Natural Language Processing, NLP),是人工智能领域的一个重要分支。自然语言,指人类日常使用的语言(如中文、英文),NLP的目标是让计算机“理解”或“使用”这些语...
2.4 高级特性
2.4.1 部分变量预填充:partial() 预填充某些固定不变的变量,创建模板的变体。 使用场景: 某些变量在所有调用中都相同 需要为不同用户/场景创建定制模板 举例1: from langchain_core.prompts...
3.5 数据清洗与预处理
章节核心内容关键知识点1. 缺失值处理检测、删除和填充缺失值的方法isna(), dropna(), fillna(), 前向/后向填充, 均值/中位数填充2. 重复数据处理识别和删除重复行 duplicated(), drop_dup...

