

场景背景
假设 Data Analysis Agent 正在公司内部使用。
正常情况下使用云模型。
但偶尔会遇到:
超时
限流
网络异常
Provider 服务不可用
如果模型不可用,整个 Agent 就停了。
团队希望,云模型失败时,某些低风险任务自动切本地模型。
问题矛盾
如果不同模型的调用代码散落在 Agent Engine 中,Fallback 会非常难写。
你可能得到:
try:
    openai...
except:
    try:
        claude...
    except:
        local...
Agent Engine 彻底被 Provider 逻辑污染。
前置条件
统一接口:
LLMProvider.chat()统一异常:
ProviderError
ProviderTimeoutError
ProviderUnavailableError
解决过程
我们可以再包一层:
class FallbackProvider(LLMProvider):

    def __init__(
        self,
        providers: list[LLMProvider],
    ):
        self.providers = providers

    def chat(
        self,
        messages,
        tools=None,
    ):
        errors = []

        for provider in self.providers:
            try:
                return provider.chat(
                    messages,
                    tools
                )
            except ProviderError as exc:
                errors.append(str(exc))

        raise ProviderError(
            "所有 Provider 均失败:"
            + " | ".join(errors)
        )
Agent Engine 仍然:
response = provider.chat(...)它甚至不知道发生了 Fallback。
输出结果
架构:
Agent Engine
 ↓
FallbackProvider
 ├─ OpenAIProvider
 ├─ ClaudeProvider
 └─ LocalModelProvider
统一接口让回退策略有了安放位置,但“可以换”不等于“任意错误都该换”。下面这条路径区分了暂时不可用、鉴权失败与候选模型能力不足三种情况。
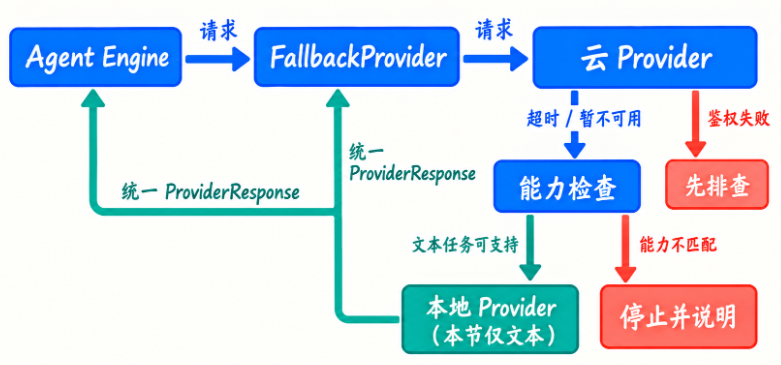
例如本节本地示例只实现文本调用:任务若依赖 Tool Calling,就不能在云端出错后无条件切过去。上面的简化 FallbackProvider 代码示范的是组合结构;真正投入使用时还要细分可回退错误、检查能力与请求副作用,并谨慎处理重复调用成本。
复盘与迁移
一旦统一 Provider Interface 建立起来,后面的:
Fallback
Model Router
Cost Router
A/B Test
灰度
都会变得自然。
这就是好抽象的价值,它不是让当前代码更“高级”,而是让未来变化只发生在应该变化的地方。
常见误区
误解: Provider 就是把 SDK 调用包进一个类,多一层反而更麻烦。
正解: 如果系统永远只有一个模型、一个调用点,确实看不出价值。但 Agent 会不断增加 Tool Calling、Tracing、Retry、Fallback、Streaming、Usage 统计,不同厂商在这些能力上的输入输出都可能不同。Provider 层真正隔离的是变化,让 Agent Engine 不必理解每一家 SDK 的细节,而不是为了形式主义多写一个类。
误解: 统一 Provider 就应该把所有模型参数都统一。
正解: 过度统一会产生巨型接口。不同模型的参数和能力不完全一致,真正应该统一的是 Agent 依赖的公共能力,例如 messages、tools、标准响应、标准错误。厂商专属参数更适合保留在 Provider Config 或 Provider 内部。抽象的目标不是抹平世界差异,而是挡住不该泄漏到上层的差异。
误解: ProviderResponse 直接返回原厂 SDK Response 最省事。
正解: 这样看似少写代码,实际上 Agent Engine 会开始读取具体厂商字段,抽象立刻被打穿。更稳的做法是映射成我们自己的 ProviderResponse,例如统一 text、tool_calls、usage。原始对象可以放在 raw 里做调试,但核心逻辑不能依赖 raw。
误解: Provider 可以顺便负责 Tool 执行,因为 Tool Call 也是模型返回的。
正解: Provider 负责把模型的 Tool Call 翻译成统一 ToolRequest,但真正执行 Tool 应该属于 Agent Harness / Tool Executor。否则 Provider 会同时承担模型通信和外部执行两种职责,后面的权限、Middleware、Human Approval 很难统一插入。模型通信和真实动作必须保持边界。
误解: 只要能切模型,就说明解耦做好了。
正解: 真正的解耦还包括异常、响应、Usage、Tool Call 等语义是否统一。如果每次切 Provider 后,Agent Engine 还要写 if provider_name == ...,说明具体实现仍然泄漏到了上层。理想状态是 Agent Engine 只面向接口编程,Provider 更换后核心控制流不改。
误解: 本地模型和云模型完全一样,只改 URL 就行。
正解: 本地模型可能在 Tool Calling、Context、Structured Output、速度、并发、模型加载方式等方面和云模型不同。Provider 可以统一公共接口,但不能假装能力差异不存在。更成熟的设计还会给 Provider 增加 capability 描述,让 Agent 在调用前知道当前模型是否支持某种能力。
















请登录后查看评论内容