

场景背景
假设团队已经有一个 Coding Agent。
Main Loop:
THINKING
 ↓
LLM
 ↓
TOOL_CALLING
 ↓
OBSERVING
 ↓
THINKING
第一版底层使用 OpenAI。
某一天,团队希望在代码分析任务中测试 Claude。
问题矛盾
如果 Main Loop 直接依赖具体 SDK,切换模型意味着:
- 改 import;
- 改 client;
- 改请求参数;
- 改 response 解析;
- 改异常处理;
- 重新测试 Agent Loop。
这很危险。
因为你只是换模型,却动了核心控制逻辑。
前置条件
假设 Engine 只依赖:
LLMProvider接口:
chat(messages, tools=None)输出:
ProviderResponse解决过程
原来配置:
LLM_PROVIDER=openai创建:
provider = OpenAIProvider(...)切换后:
LLM_PROVIDER=anthropic创建:
provider = ClaudeProvider(...)Agent Engine:
response = self.provider.chat(
    state.messages,
    tools
)
完全不变。
输出结果
团队可以做 A/B:
同一批 100 个 Coding Tasks
 ↓
OpenAIProvider
ClaudeProvider
 ↓
比较成功率、平均 Step、Token、成本
而不是维护两个 Agent。
这个对照实验的控制变量不是模型回答,而是任务集与 Agent Engine。两条分支共用同一套 Main Loop,只替换 Provider,才能更清楚地比较模型差异。
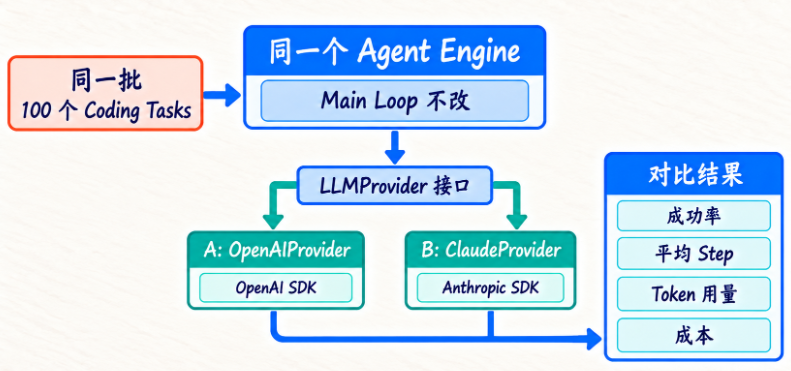
图中只列出成功率、平均 Step、Token 用量和成本这四个观察维度,没有预设哪家更优;统计时还需保证指标口径一致,并把缺失的 Usage 与真实零用量分开。
复盘与迁移
这个案例最重要的不是“OpenAI 和 Claude 谁更好”。
而是,模型是可替换依赖,Agent Engine 才是我们的业务核心。
以后你接:
云模型
本地模型
公司内部模型网关
都应该尽量变成新的 Provider,而不是新的 Agent Engine。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容