

现在我们把前面几节串起来。
Agent Engine 已经有:
Main Loop
State
Provider
理想结构是:
class AgentEngine:

    def __init__(
        self,
        provider: LLMProvider,
    ):
        self.provider = provider

    def run(...):
        ...
        response = self.provider.chat(...)
Engine 不知道:
OpenAI
Anthropic
Ollama
它只知道:
LLMProvider一个完整可运行的 Agent Engine Demo
下面我们用三个 Fake Provider,避免任何外部 API 依赖,专门验证,切 Provider,Agent Engine 一行都不用改。
最重要的是:
class AgentEngine完全没有:
if openai:也没有:
if claude:这才叫真正解耦。
Provider Factory 进一步隐藏创建逻辑
Agent Engine 甚至不需要知道怎么 new Provider。
可以有:
def create_provider(name: str) -> LLMProvider:
    ...
配置层决定:
LLM_PROVIDER=openai服务启动时创建对应实例。
这样 Flask 层也不用到处判断。
从配置到运行的这条路径可以概括为:读取 LLM_PROVIDER,Factory 创建对应实例,再把它作为同一 LLMProvider 合同交给 Engine。对单次运行来说只选一个实例,不是把三家同时调用一遍。
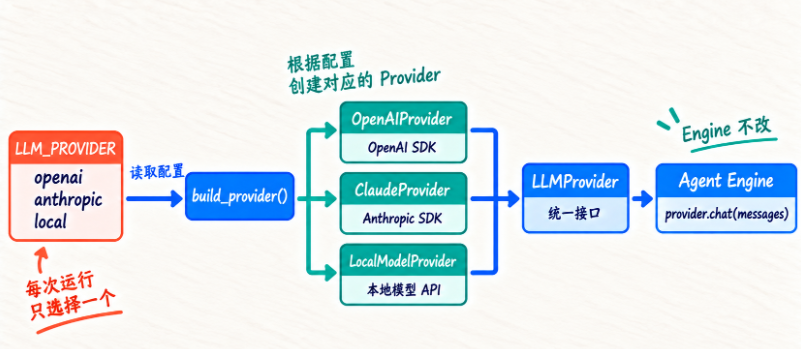
以后增加第四家模型,通常应先新增适配器与配置分支,再验证它的响应、异常与能力合同;Main Loop 中不需要再添一个 if provider_name。
解耦以后最直接的五个收益
第一,切模型容易。
最直观。
第二,测试容易。
单元测试完全可以用:
FakeProvider不需要每次烧真实 API。
第三,Fallback 容易。
以后可以:
OpenAI 失败
 ↓
Claude
 ↓
Local第四,Tracing 容易统一。
因为所有模型都经过:
provider.chat()这里天然是统一观测点。
第五,成本路由更容易。
后面可以按任务:
简单任务 → 小模型
复杂任务 → 强模型
敏感任务 → 本地模型
Agent Engine 不需要改。
但 Provider 抽象也不能过度
这里也提醒一下。
不要为了“以后可能支持 20 家模型”一开始设计 50 个接口。
现在最重要的是:
chat()
统一 response
统一 error
等 Tool Calling 真正出现,再扩展 ToolRequest。
等 Streaming 出现,再设计:
stream_chat()课程里我们一直坚持,让抽象跟着真实需求长。
而不是先造一个巨型框架,再找问题去套。
先验证适配器承诺了哪些能力
我们设计统一 Provider,是为了让 Engine 使用稳定的输入输出合同。不同服务在工具调用格式、消息角色、usage 和错误返回上仍有差别,适配器需要把这些差别处理完整。工具调用 ID 应从原响应保存下来,并在工具结果返回时继续使用;不能只保留工具名和参数。
能力声明也需要有对应入口。声明支持 Structured Output,就应该允许调用方提交输出 Schema,并验证或处理不符合格式的响应;声明支持 Streaming,就应有事件读取与中断行为。配套 OpenAI-compatible 适配器目前提供同步请求、工具与 usage 的基本映射,不能仅凭一个布尔字段视为已实现所有能力。Anthropic 原生适配和本地端点的兼容验证也要分别完成。
遇到没有 usage 的响应,我们应该标记“未知”或“估算”,而不是把零当作实际用量。接口限流、超时、鉴权失败则需要映射为可识别错误,让上层决定是否重试。更换 Provider 能否不改 Engine,取决于这些合同是否被完整履行。
配套实现目前保留了教学阶段的最小边界:CallableProvider 方便注入离线函数,OpenAICompatibleProvider 使用标准库 HTTP 完成同步文本、Tool Call 与 Usage 的基础映射。它会校验响应根结构、Tool Arguments、Usage 和远程 HTTPS 地址,并把传输失败与响应合同错误分开;它没有发送结构化输出参数,因此能力声明明确保持 structured_output=False。这里宁可少声明一项,也不要让 Main Loop 根据一个并不存在的能力安排执行路径。正文中的 ClaudeProvider、LocalModelProvider 和更完整的重试策略展示的是继续扩展时的做法,并不表示源码包已经为每一家服务提供了完整适配;自动重试还可能重复产生模型费用,不能看到 429 或超时就无条件重放。
同样需要留意,配套 ProviderResponse 目前用整数 0 表示未取得 Token 数据,这是为了让前几节的数据结构保持简单。进入真实计费和监控场景后,应增加“是否实际返回”或“是否估算”的标识,避免把未知用量展示成真实零消耗。
不连接外部模型,也可以先运行第 02 个阶段项目,验证 Provider 接口确实可以替换:
cd agent_harness_course_projects
python3 projects/02_llm_provider/main.py
输出会告诉我们 Provider 收到了多少条消息,并展示统一的 ProviderResponse。这一步检查的是抽象合同,不是模型回答质量。先把离线链路跑稳,再接 API Key,出问题时更容易判断是 Provider 适配还是 Agent Engine 的问题。
接下来可以做第一次真实模型实验。配套项目已经提供 DeepSeek 适配入口,Key 只放在当前终端环境变量中:
export DEEPSEEK_API_KEY='替换为自己的 Key'
export DEEPSEEK_MODEL='deepseek-flash'  # 可省略,课程默认值
python3 projects/02_llm_provider/deepseek_demo.py
运行后不要只看回答是否顺眼,还要看返回的模型名和 Token Usage。我们在这一节接真实模型,是为了确认 Provider 合同经得住网络响应,而不是从这里开始让后续测试全部依赖 API。
课程使用 DeepSeek 的 OpenAI-compatible /chat/completions 接口,当前默认模型为 deepseek-flash。DeepSeek 也提供 Responses API,但它的输入输出信封和 Tool Result 回传方式属于另一套 Provider 合同;不要只替换 URL 就假设完全兼容。若要教学 Responses API,应新增独立 Adapter 和协议测试,而不是把两种格式混进同一个实现。模型名称和接口能力可能随服务升级调整,实际使用前应以 DeepSeek 官方文档为准。
动手做一组协议检查
准备三个模拟响应:普通文本、含两次工具调用的响应、缺少 usage 的响应。参考验收是:内容正确转换、两个调用的标识分别保留、缺失 usage 不伪装成真实零用量。再用模拟传输检查下一次请求包含完整历史。这样我们先验证适配逻辑,再决定是否进行真实网络联调。
三组模拟响应各自检验一条独立合同,放在一起看也能避免“只测文本能出字,就以为 Provider 已经接好”的错觉。
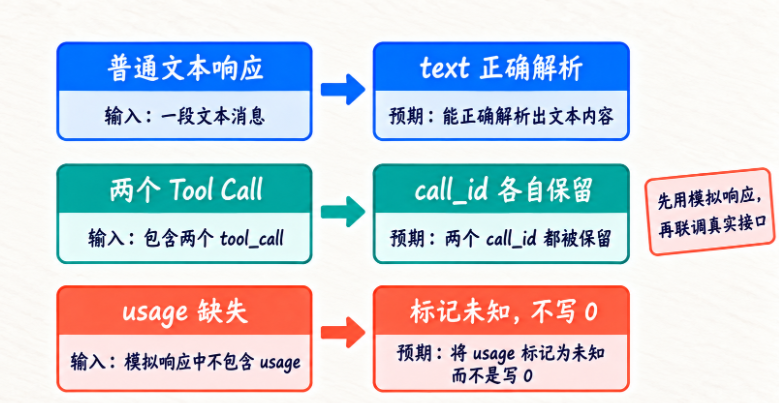
其中第二组要保留两个不同的调用 ID,第三组则要区分“接口没有报告用量”和“真实用量恰好为零”;这些细节会直接影响下一轮工具结果配对和成本观测。
















请登录后查看评论内容