



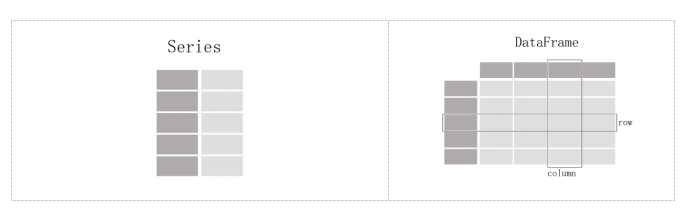
3.1.2了解 Pandas 核心数据结构:Series 和 DataFrame
Pandas 基于 Numpy,并提供了 2 大核心数据结构: Series:一维带有标签的数组 DataFrame:二维表格结构,可看作多个 Series 的组合 用得最多的pandas对象是Series,一个一维的标签...
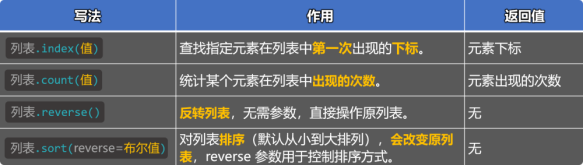
2.5. 列表的常用方法
除了增删改查方法,列表中还有很多其他常用的方法: 1️⃣使用:列表.index(值),查找指定元素在列表中第一次出现的下标,返回值是元素下标。 fruits = ['香蕉', '苹果', '橙子', '香蕉'] r...
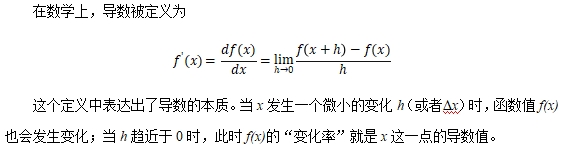
3.2 数值微分
损失函数的值越小,代表我们选取的参数越适合;想要求得损失函数的最小值,最基本的想法就是对函数求导,解出导数值为0的点,并判断它是否为极小值/最小值。 然而,实际的函数直接求导,不容易...
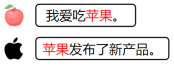
3.3.4 上下文相关词表示
虽然像Word2Vec这样的模型已经能够为词语提供具有语义的向量表示,但是它只为每个词分配一个固定的向量表示,不论它在句中出现的语境如何。这种表示被称为静态词向量(static embeddings)。 然...
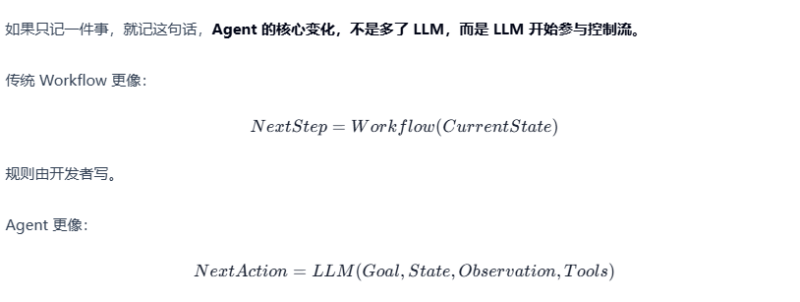
小节三:Agent——真正的变化,是“下一步由谁决定”
现在我们正式进入 Agent。 先看一个最短版本: 当前状态 ↓ LLM 判断下一步做什么 ↓ Action ↓ 执行 ↓ Observation ↓ 再次判断 这里有四个关键输入。 Goal:最终要完成什么。 State:现在执...

14. 类型注解 vs 函数类型注解
类型注解不会影响程序运行,它只是给人和工具看的,它可以提高代码可读性、让 IDE 智能提示更强 。 14.1. 变量类型注解 语法格式:变量名: 类型 = 值。 num: int = 100 prcie: float = 12.5 mes...
章末自测
题目 1:为什么 README.md、app.py、requirements.txt、config.py 通常适合并行读取? 请从数据依赖、副作用和共享资源三个角度分析,同时说明什么情况下即使都是 read_file,也不应该无限并发...
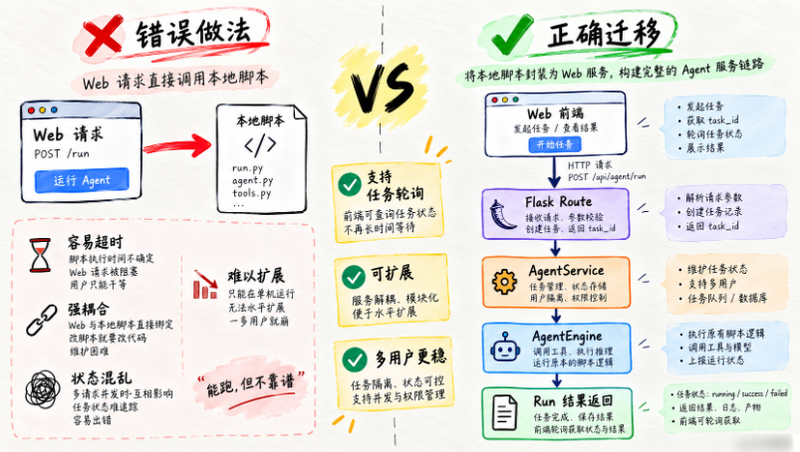
案例分析一:Coding Agent 从本地脚本迁移成 Web 产品
这个案例最适合直接看对比图。左边是错误做法:Web 请求直接去调本地脚本,能跑,但会带来超时、强耦合、状态混乱和难扩展的问题;右边则是正确迁移方式:前端调用 Flask Route,再到 AgentServ...
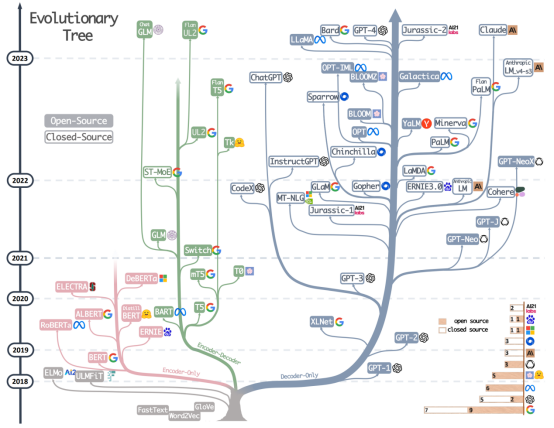
第 8 章 预训练模型
8.1 预训练模型概述 早期的自然语言处理方法通常针对每个具体任务单独训练模型,且严重依赖大量人工标注数据。虽然在部分场景下效果可观,但也暴露出显著局限: 语言知识难以复用:每个模型都需...
小节一:为什么 Agent 比普通 API 更需要 Streaming——长执行、多步骤、状态变化决定了它不能只返回最终结果
普通 CRUD API 通常很快。 例如: GET /users/123 几十毫秒到几百毫秒。 用户不太需要知道: 数据库查到第几步 序列化做到哪里 但 Agent 完全不同。 Agent 的执行本身就是一个过程 一个任务可能...

