

8.1 预训练模型概述
早期的自然语言处理方法通常针对每个具体任务单独训练模型,且严重依赖大量人工标注数据。虽然在部分场景下效果可观,但也暴露出显著局限:
- 语言知识难以复用:每个模型都需从零开始训练,导致训练成本高、效率低;
- 强依赖高质量标注:在医疗、法律等专业领域,标注数据获取困难且代价高昂。
为解决这些问题,研究者提出了新的建模范式——“预训练 + 微调”:
- 预训练阶段:在大规模未标注语料上训练语言模型,学习词汇、句法和上下文等通用语言规律;
- 微调阶段:将预训练模型迁移至具体任务,仅需少量标注数据即可完成任务适配。
这一方法显著提升了模型的通用性和开发效率,已成为当前 NLP 的主流技术路线,并广泛应用于文本分类、问答系统、翻译、对话等任务中。
8.2 预训练模型分类
预训练语言模型几乎都构建在 Transformer 架构之上。相较于传统的循环神经网络,Transformer具有以下优势:
- 并行计算效率高,适合大规模训练;
- 上下文建模能力强,可捕捉长距离依赖;
- 结构通用灵活,可适配多种任务类型;
- 易于扩展与迁移,支持参数堆叠与多任务学习。
因此,Transformer 成为预训练模型的主流基础架构。根据 Transformer 的使用方式不同,预训练模型大致可分为以下三类:
1)解码器(Decoder-only)模型
仅使用Transformer解码器,代表模型为GPT(Generative Pre-trained Transformer),其由 OpenAI于2018年6月提出,论文题为《Improving Language Understanding by Generative Pre-Training》。
2)编码器(Encoder-only)模型
仅使用Transformer 编码器,代表模型为BERT(Bidirectional Encoder Representations from Transformers),由Google于2018年10月提出,论文题为《BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding》。
3)编码器-解码器(Encoder-Decoder)模型
同时使用Transformer编码器和解码器,代表模型为T5(Text-to-Text Transfer Transformer),由Google于2019年10月提出,论文题为《Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer》。
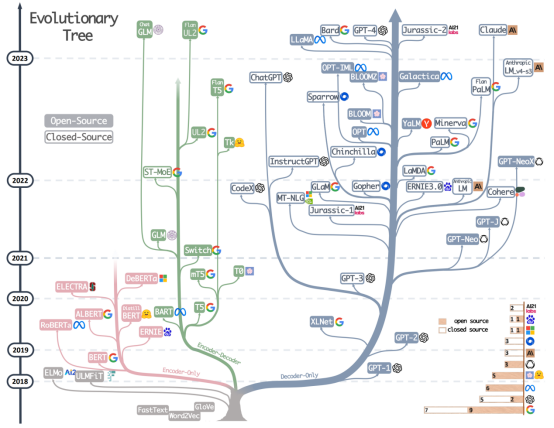
自GPT、BERT和T5等模型发布以来,基于Transformer的预训练模型不断涌现,模型架构和能力持续演进。下图总结了2018
年至2023年间具有代表性的模型及其发展脉络。











请登录后查看评论内容