

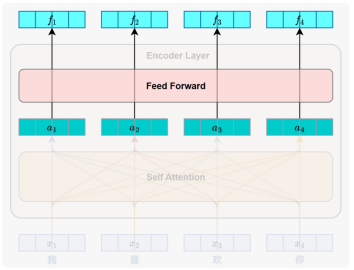
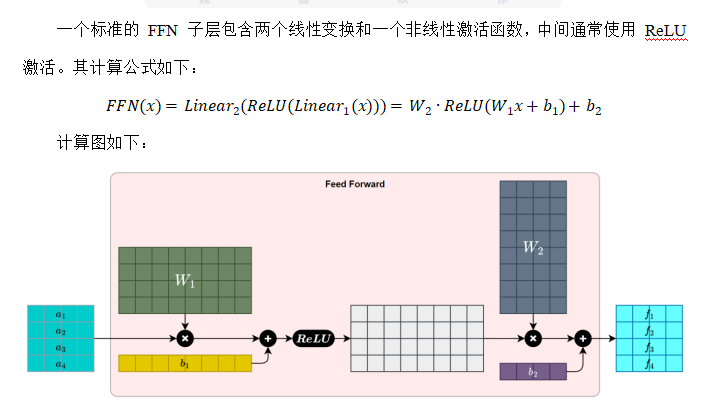
前馈神经网络(Feed-Forward Network,简称FFN)是Transformer编码器中每个子层的重要组成部分,紧接在多头注意力子层之后。它通过对每个位置的表示进行逐位置、非线性的特征变换,进一步提升模型对复杂语义的建模能力。
7.2.3.4 残差连接与层归一化
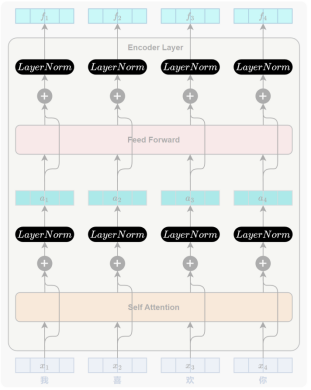
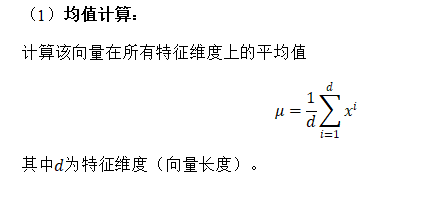
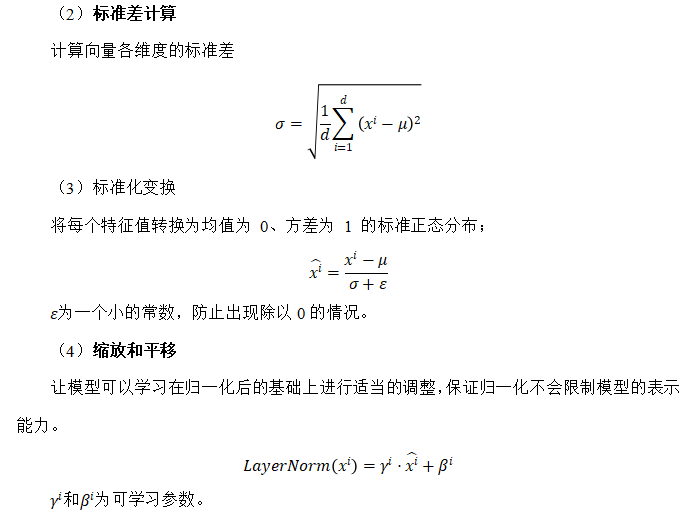
在Transformer的每个编码器层中,每个子层,包括自注意力子层和前馈神经网络子层,其输出都要经过残差连接(Residual Connection)和层归一化(Layer Normalization)处理。这两者是深层神经网络中常用的结构,用于缓解模型训练中的梯度消失、收敛困难等问题,对于Transformer能够堆叠多层至关重要。
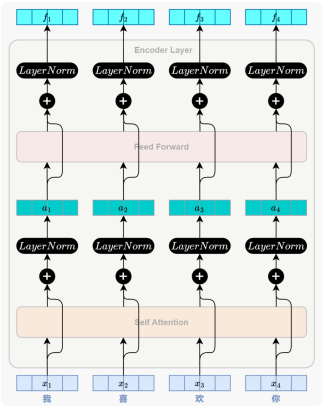
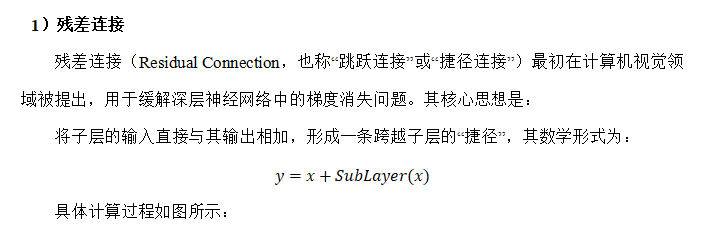
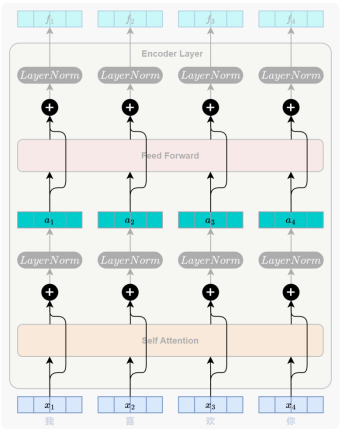
残差连接确保反向传播时,梯度至少有一条稳定通路可回传,是深层网络可稳定训练的关键结构。
7.2.3.5 位置编码
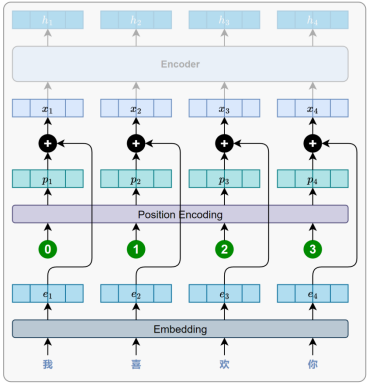
Transformer 模型完全摒弃了 RNN 结构,意味着它不再按顺序处理序列,而是可以并行处理所有位置的信息。尽管这带来了显著的计算效率提升,却也引发了一个问题:Transformer 无法像 RNN 那样天然地捕捉词语之间的顺序关系。换句话说,在没有额外机制的情况下,Transformer 无法区分“猫吃鱼”和“鱼吃猫”这类语序不同但词汇相同的句子。
为了解决这一问题,Transformer 引入了一个关键机制——位置编码(Positional Encoding)。该机制为每个词引入一个表示其位置信息的向量,并将其与对应的词向量相加,作为模型输入的一部分。这样一来,模型在处理每个词时,既能获取词义信息,也能感知其在句子中的位置,从而具备对基本语序的理解能力。
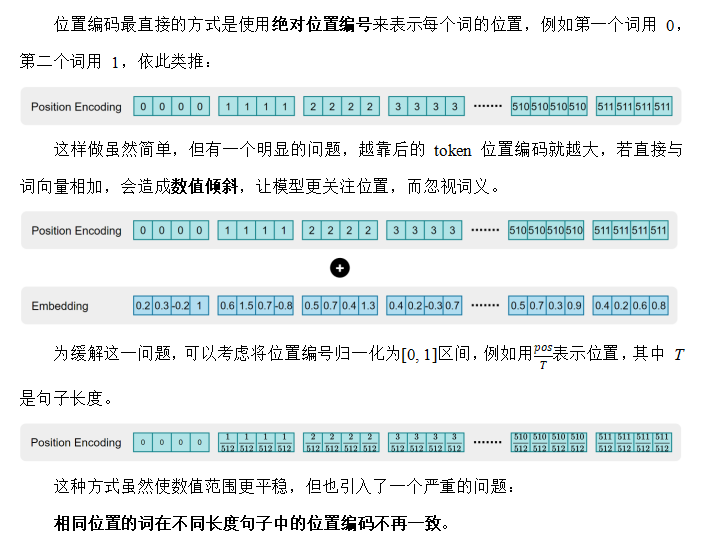
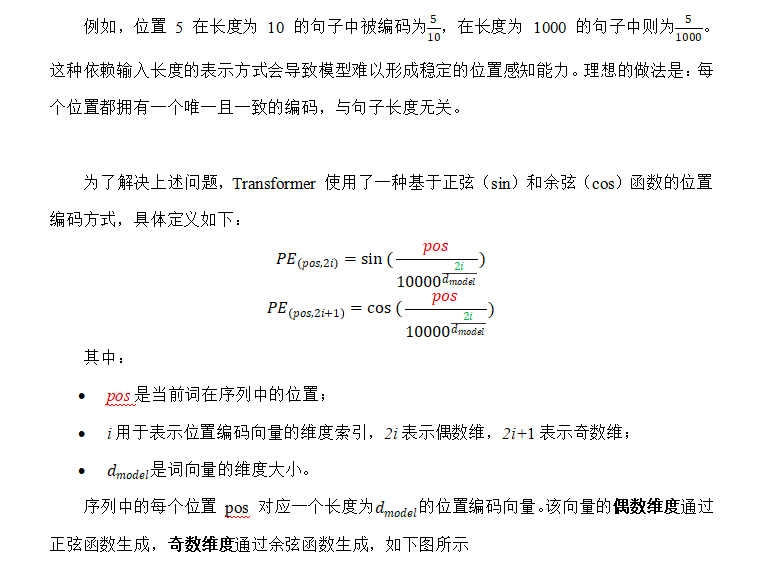
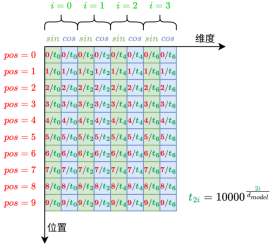
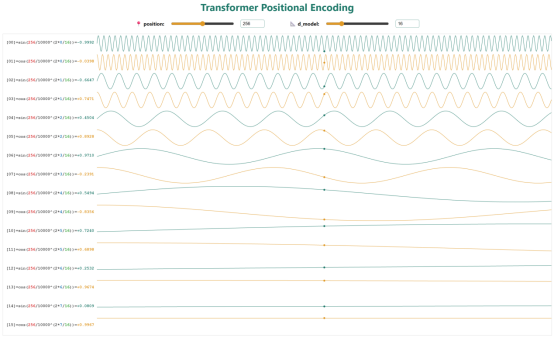
Transformer提出的这种编码方式不依赖任何可学习参数,数值稳定,并具备以下优势:
- 所有值都在[−1,1]范围内,数值稳定
- 编码方式固定、可预计算,无需训练;
- 相同位置的编码在不同句子中保持一致;
- 编码之间具有数学规律,便于模型在注意力机制中感知词语之间的相对位置关系。
7.2.3.6 小结
Transformer 编码器通过多个结构一致的编码器层堆叠构成,每一层由两个核心子层组成:
- 自注意力子层(Self-Attention):
通过 Query、Key、Value 向量机制计算全序列中各位置之间的相关性,提取全局上下文信息,使每个词的表示能够融合整个序列的信息。
- 前馈神经网络子层(Feed-Forward Network):
对每个位置独立进行非线性特征变换,增强模型的表示能力。
另外,在这两个子层之后,Transformer 引入了两个关键结构:
- 残差连接(Residual Connection):缓解深层网络中的梯度消失问题;
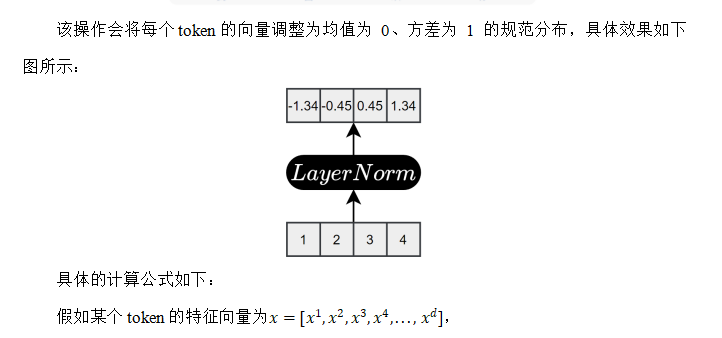
- 层归一化(Layer Normalization):规范向量分布,提升训练稳定性。
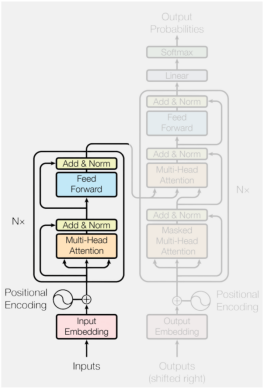
最后,为弥补模型并行结构下缺乏顺序感的缺陷,Transformer 使用基于正余弦函数的位置编码来提供序列中每个词的位置信息。
编码器的完整结构如下图所示:











请登录后查看评论内容