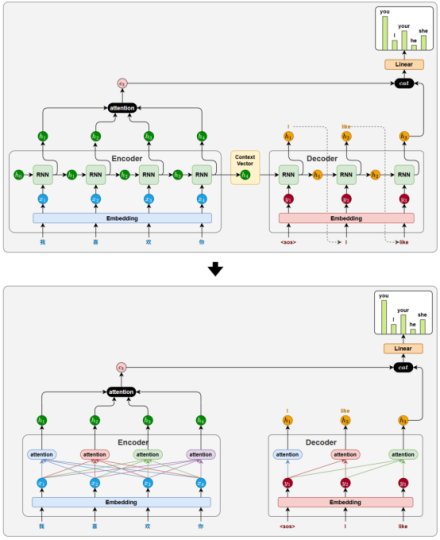


7.1 概述
此前的Seq2Seq模型通过注意力机制取得了一定提升,但由于整体结构仍依赖 RNN,依然存在计算效率低、难以建模长距离依赖等结构性限制。
为了解决这些问题,Google在2017 年发表一篇论文《Attention Is All You Need》,提出了一种全新的模型架构——Transformer。该模型完全摒弃了 RNN 结构,转而使用注意力机制直接建模序列中各位置之间的关系。通过这种方式,Transformer不仅显著提升了训练效率,也增强了模型对长距离依赖的建模能力。
Transformer 的提出对自然语言处理产生了深远影响。在机器翻译任务中,它首次超越了 RNN 模型的表现,并成为后续各类预训练语言模型的基础框架,如 BERT、GPT 等。这些模型推动 NLP 进入了“预训练 + 微调”的新时代,极大地提升了模型在多种任务上的通用性与性能。如今,Transformer 架构不仅广泛应用于 NLP,还扩展至语音识别、图像处理、代码生成等多个领域,成为现代深度学习中最具代表性的通用模型之一。
7.2 模型结构详解
7.2.1 核心思想
在 Seq2Seq 模型中,注意力机制的引入显著增强了模型的表达能力。它允许解码器在生成每一个目标词时,根据当前解码状态动态选择源序列中最相关的位置,并据此融合信息。这一机制有效缓解了将整句信息压缩为固定向量所带来的信息瓶颈,显著提升了翻译等任务中的建模效果。
进一步分析可以发现,注意力机制不仅是信息提取的工具,其本质是在每一个目标位置上,显式建模该位置与源序列中各位置之间的依赖关系。
与此同时,循环神经网络(RNN)作为 Seq2Seq 模型的核心结构,其作用也在于建模序列中的依赖关系。通过隐藏状态的递归传递,RNN 使当前位置的表示能够整合前文信息,从而隐式捕捉上下文依赖。从功能角度看,RNN 与注意力机制完成的是同一类任务:建立序列中不同位置之间的依赖联系。
既然注意力机制也具备建模依赖关系的能力,那么理论上,它就可以在功能上替代 RNN。
此外,相比 RNN,注意力机制在结构上具备明显优势:无需顺序计算,便于并行处理;任意位置间可直接建立联系,更适合捕捉长距离依赖。因此,它不仅具备替代的可能,也在效率与效果上表现更优。
既然如此,是否可以将 Seq2Seq 中的 RNN 结构全部替换为注意力机制呢?
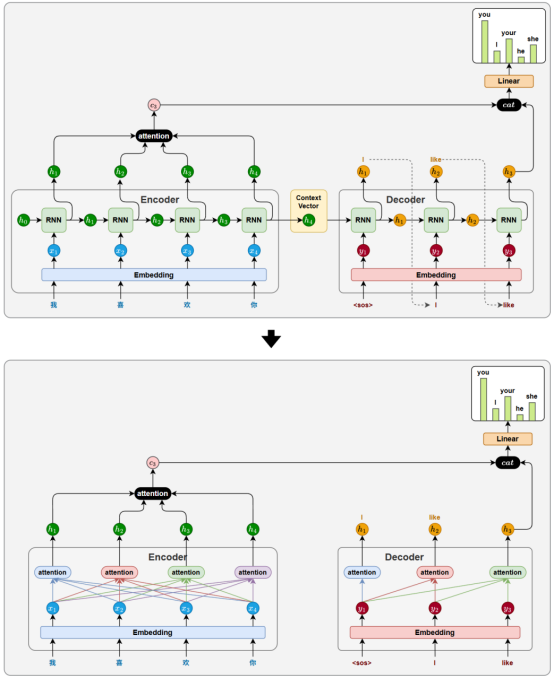
Transformer模型正是在这一思路下诞生的。它摒弃了传统的循环结构,仅依靠注意力机制完成输入序列和输出序列中所有位置之间的依赖建模任务。这一结构上的彻底变革,也正是论文标题Attention is All You Need所体现的核心理念。
7.2.2 整体结构
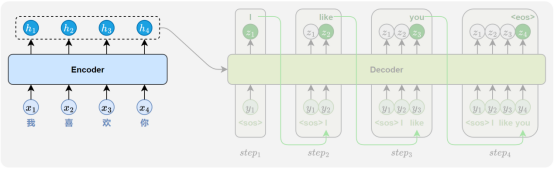
Transformer 的整体结构延续了 Seq2Seq 模型中 “编码器-解码器” 的设计理念,其中,编码器(Encoder)负责对输入序列进行理解和表示,而解码器(Decoder)则根据编码器的输出逐步生成目标序列。
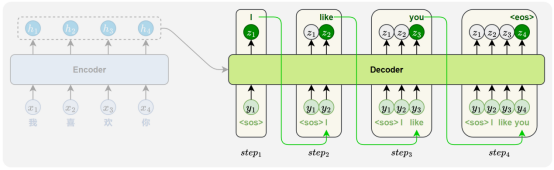
与基于 RNN 的 Seq2Seq 模型一样,Transformer 的解码器采用自回归方式生成目标序列。不同之处在于,每一步的输入是此前已生成的全部词,模型会输出一个与输入长度相同的序列,但我们只取最后一个位置的结果作为当前预测。这个过程不断重复,直到生成结束标记 <eos>。
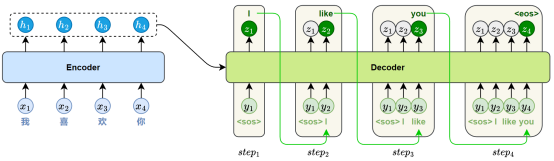
此外,
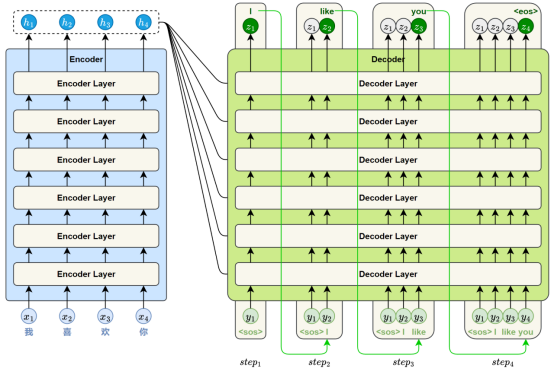
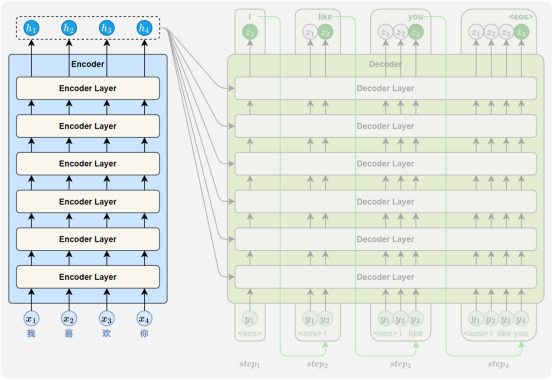
Transformer 的编码器和解码器模块分别由多个结构相同的层堆叠而成。通过层层堆叠,模型能够逐步提取更深层次的语义特征,从而增强对复杂语言现象的建模能力。标准的Transformer模型通常包含6个编码器层和 6 个解码器层。
7.2.3 编码器
7.2.3.1 概述
Transformer 的编码器用于理解输入序列的语义信息,并生成每个token的上下文表示,为解码器生成目标序列提供基础。
编码器由多个结构相同的编码器层(Encoder Layer)堆叠而成。
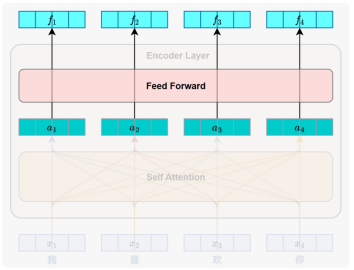
每个Encoder Layer的主要任务都是对其输入序列进行上下文建模,使每个位置的表示都能融合来自整个序列的全局信息。每个
Encoder Layer都包含两个子层(sublayer),分别是自注意力子层(Self-Attention Sublayer)和前馈神经网络子层(Feed-Forward Sublayer)。
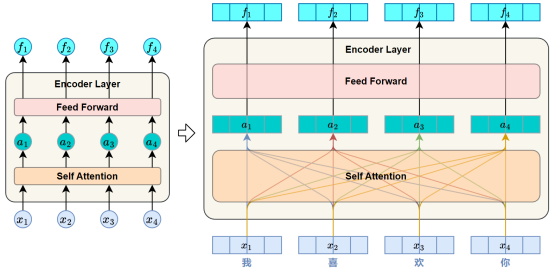
各层作用如下:
- Self-Attention
用于捕捉序列中各位置之间的依赖关系。
- Feed-Forward
用于对每个位置的表示进行非线性变换,从而提升模型的表达能力。
7.2.3.2 自注意力层
自注意力机制(Self-Attention)是Transformer编码器的核心结构之一,它的作用是在序列内部建立各位置之间的依赖关系,使模型能够为每个位置生成融合全局信息的表示。
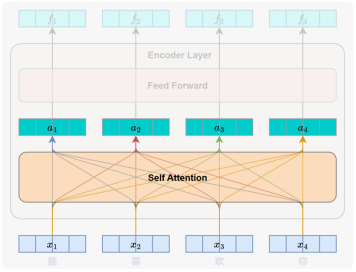
之所以被称为“自”注意力,是因为模型在计算每个位置的表示时,所参考的信息全部来自同一个输入序列本身,而不是来自另一个序列。
- 自注意力计算过程
自注意力的完整计算过程如下:
- 生成Query、Key、Value向量
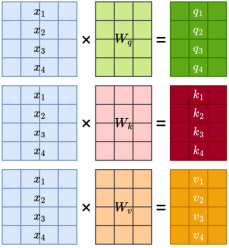
自注意力机制的第一步,是将输入序列中的每个位置表示映射为三个不同的向量,分别是 查询(Query)、键(Key) 和 值(Value)。
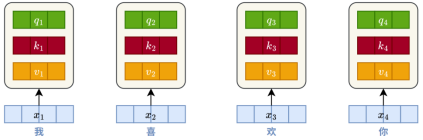
这些向量的作用如下:
Query:表示当前词的用于发起注意力匹配的向量;
Key:表示序列中每个位置的内容标识,用于与 Query 进行匹配;
Value:表示该位置携带的信息,用于加权汇总得到新的表示。
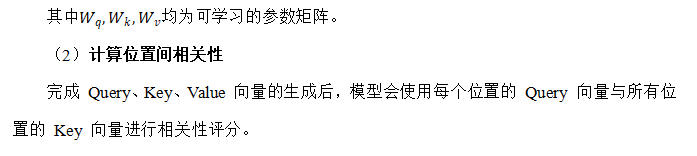
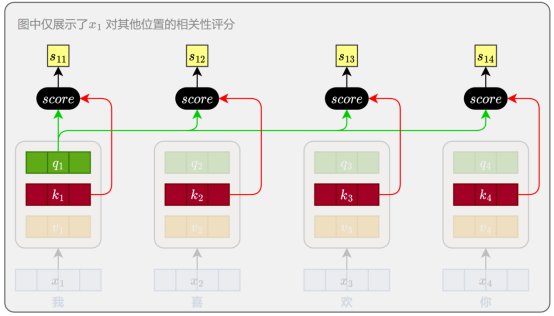
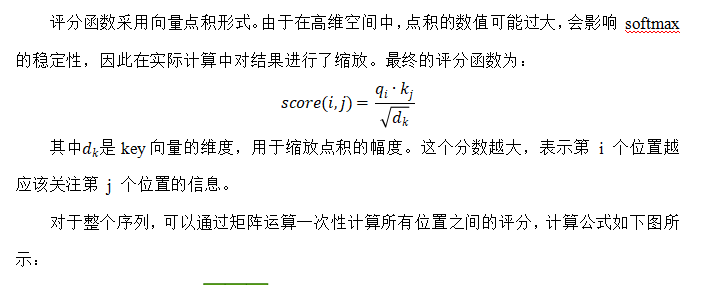
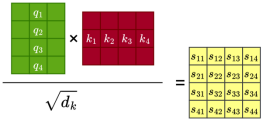
自注意力的核心思想是:每个位置用自身的 Query 向量,与整个序列中所有位置的 Key 向量进行相关性计算,从而得到注意力权重,并据此对对应的 Value 向量加权汇总,形成新的表示。
三个向量的计算公式如下:
(3)计算注意力权重
在得到每个位置与所有位置之间的相关性评分后,模型会使用 softmax 函数进行归一化,确保每个位置对所有位置的关注程度之和为 1,从而形成一个有效的加权分布。
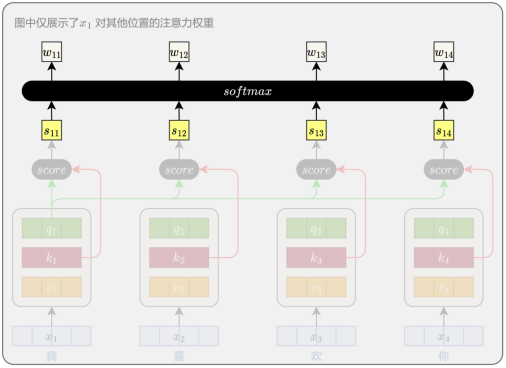
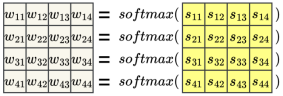
对于整个序列,模型要做的是对之前得到的注意力评分矩阵的每一行进行softmax归一化。
(4)加权汇总生成输出
最后,模型会根据注意力权重对所有位置的 Value 向量进行加权求和,得到每个位置融合全局信息后的新表示。
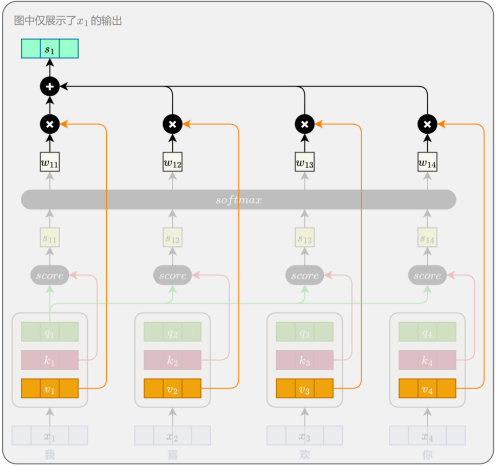
对于整个序列,同样可以通过矩阵运算一次性计算所有位置的输出,如下图所示
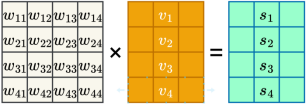
综上所述,可得整个自注意力机制的完整的计算公式如下
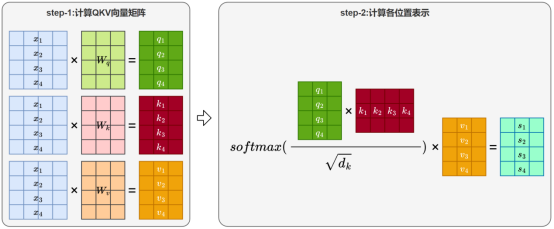
对应原始论文中的:
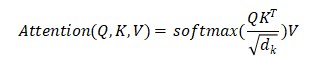
2)多头自注意力计算过程
自注意力机制通过 Query、Key 和 Value 向量计算每个位置与其他位置之间的依赖关系,使模型能够有效捕捉序列中的全局信息。
然而,自然语言本身具有高度的语义复杂性,一个句子往往同时包含多种类型的语义关系。例如,句子“那只动物没有过马路,因为它太累了”中就涉及多个层面的语言关系:
- “它”指代“那只动物”,属于跨句的代指关系;
- “因为”连接前后两个分句,体现语义上的因果逻辑;
- “过马路”构成动词短语,属于固定的动宾结构。
要准确理解这类句子,模型需要同时识别并建模多种层次和类型的依赖关系。但这些信息很难通过单一视角或一套注意力机制完整捕捉。
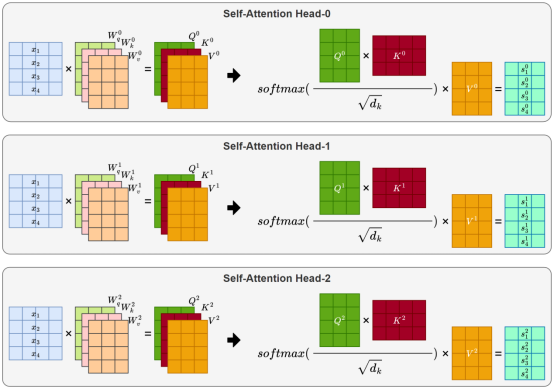
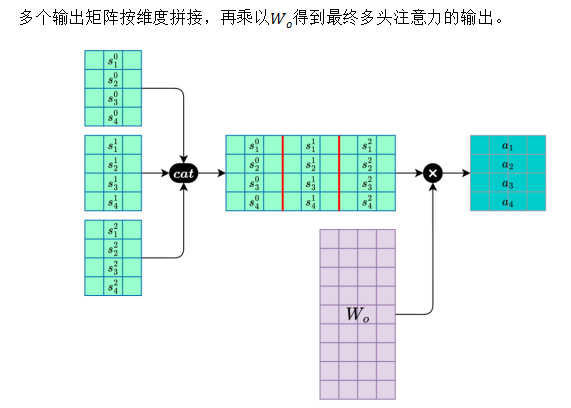
为此,Transformer 引入了多头注意力机制(Multi-Head Attention)。其核心思想是通过多组独立的 Query、Key、Value 投影,让不同注意力头分别专注于不同的语义关系,最后将各头的输出拼接融合。
多头注意力的计算过程如下:
(1)分别计算各头注意力
每个 Self-Attention Head 独立计算一套注意力输出。
(2)合并多头注意力











请登录后查看评论内容