

6.4.1 需求说明
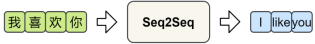
本案例要求在已有的Seq2Seq 模型基础上,引入注意力机制,以提升模型在处理长句或复杂句时的表达能力和生成质量。
6.4.2 需求分析
为引入Attention机制,模型结构做出如下改变:
- 编码器
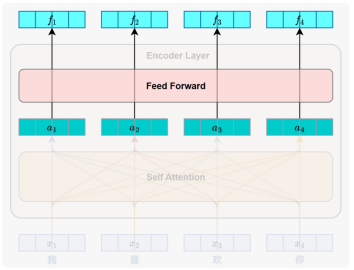
编码器无需任何改变。
- 解码器
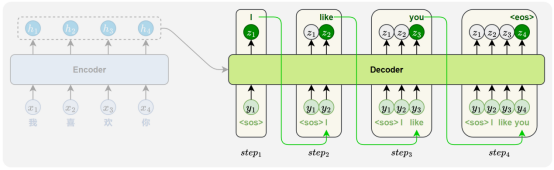
解码器在每个时间步,都需要将当前隐藏状态与编码器输出序列共同用于计算注意力权重(使用点积评分函数);之后根据权重对编码器各位置进行加权求和,得到上下文向量;最后再将上下文向量与当前解码状态拼接,作为输出的最终依据。
6.4.3 需求实现
1)项目结构
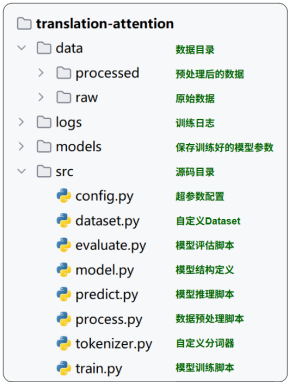
2)完整代码
(1)数据预处理
# process.py

import pandas as pd
from sklearn.model_selection import train_test_split
from tokenizer import ChineseTokenizer, EnglishTokenizer
import config

def process():
    """
    数据预处理主函数。
    """
    print('开始处理数据')

    # 读取中英文对齐数据
    df = pd.read_csv(
        config.RAW_DATA_DIR / 'cmn.txt',
        sep='\t',
        header=None,
        usecols=[0, 1],
        names=['en', 'zh']
    )

    # 清理空值数据
    df = df.dropna()
    df = df[df['en'].str.strip().ne('') & df['zh'].str.strip().ne('')]

    # 划分训练集和测试集
    train_df, test_df = train_test_split(df, test_size=0.2, random_state=42)

    # 构建词表
    EnglishTokenizer.build_vocab(train_df['en'].tolist(), config.PROCESSED_DATA_DIR / 'en_vocab.txt')
    ChineseTokenizer.build_vocab(train_df['zh'].tolist(), config.PROCESSED_DATA_DIR / 'zh_vocab.txt')

    # 加载词表
    en_tokenizer = EnglishTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'en_vocab.txt')
    zh_tokenizer = ChineseTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'zh_vocab.txt')

    # 编码训练集
    train_df['en'] = train_df['en'].apply(
        lambda x: en_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=True)
    )
    train_df['zh'] = train_df['zh'].apply(
        lambda x: zh_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=False)
    )
    train_df.to_json(
        config.PROCESSED_DATA_DIR / 'indexed_train.jsonl',
        orient='records',
        lines=True
    )

    # 编码测试集
    test_df['en'] = test_df['en'].apply(
        lambda x: en_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=True)
    )
    test_df['zh'] = test_df['zh'].apply(
        lambda x: zh_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=False)
    )
    test_df.to_json(
        config.PROCESSED_DATA_DIR / 'indexed_test.jsonl',
        orient='records',
        lines=True
    )

    print('数据处理完成')

if __name__ == '__main__':
    process()
(2)自定义分词器
# tokenizer.py

from abc import abstractmethod
from nltk import word_tokenize, TreebankWordDetokenizer
from tqdm import tqdm

class BaseTokenizer:
    """
    分词器基类,提供词表构建、编码、解码等基础功能。
    """
    unk_token = '<unk>'
    pad_token = '<pad>'
    sos_token = '<sos>'
    eos_token = '<eos>'

    @staticmethod
    @abstractmethod
    def tokenize(sentence):
        """
        分词抽象方法。

        :param sentence: 输入句子。
        :return: 分词结果。
        """
        pass

    @abstractmethod
    def decode(self, indexes):
        """
        解码抽象方法。

        :param indexes: 索引列表。
        :return: 解码后的句子。
        """
        pass

    @classmethod
    def build_vocab(cls, sentences, vocab_file):
        """
        构建词表并保存。

        :param sentences: 句子列表。
        :param vocab_file: 保存词表文件路径。
        """
        unique_words = set()
        for sentence in tqdm(sentences, desc='分词'):
            for word in cls.tokenize(sentence):
                unique_words.add(word)

        vocab_list = [cls.pad_token, cls.unk_token, cls.sos_token, cls.eos_token] + list(unique_words)

        with open(vocab_file, 'w', encoding='utf-8') as f:
            for word in vocab_list:
                f.write(word + '\n')

    def __init__(self, vocab_list):
        """
        初始化分词器。

        :param vocab_list: 词表列表。
        """
        self.vocab_list = vocab_list
        self.vocab_size = len(vocab_list)
        self.word2index = {word: idx for idx, word in enumerate(vocab_list)}
        self.index2word = {idx: word for idx, word in enumerate(vocab_list)}
        self.unk_token_index = self.word2index[self.unk_token]
        self.pad_token_index = self.word2index[self.pad_token]
        self.sos_token_index = self.word2index[self.sos_token]
        self.eos_token_index = self.word2index[self.eos_token]

    @classmethod
    def from_vocab(cls, vocab_file):
        """
        加载词表文件。

        :param vocab_file: 文件路径。
        :return: 分词器实例。
        """
        with open(vocab_file, 'r', encoding='utf-8') as f:
            vocab_list = [line.strip() for line in f.readlines()]
        return cls(vocab_list)

    def encode(self, sentence, seq_len, add_sos_eos=False):
        """
        将句子编码为索引列表。

        :param sentence: 输入句子。
        :param seq_len: 最大序列长度。
        :param add_sos_eos: 是否添加 <sos> 和 <eos>。
        :return: 索引列表。
        """
        tokens = self.tokenize(sentence)
        indexes = [self.word2index.get(token, self.unk_token_index) for token in tokens]

        if add_sos_eos:
            indexes = indexes[:seq_len - 2]
            indexes = [self.sos_token_index] + indexes + [self.eos_token_index]
        else:
            indexes = indexes[:seq_len]

        if len(indexes) < seq_len:
            indexes += [self.pad_token_index] * (seq_len - len(indexes))

        return indexes

class ChineseTokenizer(BaseTokenizer):
    @staticmethod
    def tokenize(sentence):
        return list(sentence)

    def decode(self, indexes):
        return ''.join([self.index2word[index] for index in indexes])

class EnglishTokenizer(BaseTokenizer):
    @staticmethod
    def tokenize(sentence):
        return word_tokenize(sentence)

    def decode(self, indexes):
        tokens = [self.index2word[index] for index in indexes]
        return TreebankWordDetokenizer().detokenize(tokens)
(3)自定义数据集
# dataset.py

import pandas as pd
import torch
from torch.utils.data import Dataset, DataLoader
import config

class TranslationDataset(Dataset):
    def __init__(self, data_path):
        self.data = pd.read_json(data_path, lines=True).to_dict(orient='records')

    def __len__(self):
        return len(self.data)

    def __getitem__(self, index):
        input_tensor = torch.tensor(self.data[index]['zh'], dtype=torch.long)
        target_tensor = torch.tensor(self.data[index]['en'], dtype=torch.long)
        return input_tensor, target_tensor

def get_dataloader(train=True):
    data_path = config.PROCESSED_DATA_DIR / ('indexed_train.jsonl' if train else 'indexed_test.jsonl')
    dataset = TranslationDataset(data_path)
    return DataLoader(dataset, batch_size=config.BATCH_SIZE, shuffle=True)

if __name__ == '__main__':
    train_loader = get_dataloader(train=True)
    for inputs, targets in train_loader:
        print(inputs.shape)
        print(targets.shape)
        break
(4)模型定义
# model.py

import torch
from torch import nn
from torchinfo import summary

import config

class Attention(nn.Module):
    """
    注意力机制模块:计算当前 decoder 状态与 encoder 输出的注意力上下文向量。
    """

    def forward(self, decoder_hidden, encoder_outputs):
        """
        计算注意力权重并加权求和生成上下文向量。

        :param decoder_hidden: 当前时间步解码器的隐藏状态 (1, batch_size, decoder_hidden_dim)
        :param encoder_outputs: 编码器所有时间步输出 (batch_size, seq_len, decoder_hidden_dim)
        :return: 上下文向量 (batch_size, 1, decoder_hidden_dim)
        """
        # 计算注意力分数
        attention_scores = torch.bmm(
            decoder_hidden.transpose(0, 1),  # (batch_size, 1, hidden_dim)
            encoder_outputs.transpose(1, 2)  # (batch_size, hidden_dim, seq_len)
        )
        attention_weights = torch.softmax(attention_scores, dim=2)  # (batch_size, 1, seq_len)

        # 加权求和,得到上下文向量
        context_vector = torch.bmm(attention_weights, encoder_outputs)  # (batch_size, 1, hidden_dim)

        return context_vector

class TranslationEncoder(nn.Module):
    """
    编码器模块:双向 GRU 编码中文句子。
    """

    def __init__(self, vocab_size, padding_index):
        """
        初始化编码器。

        :param vocab_size: 中文词表大小。
        :param padding_index: padding 索引。
        """
        super().__init__()
        self.embedding = nn.Embedding(
            num_embeddings=vocab_size,
            embedding_dim=config.EMBEDDING_DIM,
            padding_idx=padding_index
        )
        self.rnn = nn.GRU(
            input_size=config.EMBEDDING_DIM,
            hidden_size=config.ENCODER_HIDDEN_DIM,
            num_layers=config.ENCODER_LAYERS,
            batch_first=True,
            bidirectional=True
        )

    def forward(self, src):
        """
        前向传播。

        :param src: 中文输入索引序列 (batch_size, seq_len)
        :return: (encoder_outputs, encoder_hidden)
        """
        embedded = self.embedding(src)  # (batch_size, seq_len, embedding_dim)
        output, hidden = self.rnn(embedded)
        return output, hidden

class TranslationDecoder(nn.Module):
    """
    解码器模块:单向 GRU + Attention,逐步生成英文翻译。
    """

    def __init__(self, vocab_size, padding_index):
        """
        初始化解码器。

        :param vocab_size: 英文词表大小。
        :param padding_index: padding 索引。
        """
        super().__init__()
        self.embedding = nn.Embedding(
            num_embeddings=vocab_size,
            embedding_dim=config.EMBEDDING_DIM,
            padding_idx=padding_index
        )
        self.rnn = nn.GRU(
            input_size=config.EMBEDDING_DIM,
            hidden_size=config.DECODER_HIDDEN_DIM,
            batch_first=True
        )
        # 输出维度是 hidden + context 拼接
        self.linear = nn.Linear(in_features=2 * config.DECODER_HIDDEN_DIM, out_features=vocab_size)
        self.attention = Attention()

    def forward(self, tgt, hidden, encoder_outputs):
        """
        前向传播。

        :param tgt: 当前输入 token,形状 (batch_size, 1)
        :param hidden: 上一时间步隐藏状态 (1, batch_size, hidden_dim)
        :param encoder_outputs: 编码器所有输出 (batch_size, seq_len, hidden_dim)
        :return: (output_logits, new_hidden)
        """
        embedded = self.embedding(tgt)  # (batch_size, 1, embedding_dim)
        output, hidden = self.rnn(embedded, hidden)  # output: (batch_size, 1, hidden_dim)

        context_vector = self.attention(hidden, encoder_outputs)  # (batch_size, 1, hidden_dim)

        combined = torch.cat((output, context_vector), dim=2)  # 拼接当前输出和上下文向量
        output = self.linear(combined)  # 输出词表上概率 (batch_size, 1, vocab_size)

        return output, hidden

if __name__ == '__main__':
    encoder = TranslationEncoder(vocab_size=10000, padding_index=0)
    dummy_encoder_input = torch.randint(low=0, high=10000, size=(config.BATCH_SIZE, config.SEQ_LEN))
    summary(encoder, input_data=dummy_encoder_input)

    print('-' * 100)

    decoder = TranslationDecoder(vocab_size=10000, padding_index=0)
    dummy_decoder_input = torch.randint(low=0, high=10000, size=(config.BATCH_SIZE, 1))
    dummy_decoder_hidden = torch.randn(size=(1, config.BATCH_SIZE, config.DECODER_HIDDEN_DIM))
    dummy_encoder_outputs = torch.randn(size=(config.BATCH_SIZE, config.SEQ_LEN, config.DECODER_HIDDEN_DIM))
    summary(decoder, input_data=[dummy_decoder_input, dummy_decoder_hidden, dummy_encoder_outputs])
(5)模型训练
# train.py

import time
from itertools import chain

import torch
from torch.nn import CrossEntropyLoss
from torch.utils.tensorboard import SummaryWriter
from tqdm import tqdm

from dataset import get_dataloader
from tokenizer import ChineseTokenizer, EnglishTokenizer
import config
from model import TranslationEncoder, TranslationDecoder

def train_one_epoch(dataloader, encoder, decoder, loss_function, optimizer, device):
    encoder.train()
    decoder.train()
    total_loss = 0
    for src, tgt in tqdm(dataloader, desc='训练'):
        src = src.to(device)  # src.shape: (batch_size , seq_len)
        tgt = tgt.to(device)  # tgt.shape: (batch_size , seq_len)

        optimizer.zero_grad()

        # 编码器
        encoder_outputs, encoder_hidden = encoder(src)
        # 上下文向量
        forward_hidden = encoder_hidden[-2]  # forward_hidden.shape: (batch_size , encoder_hidden_size)
        backward_hidden = encoder_hidden[-1]  # backward_hidden.shape: (batch_size , encoder_hidden_size)
        context_vector = torch.cat([forward_hidden, backward_hidden],
                                   dim=1)  # context_vector.shape: ( batch_size , decoder_hidden_size)

        # 解码器
        decoder_input = tgt[:, 0:1]  # decoder_input.shape: (batch_size,1)

        decoder_hidden = context_vector.unsqueeze(0)  # decoder_hidden.shape: (1, batch_size, decoder_hidden_size)

        decoder_outputs = []
        for step in range(1, config.SEQ_LEN):
            decoder_output, decoder_hidden = decoder(decoder_input, decoder_hidden, encoder_outputs)
            decoder_outputs.append(decoder_output)
            decoder_input = tgt[:, step:step + 1]

        decoder_outputs = torch.cat(decoder_outputs, dim=1)
        # decoder_outputs.shape: (batch_size, seq_len-1, vocab_size)

        decoder_targets = tgt[:, 1:]
        # decoder_targets.shape: (batch_size, seq_len-1)

        loss = loss_function(decoder_outputs.reshape(-1, decoder_outputs.shape[-1]), decoder_targets.reshape(-1))
        loss.backward()
        optimizer.step()
        total_loss += loss.item()
    return total_loss / len(dataloader)

def train():
    # 设备
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

    # 数据集
    dataloader = get_dataloader()

    # tokenizer
    zh_tokenizer = ChineseTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'zh_vocab.txt')
    en_tokenizer = EnglishTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'en_vocab.txt')

    # 模型
    encoder = TranslationEncoder(vocab_size=zh_tokenizer.vocab_size, padding_index=zh_tokenizer.pad_token_index).to(
        device)
    decoder = TranslationDecoder(vocab_size=en_tokenizer.vocab_size, padding_index=en_tokenizer.pad_token_index).to(
        device)

    # 损失函数
    loss_function = CrossEntropyLoss(ignore_index=en_tokenizer.pad_token_index)

    # 优化器
    optimizer = torch.optim.Adam(params=chain(encoder.parameters(), decoder.parameters()), lr=config.LEARNING_RATE)

    # tensorboard
    writer = SummaryWriter(log_dir=config.LOGS_DIR / time.strftime('%Y-%m-%d_%H-%M-%S'))

    # 开始训练
    best_loss = float('inf')
    for epoch in range(1, config.EPOCHS + 1):
        print(f'========== Epoch {epoch} ==========')
        avg_loss = train_one_epoch(dataloader, encoder, decoder, loss_function, optimizer, device)

        print(f'平均损失: {avg_loss}')
        writer.add_scalar('Loss', avg_loss, epoch)

        if avg_loss < best_loss:
            best_loss = avg_loss
            torch.save(encoder.state_dict(), config.MODELS_DIR / 'encoder.pt')
            torch.save(decoder.state_dict(), config.MODELS_DIR / 'decoder.pt')
            print('已保存模型')
        else:
            print('未保存模型')

if __name__ == '__main__':
    train()
(6)模型预测
# predict.py

import torch
from tokenizer import ChineseTokenizer, EnglishTokenizer
from model import TranslationEncoder, TranslationDecoder
import config

def predict_batch(input_tensor, encoder, decoder, en_tokenizer, device):
    """
    对一个 batch 的中文输入进行翻译。

    :param input_tensor: 中文输入张量 (batch_size, seq_len)
    :param encoder: 编码器
    :param decoder: 解码器
    :param en_tokenizer: 英文分词器
    :param device: 设备
    :return: 生成的英文索引列表
    """
    encoder.eval()
    decoder.eval()

    with torch.no_grad():
        # 编码器前向传播
        encoder_output, encoder_hidden = encoder(input_tensor)

        # 拼接双向 GRU 最后一层隐藏状态作为上下文向量
        context_vector = torch.cat([encoder_hidden[-2], encoder_hidden[-1]], dim=1)  # (batch_size, hidden_dim*2)

        batch_size = input_tensor.size(0)
        decoder_input = torch.full(
            size=(batch_size, 1),
            fill_value=en_tokenizer.sos_token_index,
            device=device
        )  # 初始输入 <sos>
        decoder_hidden = context_vector.unsqueeze(0)  # 初始化解码器隐藏状态 (1, batch_size, hidden_dim)

        generated = [[] for _ in range(batch_size)]
        finished = [False for _ in range(batch_size)]

        for step in range(1, config.SEQ_LEN):
            decoder_output, decoder_hidden = decoder(decoder_input, decoder_hidden, encoder_output)

            predict_indexes = decoder_output.argmax(dim=-1)  # (batch_size, 1)

            for i in range(batch_size):
                if finished[i]:
                    continue
                token_id = predict_indexes[i].item()
                if token_id == en_tokenizer.eos_token_index:
                    finished[i] = True
                else:
                    generated[i].append(token_id)

            if all(finished):
                break

            decoder_input = predict_indexes

        return generated

def predict(zh_sentence, encoder, decoder, zh_tokenizer, en_tokenizer, device):
    """
    对单条中文句子进行翻译。

    :param zh_sentence: 中文句子
    :param encoder: 编码器
    :param decoder: 解码器
    :param zh_tokenizer: 中文分词器
    :param en_tokenizer: 英文分词器
    :param device: 设备
    :return: 英文翻译句子
    """
    input_ids = zh_tokenizer.encode(zh_sentence, seq_len=config.SEQ_LEN, add_sos_eos=False)
    input_tensor = torch.tensor([input_ids], device=device)
    generated = predict_batch(input_tensor, encoder, decoder, en_tokenizer, device)
    en_indexes = generated[0]
    en_sentence = en_tokenizer.decode(en_indexes)
    return en_sentence

def run_predict():
    """
    启动交互式翻译程序。
    """
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

    zh_tokenizer = ChineseTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'zh_vocab.txt')
    en_tokenizer = EnglishTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'en_vocab.txt')

    encoder = TranslationEncoder(
        vocab_size=zh_tokenizer.vocab_size,
        padding_index=zh_tokenizer.pad_token_index
    ).to(device)
    encoder.load_state_dict(torch.load(config.MODELS_DIR / 'encoder.pt'))

    decoder = TranslationDecoder(
        vocab_size=en_tokenizer.vocab_size,
        padding_index=en_tokenizer.pad_token_index
    ).to(device)
    decoder.load_state_dict(torch.load(config.MODELS_DIR / 'decoder.pt'))

    print('欢迎使用翻译系统,请输入中文句子:(输入 q 或 quit 退出)')
    while True:
        user_input = input('中文:')
        if user_input in ['q', 'quit']:
            print('谢谢使用,再见!')
            break
        if not user_input:
            print('请输入内容')
            continue

        result = predict(user_input, encoder, decoder, zh_tokenizer, en_tokenizer, device)
        print(f'英文:{result}')

if __name__ == '__main__':
run_predict()(7)模型评估
# evaluate.py

import torch
from nltk.translate.bleu_score import corpus_bleu
from tqdm import tqdm

import config
from tokenizer import ChineseTokenizer, EnglishTokenizer
from model import TranslationEncoder, TranslationDecoder
from dataset import get_dataloader
from predict import predict_batch

def evaluate(dataloader, encoder, decoder, zh_tokenizer, en_tokenizer, device):
    """
    执行模型评估,计算 BLEU 分数。

    :param dataloader: 数据加载器。
    :param encoder: 编码器。
    :param decoder: 解码器。
    :param zh_tokenizer: 中文分词器。
    :param en_tokenizer: 英文分词器。
    :param device: 设备。
    :return: BLEU 分数。
    """
    all_references = []
    all_predictions = []
    special_tokens = [
        zh_tokenizer.pad_token_index,
        zh_tokenizer.eos_token_index,
        zh_tokenizer.sos_token_index
    ]

    for src, tgt in tqdm(dataloader, desc="评估"):
        src = src.to(device)
        tgt = tgt.tolist()

        predict_indexes = predict_batch(src, encoder, decoder, en_tokenizer, device)
        all_predictions.extend(predict_indexes)

        for indexes in tgt:
            indexes = [index for index in indexes if index not in special_tokens]
            all_references.append([indexes])

    bleu = corpus_bleu(all_references, all_predictions)
    return bleu

def run_evaluate():
    """
    启动评估流程。
    """
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

    zh_tokenizer = ChineseTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'zh_vocab.txt')
    en_tokenizer = EnglishTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'en_vocab.txt')

    encoder = TranslationEncoder(zh_tokenizer.vocab_size, zh_tokenizer.pad_token_index).to(device)
    encoder.load_state_dict(torch.load(config.MODELS_DIR / 'encoder.pt'))

    decoder = TranslationDecoder(en_tokenizer.vocab_size, en_tokenizer.pad_token_index).to(device)
    decoder.load_state_dict(torch.load(config.MODELS_DIR / 'decoder.pt'))

    dataloader = get_dataloader(train=False)

    bleu = evaluate(dataloader, encoder, decoder, zh_tokenizer, en_tokenizer, device)
    print('========== 评估结果 ==========')
    print(f'BLEU: {bleu:.2f}')
    print('=============================')

if __name__ == '__main__':
    run_evaluate()
(8)配置文件
# config.py

from pathlib import Path

# 获取项目根目录
BASE_DIR = Path(__file__).parent.parent

# 定义项目中常用路径
MODELS_DIR = BASE_DIR / 'models'  # 模型保存路径
PROCESSED_DATA_DIR = BASE_DIR / 'data' / 'processed'  # 处理后的数据保存路径
RAW_DATA_DIR = BASE_DIR / 'data' / 'raw'  # 原始数据保存路径
LOGS_DIR = BASE_DIR / 'logs'  # TensorBoard 日志目录

# 模型结构参数
EMBEDDING_DIM = 128  # 词向量维度
ENCODER_HIDDEN_DIM = 512  # GRU 隐藏状态维度
DECODER_HIDDEN_DIM = 2 * ENCODER_HIDDEN_DIM
ENCODER_LAYERS = 1

# 训练相关超参数
BATCH_SIZE = 128  # 每个 batch 的样本数
SEQ_LEN = 30  # 序列长度(输入与输出最大长度)
LEARNING_RATE = 1e-3  # 学习率
EPOCHS = 30  # 总训练轮数
6.5 存在问题
尽管注意力机制极大地增强了 Seq2Seq 模型的建模能力,但由于其核心依然依赖于 RNN 结构,仍面临两个根本性问题:
- 计算过程无法并行
RNN 的时间步之间存在强依赖,必须顺序执行,限制了训练效率和硬件资源的利用率。
- 长期依赖问题仍未根除
模型需要跨多个时间步传递信息,对于超长序列,训练过程中容易出现梯度消失,难以有效建模长距离依赖关系。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容