

7.2.4.1 概述
Transformer解码器的主要功能是:根据编码器的输出,逐步生成目标序列中的每一个词。其生成方式采用自回归机制(
autoregressive):每一步的输入由此前已生成的所有词组成,模型将输出一个与当前输入长度相同的序列表示。我们只取最后一个位置的输出,作为当前步的预测结果。这一过程会不断重复,直到生成特殊的结束标记<eos>,表示序列生成完成。
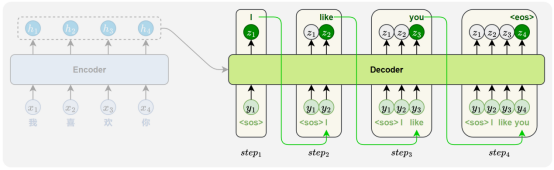
编码器也由多个结构相同的解码器层堆叠组成。
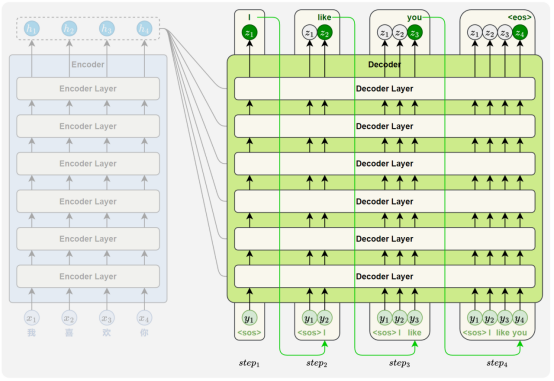
每个Decoder Layer都包含三个子层,分别是Masked自注意力子层、编码器-解码器注意力子层(Encoder-Decoder Attention
)和前馈神经网络子层(Feed-Forward Network)。
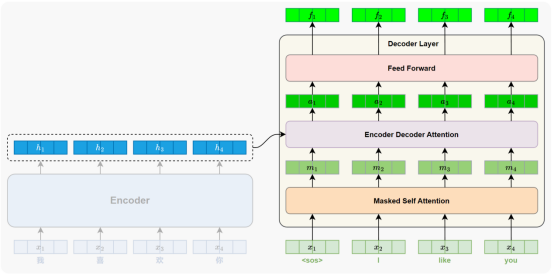
各层作用如下:
- Masked自注意力子层(Masked Self Attention)
用于建模当前位置与前文词之间的依赖关系。为了在训练时模拟逐词生成的过程,引入遮盖机制(Mask),限制每个位置只能关注它前面的词。
- 编码器-解码器注意力子层(Encoder-Decoder Attention)
用于建模当前解码位置与源序列各位置之间的依赖关系。通过注意力机制,模型能够根据当前状态从编码器的输出中提取相关上下文信息(相当于 Seq2Seq 模型中的 Attention 机制)。
- 前馈神经网络子层(Feed-Forward Network)
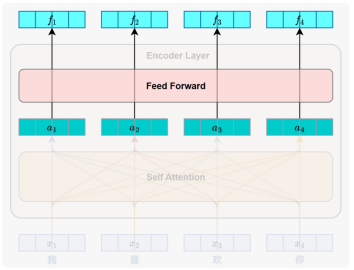
与编码器中结构完全一致,对每个位置的表示进行非线性变换,增强模型的表达能力。
每个子层后也都配有残差连接与层归一化(Layer Normalization),结构设计与编码器保持一致,确保训练的稳定性和效率。
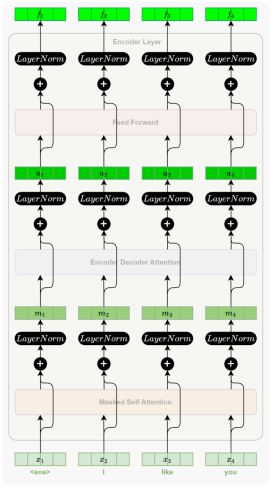
此外,解码器在输入端同样需要加入位置编码(Positional Encoding),用于提供序列中的位置信息,其计算方式与编码器中相同。
在输出端,解码器的隐藏向量会送入一个线性变换层(Linear),映射为词表大小的向量,并通过 Softmax 生成一个概率分布,用于预测当前应输出的词。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容