

4.1 RNN
4.1.1 概述
在自然语言中,词语的顺序对于理解句子的含义至关重要。虽然词向量能够表示词语的语义,但它本身并不包含词语之间的顺序信息。
为了解决这一问题,研究者提出RNN(Recurrent Neural Network,循环神经网络)。
RNN 会逐个读取句子中的词语,并在每一步结合当前词和前面的上下文信息,不断更新对句子的理解。通过这种机制,RNN 能够持续建模上下文,从而更准确地把握句子的整体语义。因此RNN曾是序列建模领域的主流模型,被广泛应用于各类NLP任务。
说明:
随着技术的发展,RNN已经逐渐被结构更灵活、计算效率更高的Transformer 模型所取代,后者已经成为当前自然语言处理的主流方法。
尽管如此,RNN 仍然具有重要的学习价值。它所体现的“循环建模上下文”的思想,不仅为 LSTM 和 GRU 等改进模型奠定了基础,也有助于我们更好地理解 Transformer 等更复杂的架构。
4.1.2 基础结构
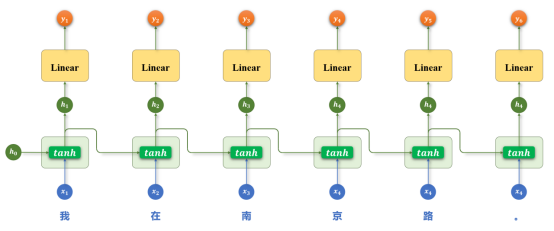
RNN(循环神经网络)的核心结构是一个具有循环连接的隐藏层,它以时间步(time step)为单位,依次处理输入序列中的每个 token。
在每个时间步,RNN 接收当前 token 的向量和上一个时间步的隐藏状态(即隐藏层的输出),计算并生成新的隐藏状态,并将其传递到下一时间步。
具体结构如下图所示:
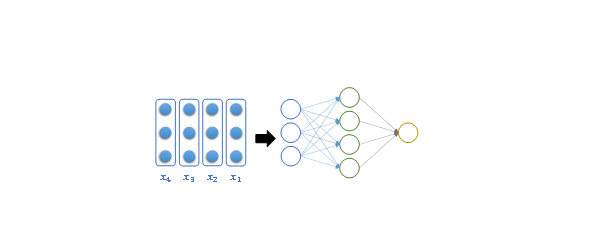
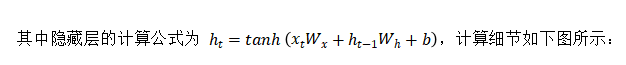
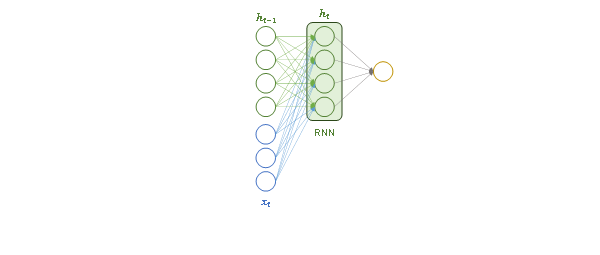
说明:
前面详细展示了基础 RNN 的内部结构,但 RNN还存在更复杂的结构形式。为了更清晰地展示这些结构的连接方式,接下来将使用简化的示意图来表示,省略内部细节,突出整体结构。
基础RNN的示意图如下:
4.1.3 多层结构
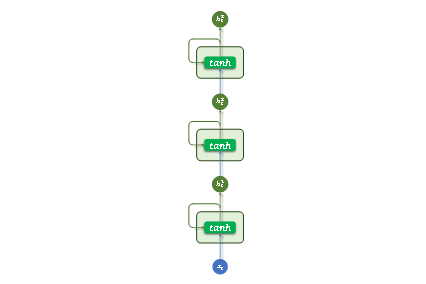
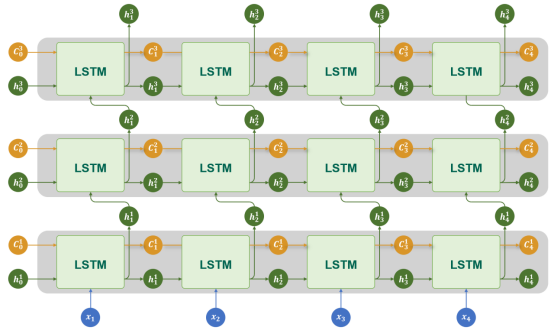
为了让模型捕捉更复杂的语言特征,可以将多个 RNN 层按层次堆叠起来,使不同层学习不同层次的语义信息。
这种设计的核心假设是:底层网络更容易捕捉局部模式(如词组、短语),而高层网络则能学习更抽象的语义信息(如句子主题或语境)。
多层RNN结构中,每一层的输出序列会作为下一层的输入序列,最底层RNN接收原始输入序列,顶层 RNN的输出作为最终结果用于后续任务。
4.1.4 双向结构
基础的 RNN 在每个时间步只输出一个隐藏状态,该状态仅包含来自上文的信息,而无法利用当前词之后的下文。
对于一些任务而言,这是一个明显的限制。比如在序列标注任务中,模型需要为每个 token 预测一个标签,如果只能参考前文信息,往往难以做出准确判断。
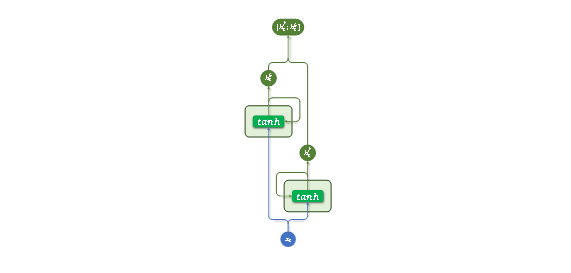
而使用双向 RNN(Bidirectional RNN),模型可以在每个时间步同时利用前文和后文的信息,从而获得更全面的上下文表示,有助于提升序列标注等任务的预测效果。
双向RNN同时使用两层 RNN:
正向 RNN:按照时间顺序(从前到后)处理序列;
反向 RNN:按照逆时间顺序(从后到前)处理序列。
每个时间步的输出,是正向和反向隐藏状态的组合(例如拼接或求和)。具体结构如下图所示
4.1.5 多层+双向结构
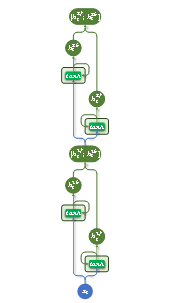
多层结构和双向结构还可组合使用,每层都是一个双向RNN,如下图所示
4.1.6 API使用
PyTorch 提供了 torch.nn.RNN 模块用于构建循环神经网络(Recurrent Neural Network, RNN)。该模块支持单层或多层结构,也可通过设置参数启用双向 RNN(bidirectional),适用于处理序列建模相关任务。
- 参数说明
构造RNN层所需的参数如下:
torch.nn.RNN(
    input_size,
    hidden_size,
    num_layers=1,
    nonlinearity="tanh",
    bias=True,
    batch_first=False,
    dropout=0.0,
    bidirectional=False,
    device=None,
    dtype=None,
)
各参数含义如下
| 参数名 | 类型 | 说明 |
| input_size | int | 每个时间步输入特征的维度(词向量维度) |
| hidden_size | int | 隐藏状态的维度 |
| num_layers | int | RNN 层数,默认为 1 |
| nonlinearity | str | 激活函数,’tanh’(默认)或 ‘relu’ |
| bias | bool | 是否使用偏置项,默认 True |
| batch_first | bool | 输入张量是否是 (batch, seq, feature),默认 False 表示 (seq, batch, feature) |
| dropout | float | 除最后一层外,其余层之间的 dropout 概率 |
| bidirectional | bool | 是否为双向 RNN,默认 False |
| device | torch.device or str | 模块的初始化设备,如 ‘cuda’, ‘cpu’ |
| dtype | torch.dtype | 模块初始化时的默认数据类型,如torch.float32 |
输入输出
示例代码如下
rnn = torch.nn.RNN()
output, h_n = rnn(input, h_0)
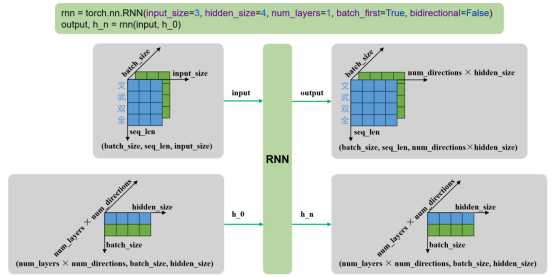
输入输出内容如下
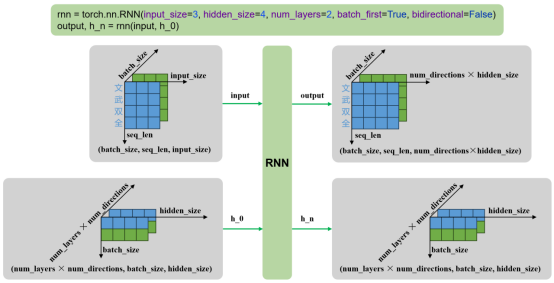
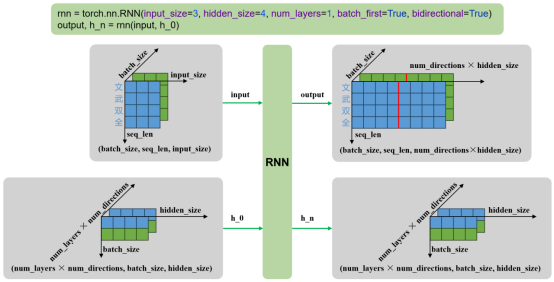
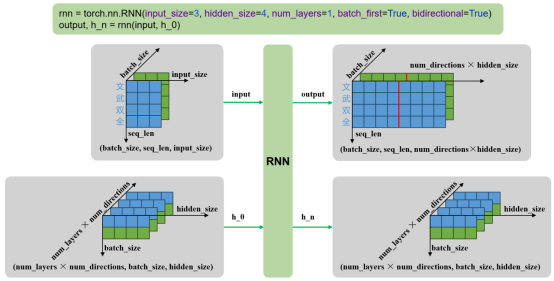
| 输入 | input | 输入序列,形状为(seq_len, batch_size, input_size),如果 batch_first=True,则为 (batch_size, seq_len, input_size) |
| h_0 | 可选,初始隐藏状态,形状为 (num_layers × num_directions, batch_size, hidden_size) | |
| 输出 | output | RNN层的输出,包含最后一层每个时间步的隐藏状态,形状为 (seq_len, batch_size, num_directions × hidden_size ),如果如果 batch_first=True,则为(batch_size, seq_len, num_directions × hidden_size ) |
| h_n | 最后一个时间步的隐藏状态,包含每一层的每个方向,形状为 (num_layers × num_directions, batch_size, hidden_size) |
输入输出形状如下
- 单层单向
多层单向
单层双向
多层双向












请登录后查看评论内容