

- 需求说明
本案例旨在实现一个用于手机输入法的智能词语联想模型。
具体需求为:根据用户当前已输入的文本内容,预测下一个可能输入的词语,要求返回概率最高的 5 个候选词供用户选择。
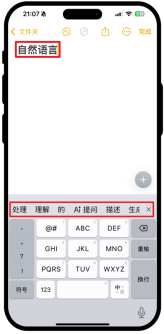
例如:向模型输入“自然语言”,模型输出[“处理”、“理解”、“的”、“描述”、“生成”] ,如下图所示
2.需求分析
1)数据集处理
在本任务中,模型需要根据用户已输入的文本预测下一个可能输入的词语,因此训练数据应具备自然语言上下文连续性和贴近真实使用场景的特点。
可选数据来源包括:
- 用户真实输入内容:如聊天记录、搜索历史、输入法日志等。这类数据最能反映真实输入场景,有助于模型学习用户输入习惯和上下文联想模式。
- 开放领域对话语料:如论坛回复、社交平台评论、闲聊对话等。这类语料具有较强的口语化特征,能够提升模型在真实输入场景中的泛化能力。
本任务使用的数据集为https://huggingface.co/datasets/Jax-dan/HundredCV-Chat
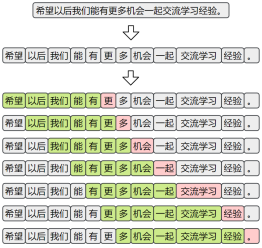
为了构造适用于“下一词预测”任务的训练样本,首先需要对原始语料进行分词。随后,采用滑动窗口的方式,从分词后的序列中提取连续的上下文片段,并以每个窗口的下一个词作为预测目标,构成输入-输出对,如下图所示
2)模型结构设计
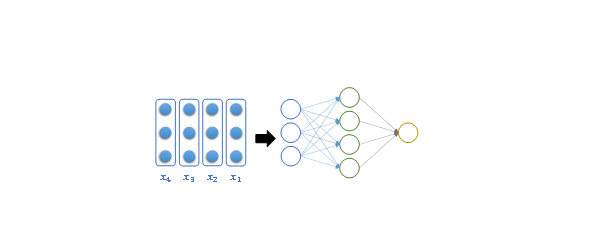
本任务采用基于循环神经网络(RNN)的语言模型结构来实现“下一词预测”功能。模型整体由以下三个主要部分组成:
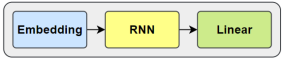
- 嵌入层(Embedding)
将输入的词或字索引映射为稠密向量表示,便于后续神经网络处理。
- 循环神经网络层(RNN)
用于建模输入序列的上下文信息,输出最后一个时间步的隐藏状态作为上下文表示。
- 输出层(Linear)
将隐藏状态映射到词表大小的维度,生成对下一个词的概率预测。
3)训练方案
- 损失函数
下一个词的预测本质为多分类问题,所以损失函数采用 CrossEntropyLoss,其结合了softmax和交叉熵计算。
- 优化器
使用 Adam 优化器,具有较强的收敛能力和稳定性。
3.需求实现
1)项目结构
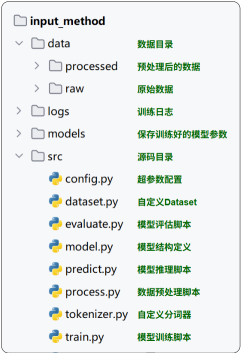
项目结构如下图所示
2)完整代码
(1)数据预处理
本模块负责将原始数据进行清洗、分词、编码与划分,最终生成模型可直接读取的标准格式数据集,并保存到jsonl文件中,如下图所示
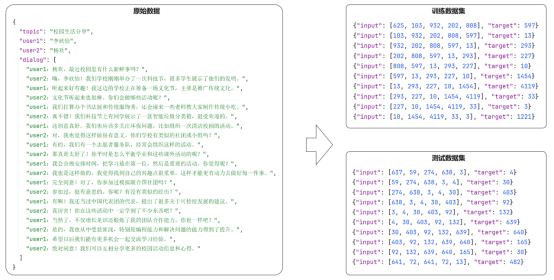
具体代码如下:
# process.py

import time

import torch
from torch import nn
from torch.utils.tensorboard import SummaryWriter
from tqdm import tqdm

from dataset import get_dataloader
from model import InputMethodModel
from tokenizer import JiebaTokenizer
import config

def train_one_epoch(model, dataloader, loss_function, optimizer, device):
    """
    训练一个 epoch。

    :param model: 输入法模型。
    :param dataloader: 数据加载器。
    :param loss_function: 损失函数。
    :param optimizer: 优化器。
    :param device: 设备。
    :return: 平均损失。
    """
    total_loss = 0
    model.train()

    for inputs, targets in tqdm(dataloader, desc='训练'):
        # 将数据移到设备
        inputs, targets = inputs.to(device), targets.to(device)

        optimizer.zero_grad()

        # 前向传播
        outputs = model(inputs)

        # 计算损失
        loss = loss_function(outputs, targets)

        # 反向传播
        loss.backward()

        # 更新参数
        optimizer.step()

        total_loss += loss.item()

    avg_loss = total_loss / len(dataloader)
    return avg_loss

def train():
    """
    模型训练主函数。
    """
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    print('设备:', device)

    # 获取数据加载器
    dataloader = get_dataloader()

    # 加载 tokenizer 和模型
    tokenizer = JiebaTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'vocab.txt')
    model = InputMethodModel(vocab_size=tokenizer.vocab_size).to(device)

    loss_function = nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=config.LEARNING_RATE)

    # TensorBoard 日志
    writer = SummaryWriter(log_dir=config.LOG_DIR / time.strftime('%Y-%m-%d_%H-%M-%S'))

    best_loss = float('inf')

    for epoch in range(1, config.EPOCHS + 1):
        print(f'========== Epoch: {epoch} ==========')

        # 训练一个 epoch
        avg_loss = train_one_epoch(model, dataloader, loss_function, optimizer, device)
        print(f'Loss: {avg_loss:.4f}')

        # 记录到 TensorBoard
        writer.add_scalar('Loss/train', avg_loss, epoch)

        # 保存最优模型
        if avg_loss < best_loss:
            best_loss = avg_loss
            torch.save(model.state_dict(), config.MODELS_DIR / 'model.pt')
            print('模型保存成功!')

if __name__ == '__main__':
    train()
(2)自定义分词器
本模块负责分词、词表构建等功能。
# tokenizer.py

import jieba
from tqdm import tqdm

jieba.setLogLevel(jieba.logging.WARNING)

class JiebaTokenizer:
    """
    基于 jieba 的分词器,用于分词、编码和词表管理。
    """

    unk_token = '<unk>'

    @staticmethod
    def tokenize(sentence):
        """
        对句子进行分词。

        :param sentence: 输入句子。
        :return: 分词后的 token 列表。
        """
        # 调用 jieba 分词
        return jieba.lcut(sentence)

    @classmethod
    def build_vocab(cls, sentences, vocab_file):
        """
        构建词表并保存到文件。

        :param sentences: 句子列表。
        :param vocab_file: 保存词表的文件路径。
        """
        unique_words = set()
        for sentence in tqdm(sentences, desc='分词'):
            # 收集所有唯一词
            for word in cls.tokenize(sentence):
                unique_words.add(word)

        # 将 <unk> 放在词表首位
        vocab_list = [cls.unk_token] + list(unique_words)

        # 保存词表到文件
        with open(vocab_file, 'w', encoding='utf-8') as f:
            for word in vocab_list:
                f.write(word + '\n')

    @classmethod
    def from_vocab(cls, vocab_file):
        """
        从文件加载词表。

        :param vocab_file: 词表文件路径。
        :return: JiebaTokenizer 实例。
        """
        with open(vocab_file, 'r', encoding='utf-8') as f:
            vocab_list = [line.strip() for line in f.readlines()]
        return cls(vocab_list)

    def __init__(self, vocab_list):
        """
        初始化 tokenizer。

        :param vocab_list: 词表列表。
        """
        self.vocab_list = vocab_list
        self.vocab_size = len(vocab_list)
        # 建立词到索引映射
        self.word2index = {word: index for index, word in enumerate(vocab_list)}
        # 建立索引到词的映射
        self.index2word = {index: word for index, word in enumerate(vocab_list)}
        # 获取未知词索引
        self.unk_token_index = self.word2index[self.unk_token]

    def encode(self, sentence):
        """
        将句子编码为索引列表。

        :param sentence: 输入句子。
        :return: 索引列表。
        """
        tokens = self.tokenize(sentence)
        # 将 token 转为索引,未知词用 unk 索引替代
return [self.word2index.get(token, self.unk_token_index) for token in tokens](3)自定义数据集
# dataset.py

import torch
from torch.utils.data import Dataset, DataLoader
import pandas as pd

import config

class InputMethodDataset(Dataset):
    """
    输入法数据集类,用于加载 JSONL 文件并生成张量。
    """

    def __init__(self, file_path):
        """
        初始化数据集。

        :param file_path: 数据文件路径(JSONL 格式)。
        """
        self.data = pd.read_json(file_path, lines=True).to_dict(orient='records')

    def __len__(self):
        """
        获取数据集样本数量。

        :return: 样本数量。
        """
        return len(self.data)

    def __getitem__(self, index):
        """
        获取指定索引的数据样本。

        :param index: 数据索引。
        :return: (input_tensor, target_tensor)
        """
        input_tensor = torch.tensor(self.data[index]['input'], dtype=torch.long)
        target_tensor = torch.tensor(self.data[index]['target'], dtype=torch.long)
        return input_tensor, target_tensor

def get_dataloader(train=True):
    """
    获取数据加载器。

    :param train: 是否加载训练集(True 加载训练集,False 加载测试集)。
    :return: DataLoader 对象。
    """
    file_name = 'indexed_train.jsonl' if train else 'indexed_test.jsonl'
    dataset = InputMethodDataset(config.PROCESSED_DATA_DIR / file_name)
    return DataLoader(dataset, batch_size=config.BATCH_SIZE, shuffle=True)

if __name__ == '__main__':
    dataloader = get_dataloader()
    for input_tensor, target_tensor in dataloader:
        print(input_tensor.shape, target_tensor.shape)
        break
(4)模型定义
# model.py

import torch
from torch import nn
from torchinfo import summary

import config

class InputMethodModel(nn.Module):
    """
    输入法预测模型,基于 RNN 的序列模型。
    """

    def __init__(self, vocab_size):
        """
        初始化模型。

        :param vocab_size: 词表大小。
        """
        super().__init__()
        # 嵌入层:将 token 索引映射为稠密向量
        self.embedding = nn.Embedding(num_embeddings=vocab_size, embedding_dim=config.EMBEDDING_DIM)
        # RNN:处理序列数据,提取上下文特征
        self.rnn = nn.RNN(
            input_size=config.EMBEDDING_DIM,
            hidden_size=config.HIDDEN_SIZE,
            batch_first=True
        )
        # 全连接层:将隐藏状态映射到词表大小的概率分布
        self.linear = nn.Linear(in_features=config.HIDDEN_SIZE, out_features=vocab_size)

    def forward(self, x):
        """
        前向传播。

        :param x: 输入张量,形状 (batch_size, seq_len)。
        :return: 模型输出,形状 (batch_size, vocab_size)。
        """
        # 嵌入层处理输入序列
        embed = self.embedding(x)  # (batch_size, seq_len, embedding_dim)

        # RNN 处理嵌入向量序列
        output, _ = self.rnn(embed)  # (batch_size, seq_len, hidden_size)

        # 取最后一个时间步的输出进行分类
        result = self.linear(output[:, -1, :])  # (batch_size, vocab_size)

        return result

if __name__ == '__main__':
    model = InputMethodModel(vocab_size=20000).to('cuda')

    # 创建随机 dummy 输入用于展示模型结构
    dummy_input = torch.randint(
        low=0,
        high=20000,
        size=(config.BATCH_SIZE, config.SEQ_LEN),
        dtype=torch.long,
        device='cuda'
    )

    # 打印模型摘要
summary(model, input_data=dummy_input)(5)模型训练
# train.py

import time

import torch
from torch import nn
from torch.utils.tensorboard import SummaryWriter
from tqdm import tqdm

from dataset import get_dataloader
from model import InputMethodModel
from tokenizer import JiebaTokenizer
import config

def train_one_epoch(model, dataloader, loss_function, optimizer, device):
    """
    训练一个 epoch。

    :param model: 输入法模型。
    :param dataloader: 数据加载器。
    :param loss_function: 损失函数。
    :param optimizer: 优化器。
    :param device: 设备。
    :return: 平均损失。
    """
    total_loss = 0
    model.train()

    for inputs, targets in tqdm(dataloader, desc='训练'):
        # 将数据移到设备
        inputs, targets = inputs.to(device), targets.to(device)

        optimizer.zero_grad()

        # 前向传播
        outputs = model(inputs)

        # 计算损失
        loss = loss_function(outputs, targets)

        # 反向传播
        loss.backward()

        # 更新参数
        optimizer.step()

        total_loss += loss.item()

    avg_loss = total_loss / len(dataloader)
    return avg_loss

def train():
    """
    模型训练主函数。
    """
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    print('设备:', device)

    # 获取数据加载器
    dataloader = get_dataloader()

    # 加载 tokenizer 和模型
    tokenizer = JiebaTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'vocab.txt')
    model = InputMethodModel(vocab_size=tokenizer.vocab_size).to(device)

    loss_function = nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=config.LEARNING_RATE)

    # TensorBoard 日志
    writer = SummaryWriter(log_dir=config.LOG_DIR / time.strftime('%Y-%m-%d_%H-%M-%S'))

    best_loss = float('inf')

    for epoch in range(1, config.EPOCHS + 1):
        print(f'========== Epoch: {epoch} ==========')

        # 训练一个 epoch
        avg_loss = train_one_epoch(model, dataloader, loss_function, optimizer, device)
        print(f'Loss: {avg_loss:.4f}')

        # 记录到 TensorBoard
        writer.add_scalar('Loss/train', avg_loss, epoch)

        # 保存最优模型
        if avg_loss < best_loss:
            best_loss = avg_loss
            torch.save(model.state_dict(), config.MODELS_DIR / 'model.pt')
            print('模型保存成功!')

if __name__ == '__main__':
    train()
(6)模型预测
本模块用于展示模型预测效果,具体效果如下:
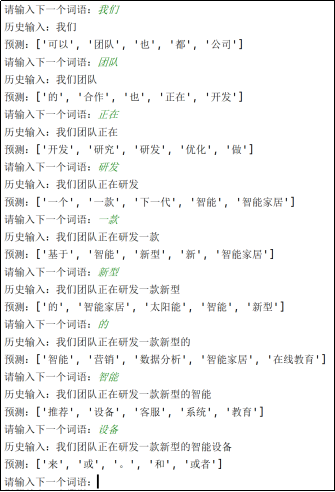
具体代码如下:
# predict.py

import torch
from model import InputMethodModel
from tokenizer import JiebaTokenizer
import config

def predict_batch(input_tensor, model):
    """
    对一个 batch 的输入进行预测。

    :param input_tensor: 输入张量,形状 (batch_size, seq_len)。
    :param model: 输入法模型。
    :return: 每个样本 top-5 的索引列表。
    """
    model.eval()
    with torch.no_grad():
        # 前向传播获取输出 logits
        output = model(input_tensor)  # (batch_size, vocab_size)

        # 选取 top-5 概率最高的 token 索引
        predict_ids = torch.topk(output, k=5, dim=-1).indices  # (batch_size, 5)

    return predict_ids.tolist()

def predict(text, model, tokenizer, device):
    """
    对单条文本进行预测。

    :param text: 用户输入文本。
    :param model: 输入法模型。
    :param tokenizer: 分词器。
    :param device: 设备。
    :return: top-5 预测结果词汇列表。
    """
    # 编码文本为 token 索引
    input_ids = tokenizer.encode(text)

    # 转换为张量并移动到设备
    input_tensor = torch.tensor([input_ids], dtype=torch.long, device=device)

    # 调用 batch 预测
    topk_ids = predict_batch(input_tensor, model)[0]

    # 索引映射回词语
    return [tokenizer.index2word[topk_id] for topk_id in topk_ids]

def run_predict():
    """
    启动预测交互程序。
    """
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

    # 加载 tokenizer
    tokenizer = JiebaTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'vocab.txt')

    # 创建并加载模型
    model = InputMethodModel(vocab_size=tokenizer.vocab_size).to(device)
    model.load_state_dict(torch.load(config.MODELS_DIR / 'model.pt'))

    print('请输入词语:(输入q或者quit退出系统)')

    text = ''
    while True:
        user_input = input('> ')
        if user_input in ['q', 'quit']:
            print('感谢使用!')
            break

        if not user_input:
            print('请输入词语!')
            continue

        # 更新历史输入
        text += user_input
        print('历史输入:', text)

        # 获取预测结果
        topk_tokens = predict(text, model, tokenizer, device)
        print('预测结果:', topk_tokens)

if __name__ == '__main__':
run_predict()
(7)模型评估
本模块用于评估模型效果,评估指标为Top-1准确率和Top-5准确率。
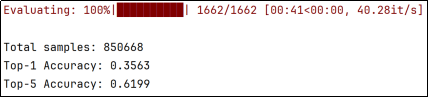
具体代码如下:
# evaluate.py

import torch
from tqdm import tqdm

from tokenizer import JiebaTokenizer
import config
from model import InputMethodModel
from dataset import get_dataloader
from predict import predict_batch

def evaluate(model, dataloader, device):
    """
    评估模型。

    :param model: 输入法模型。
    :param dataloader: 数据加载器。
    :param device: 设备。
    :return: (top1_acc, topk_acc)
    """
    total_count = 0
    top1_correct = 0
    topk_correct = 0

    model.eval()
    for inputs, targets in tqdm(dataloader, desc='评估'):
        inputs = inputs.to(device)
        targets = targets.tolist()

        # 获取 top-5 预测结果
        predicted_ids = predict_batch(inputs, model)

        # 统计 top-1 和 top-5 正确率
        for pred, target in zip(predicted_ids, targets):
            if pred[0] == target:
                top1_correct += 1
            if target in pred:
                topk_correct += 1
            total_count += 1

    top1_acc = top1_correct / total_count
    topk_acc = topk_correct / total_count
    return top1_acc, topk_acc

def run_evaluate():
    """
    运行评估流程。
    """
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

    tokenizer = JiebaTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'vocab.txt')

    model = InputMethodModel(vocab_size=tokenizer.vocab_size).to(device)
    model.load_state_dict(torch.load(config.MODELS_DIR / 'model.pt'))

    dataloader = get_dataloader(train=False)

    # 执行评估
    top1_acc, topk_acc = evaluate(model, dataloader, device)

    # 输出评估结果
    print("======= 评估结果 =======")
    print(f"Top-1 准确率: {top1_acc:.4f}")
    print(f"Top-5 准确率: {topk_acc:.4f}")
    print("========================")

if __name__ == '__main__':
    run_evaluate()
(8)配置文件
# config.py

from pathlib import Path

# 项目根目录
ROOT_DIR = Path(__file__).parent.parent

# 数据路径
RAW_DATA_DIR = ROOT_DIR / 'data' / 'raw'
PROCESSED_DATA_DIR = ROOT_DIR / 'data' / 'processed'

# 模型和日志路径
MODELS_DIR = ROOT_DIR / 'models'
LOG_DIR = ROOT_DIR / 'logs'

# 训练参数
SEQ_LEN = 5  # 输入序列长度
BATCH_SIZE = 64  # 批大小
EMBEDDING_DIM = 64  # 嵌入层维度
HIDDEN_SIZE = 128  # RNN 隐藏层维度
LEARNING_RATE = 1e-3  # 学习率
EPOCHS = 30  # 训练轮数











请登录后查看评论内容