

8.3.1 GPT
- 概述
GPT(Generative Pre-trained Transformer)是第一个系统性提出“预训练 + 微调”范式的语言模型。
其核心思想是通过大规模无监督语料进行生成式语言建模预训练,即训练模型根据左侧上下文预测下一个词,从而让模型学习自然语言的通用语法、语义和上下文依赖能力。完成预训练后,再通过微调适应具体的下游任务。
GPT首次展示了生成式语言模型在自然语言理解任务中的广泛迁移能力,为后续 GPT 系列及整个预训练语言模型的发展奠定了基础。
2.模型结构
GPT基于Transformer的解码器结构,但与标准的Transformer解码器并不完全相同,GPT具体结构如下图所示:
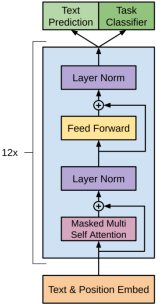
各部分细节如下:
- 输入嵌入层(Text & Position Embedding)
与原始Transformer一样,每个输入 token 的表示也由两部分组成:
- Text Embedding:将词或子词映射为向量;
- Position Embedding:提供词在序列中的位置信息。
GPT不同于原始Transformer的一点在于:位置编码采用的是可学习的位置嵌入(learnable positional embedding)。这意味着每个位置对应一个可训练的向量,模型可以在训练过程中自动优化这些向量,而非使用不可训练的三角函数编码(如正弦/余弦函数)。
每个token的最终表示是词嵌入与位置嵌入的向量和,向量维度为 768。
- 解码器
解码器部分由12个结构相同的解码器层堆叠而成,每个解码器层只包含如下两个子层:
- 掩码多头自注意力(12头)
- 前馈网络输出层
根据任务不同,GPT模型的输出可以接入不同的任务头:
- Text Prediction(文本预测)
用于下一个词的生成,输出是词表大小的概率分布,经过Softmax获得,预训练阶段使用的便是该任务头。
- Task Classifier(任务分类器)
该任务头多用于模型微调阶段,以适配具体的下游任务。通过提取特定位置的表示(如最后一个token)对整个输入文本进行分类(如情感分析、话题识别等)。
3.预训练
GPT 的预训练阶段采用生成式语言建模(Generative Language Modeling)作为训练目标,在大规模无监督文本上进行自监督学习。具体而言,模型的任务是基于已观察到的前文上下文,预测当前词的位置应出现的词,从而学习自然语言的统计规律与上下文依赖关系。这种自回归语言建模方式不依赖人工标注,训练样本可以直接从原始文本中自动构建,极大地降低了构建数据的成本。
GPT 使用 Transformer 架构,具备全局自注意力机制,能够有效建模长距离依赖信息。同时,Transformer 的并行计算特性使得模型能够高效处理长文本序列,相较于传统的 RNN 架构,训练效率显著提升,也使得在大规模语料上进行预训练成为可能。
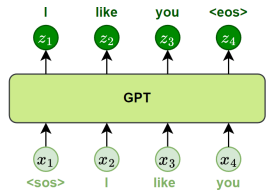
在实践中,GPT-1 使用了一个名为 BooksCorpus 的英文语料库,包含来自 7000 多本小说的完整书籍文本,总规模约 8 亿词。该语料语言自然、上下文完整,非常适合训练具备长距离依赖建模能力的语言模型。
4.微调
GPT的微调阶段是在完成无监督语言建模预训练之后,使用有监督的任务数据对模型进行进一步训练,使其适应具体的下游任务。微调的核心思路是:在保留预训练语言建模能力的基础上,利用标注数据对整个模型进行端到端优化,从而实现知识迁移。
具体实践中,GPT采用了如下两个关键措施:
- 添加任务输出层
在预训练模型顶部引入一个线性输出层(Linear Head),用于将 GPT 的隐藏状态映射为下游任务所需的标签或输出。
- 统一输入格式设计
GPT 作为自回归语言模型,其输入需为连续的文本序列。因此,在微调过程中需将各种下游任务转化为统一的文本输入格式。
下图展示了不同任务的微调逻辑:
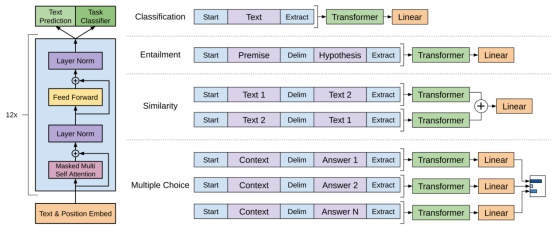
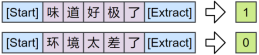
以图中的文本分类任务为例,假设我们有一个带标注的微调数据集如下:
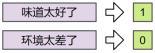
首先,将每条评论转为token 序列,并添加特殊标记[Start]与[Extract],形成模型标准输入格式:
然后,将转换后的序列送入GPT 模型。模型逐层处理后,输出每个位置的预测。我们只提取序列中最后一个位置
[Extract] 对应的输出,再通过新添加的线性输出层完成分类预测,最中输出标签“0”或“1”。如下图所示:
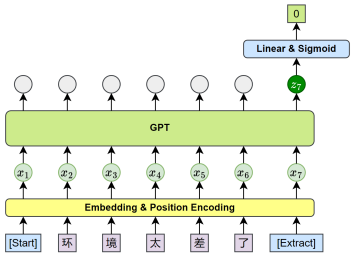
通过这种方式,GPT 在保留预训练模型结构和参数的基础上,仅添加极少量新参数(如线性层),便可高效完成从语言建模到多种下游任务的迁移。
此外,统一的输入格式设计进一步简化了多任务处理流程,使 GPT 能以一致的方式应对多种 NLP 任务,从而展现出强大的通用性与扩展性。











请登录后查看评论内容