

- 概述
BERT(Bidirectional Encoder Representations from Transformers)是由 Google 于 2018 年提出的一种语言预训练模型。其核心创新在于采用 Transformer 的编码器(Encoder)结构,通过双向自注意力机制,在建模每个 token 表示时同时整合左右两个方向的上下文信息,从而获得更准确、更丰富的语义表示。
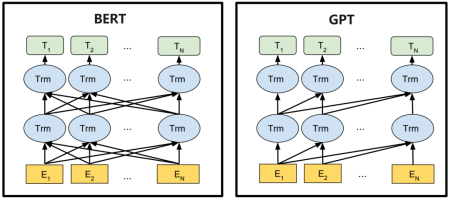
在得到每个token的表示后,BERT可通过添加简单的任务特定层,适配不同类型的下游任务。
BERT 的设计更侧重于自然语言理解类任务,广泛应用于文本分类、序列标注、句子匹配等场景。模型发布后,在多个语言理解基准测试中取得了前所未有的领先成绩,推动 NLP 研究全面转向“预训练 + 微调”的通用建模范式。
2.模型结构
BERT 基于标准的 Transformer 编码器构建,其提供了两种模型规模,分别是BERT-base和BERT-large。
具体参数规格如下:
| 模型版本 | 层数(Layers) | 模型维度(d_model) | 注意力头数(Heads) | 参数量 |
| BERT-base | 12 | 768 | 12 | 1.1 亿 |
| BERT-large | 24 | 1024 | 16 | 3.4 亿 |
BERT模型各部分的结构细节如下:
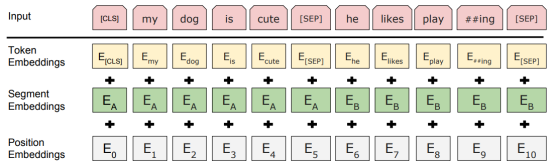
1)输入表示层
BERT 的每个输入 token 表示由三部分嵌入相加组成:
- Token Embedding:词本身的语义表示;
- Position Embedding:表示 token 在序列中的位置,为可学习向量;
- Segment Embedding:用于区分句子对任务中的两个句子,分别用一个可学习的向量表示。
如下图所示:
此外,BERT 输入中通常包含两个特殊符号:
[CLS]:句首标志,其输出向量常用于下游的文本分类任务;
[SEP]:句间分隔符,出现在每个句子末尾。
2)编码器
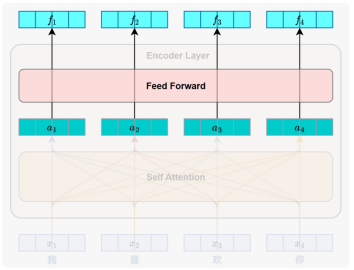
编码器结构同原始Transformer相同,不再赘述。
3)输出层
根据下游任务的类型,BERT 可以接入不同的任务输出头:
Token-Level 任务(如命名实体识别):使用每个位置的输出表示;
Sequence-Level 任务(如文本分类、句子对分类):使用特殊 token [CLS] 的输出表示,输入时被加在序列开头,专门用于汇总整个序列的语义信息。
3.预训练
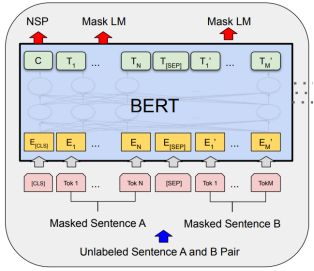
BERT 的预训练阶段包含两个核心任务:掩码语言模型(Masked Language Modeling, MLM) 和 下一句预测(Next Sentence Prediction, NSP),分别用于学习词级语义和句间逻辑关系。
- 掩码语言模型(MLM)
为实现双向语言建模,BERT 不采用传统的从左到右或从右到左预测方式,而是引入了掩码语言模型。在训练中,BERT 会随机遮盖输入序列中约 15% 的 token,并训练模型根据上下文预测被遮盖的词。
遮盖策略如下:
- 80% 的被遮盖 token 替换为 [MASK];
- 10% 替换为随机词;
- 10% 保持原词不变。
这种机制让模型在预训练时既能看到左侧上下文,也能看到右侧上下文,真正实现深度双向建模。

- 下一句预测(NSP)
为了提升模型理解句间关系的能力,BERT 引入了“下一句预测”任务。训练时模型接收两个句子,判断第二句是否是第一句的真实后续句,其中:
50% 的训练样本是上下文中真实相邻的句子(正例);
50% 是从语料中随机采样的非相邻句子(反例)。
- 正例:
- A:我今天很忙。
- B:所以没去上班。
- 反例:
- A:我今天很忙。
- B:天气很好。
在预训练时,BERT 同时优化 MLM 和 NSP 两个目标,具体操作如下图所示:
4.微调
在预训练完成后,BERT 可通过少量微调适配多种下游任务,如文本分类、句子匹配、问答系统、序列标注等。微调时,模型主体结构保持不变,仅在顶部添加一个任务特定的输出层,并使用下游任务数据对整个模型进行训练。
BERT 的输入格式在微调阶段基本保持与预训练一致,仍以 token 序列为输入,使用 [CLS] 和 [SEP] 等特殊符号。不同任务的差异主要体现在输出层设计,以及从模型输出中提取哪些表示进行预测。
下面分别介绍 BERT 在四类典型任务中的微调方式:
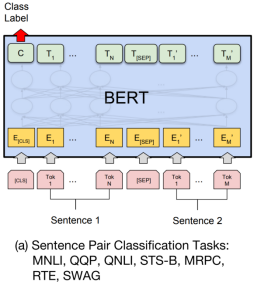
(a) 句子对分类任务
输入格式:[CLS] 句子1 [SEP] 句子2 [SEP]
输出方式:使用 [CLS] 的输出向量接入线性层进行分类,用于判断两个句子之间是否存在重复、蕴含、矛盾等关系。
注:
- MNLI:Multi-Genre Natural Language Inference,多类别句子蕴含判断
- QQP: Quora Question Pairs,问句语义重复判断
- QNLI: Question Natural Language Inference ,判断句子是否为问题的答案
- STX-B: Semantic Textual Similarity Benchmark,语义相似度回归
- MRPC: Microsoft Research Paraphrase Corpus,句子复述判断
- RTE: Recognizing Textual Entailment,二分类蕴含判断
- SWAG: Situations With Adversarial Generations,多项选择填句任务
(b) 单句分类任务
输入格式:[CLS] 句子 [SEP]
输出方式:同样使用 [CLS] 的输出向量,经过线性层用于情感极性判断、语法可接受性判断等。
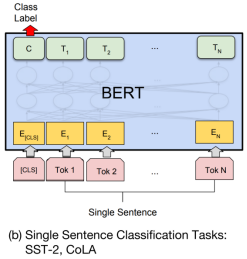
注:
- SST-2: Stanford Sentiment Treebank (binary),情感极性判断(二分类)
- CoLA: Corpus of Linguistic Acceptability,语法可接受性判断(二分类)
(c) 问答任务
输入格式:[CLS] 问题 [SEP] 段落 [SEP]
输出方式: 模型不会使用 [CLS] 向量,而是对每个 token 分别预测其作为答案起始位置和结束位置的概率。最终根据得分确定答案在段落中的位置范围,从中直接抽取连续的答案文本。
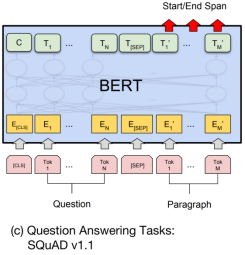
注:
- SQuAD v1.1:Stanford Question Answering Dataset 抽取式问答(起止定位)
(d) 序列标注任务
输入格式:[CLS] 句子 [SEP]
输出方式:对每个 token 的输出向量单独进行分类,例如判断是否为人名(B-PER)、地名(B-LOC)等。
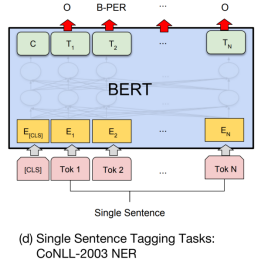
注:
NER:Named Entity Recognition,命名实体识别











请登录后查看评论内容