

- 概述
T5(Text-to-Text Transfer Transformer)是 Google Research 于 2020 年提出的一种统一预训练框架,它首次在完整的 Transformer 编码器-解码器结构(Encoder-Decoder)上实现了预训练语言模型。
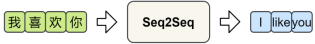
T5的核心思想是将所有自然语言处理任务统一表示为“文本到文本”的转换问题(Text-to-Text Framework),即无论输入是文本分类、问答还是翻译,模型的输入输出均是自然语言形式的字符串,如下图所示:
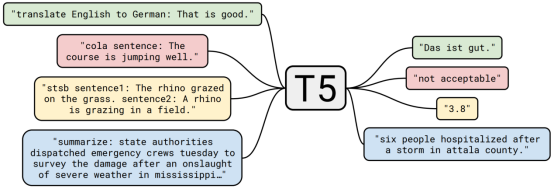
这一设计使得T5可以通过同一个模型架构、同一套预训练机制完成多种任务,具备极强的统一性与迁移能力。
2.模型结构
T5模型大体遵循原始的Transformer架构,此处不再赘述。
3.预训练
T5模型的预训练目标被称为Corrupted span prediction,具体过程如下:
1)随机遮盖输入文本中的若干连续片段(span);将每个被遮盖的连续片段替换为一个个特殊token;令模型学习生成这些遮盖片段的内容,作为输出序列。
如下图所示:
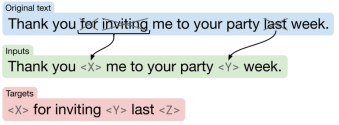
这种方式既保留了模型的双向建模能力,又为训练提供了明确的“生成式”学习信号,使模型可以更自然的适配下游任务。
4.微调
T5微调阶段需要将所有任务转换为文本到文本的形式,例如:
| 任务类型 | 输入形式 | 目标输出 |
| 翻译 | translate English to German: That is good. | Das ist gut. |
| 情感分类 | sentiment: This movie was great. | positive |
| 问答 | question: What is the capital of France? context: France is a country… | Paris |
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容