

7.5.1 需求说明
本案例要求使用Transformer模型实现上述中英翻译任务。
7.5.2 需求分析
PyTorch 已提供了 nn.Transformer 模块,包含完整的编码器-解码器结构,因此我们可以直接使用其核心组件来搭建模型。
然而,PyTorch 并未内置位置编码(Positional Encoding)模块,而 Transformer 又不具备处理位置信息的能力,因此我们需要手动实现位置编码,并与嵌入层输出相加,作为 Transformer 的输入。
除此之外,还需要完成以下模块:
- 源语言和目标语言的词嵌入层(nn.Embedding)
- 输出层(nn.Linear)用于将模型输出映射为目标词表大小
7.5.3 需求实现
1)项目结构
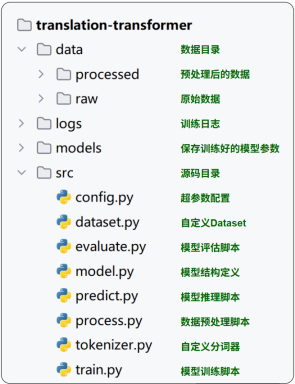
2)完整代码
(1)数据预处理
# process.py

import pandas as pd
from sklearn.model_selection import train_test_split
from tokenizer import ChineseTokenizer, EnglishTokenizer
import config

def process():
    """
    数据预处理主函数。
    """
    print('开始处理数据')

    df = pd.read_csv(
        config.RAW_DATA_DIR / 'cmn.txt',
        sep='\t',
        header=None,
        usecols=[0, 1],
        names=['en', 'zh']
    )

    df = df.dropna()
    df = df[df['en'].str.strip().ne('') & df['zh'].str.strip().ne('')]

    train_df, test_df = train_test_split(df, test_size=0.2, random_state=42)

    EnglishTokenizer.build_vocab(train_df['en'].tolist(), config.PROCESSED_DATA_DIR / 'en_vocab.txt')
    ChineseTokenizer.build_vocab(train_df['zh'].tolist(), config.PROCESSED_DATA_DIR / 'zh_vocab.txt')

    en_tokenizer = EnglishTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'en_vocab.txt')
    zh_tokenizer = ChineseTokenizer.from_vocab(config.PROCESSED_DATA_DIR / 'zh_vocab.txt')

    train_df['en'] = train_df['en'].apply(
        lambda x: en_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=True)
    )
    train_df['zh'] = train_df['zh'].apply(
        lambda x: zh_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=False)
    )
    train_df.to_json(config.PROCESSED_DATA_DIR / 'indexed_train.jsonl', orient='records', lines=True)

    test_df['en'] = test_df['en'].apply(
        lambda x: en_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=True)
    )
    test_df['zh'] = test_df['zh'].apply(
        lambda x: zh_tokenizer.encode(x, seq_len=config.SEQ_LEN, add_sos_eos=False)
    )
    test_df.to_json(config.PROCESSED_DATA_DIR / 'indexed_test.jsonl', orient='records', lines=True)

    print('数据处理完成')

if __name__ == '__main__':
    process()
(2)自定义分词器
# tokenizer.py

from abc import abstractmethod
from nltk import word_tokenize, TreebankWordDetokenizer
from tqdm import tqdm

class BaseTokenizer:
    """
    分词器基类。
    """
    unk_token = '<unk>'
    pad_token = '<pad>'
    sos_token = '<sos>'
    eos_token = '<eos>'

    @staticmethod
    @abstractmethod
    def tokenize(sentence):
        pass

    @abstractmethod
    def decode(self, indexes):
        pass

    @classmethod
    def build_vocab(cls, sentences, vocab_file):
        """
        构建词表并保存。

        :param sentences: 句子列表。
        :param vocab_file: 保存文件路径。
        """
        unique_words = set()
        for sentence in tqdm(sentences, desc='分词'):
            for word in cls.tokenize(sentence):
                unique_words.add(word)

        vocab_list = [cls.pad_token, cls.unk_token, cls.sos_token, cls.eos_token] + list(unique_words)
        with open(vocab_file, 'w', encoding='utf-8') as f:
            for word in vocab_list:
                f.write(word + '\n')

    def __init__(self, vocab_list):
        self.vocab_list = vocab_list
        self.vocab_size = len(vocab_list)
        self.word2index = {word: i for i, word in enumerate(vocab_list)}
        self.index2word = {i: word for i, word in enumerate(vocab_list)}
        self.unk_token_index = self.word2index[self.unk_token]
        self.pad_token_index = self.word2index[self.pad_token]
        self.sos_token_index = self.word2index[self.sos_token]
        self.eos_token_index = self.word2index[self.eos_token]

    @classmethod
    def from_vocab(cls, vocab_file):
        with open(vocab_file, 'r', encoding='utf-8') as f:
            vocab_list = [line.strip() for line in f.readlines()]
        return cls(vocab_list)

    def encode(self, sentence, seq_len, add_sos_eos=False):
        tokens = self.tokenize(sentence)
        indexes = [self.word2index.get(token, self.unk_token_index) for token in tokens]
        if add_sos_eos:
            indexes = indexes[:seq_len - 2]
            indexes = [self.sos_token_index] + indexes + [self.eos_token_index]
        else:
            indexes = indexes[:seq_len]
        if len(indexes) < seq_len:
            indexes += [self.pad_token_index] * (seq_len - len(indexes))
        return indexes

class ChineseTokenizer(BaseTokenizer):
    @staticmethod
    def tokenize(sentence):
        return list(sentence)

    def decode(self, indexes):
        return ''.join([self.index2word[i] for i in indexes])

class EnglishTokenizer(BaseTokenizer):
    @staticmethod
    def tokenize(sentence):
        return word_tokenize(sentence)

    def decode(self, indexes):
        tokens = [self.index2word[i] for i in indexes]
        return TreebankWordDetokenizer().detokenize(tokens)
(3)自定义数据集
(4)模型定义
(5)模型训练
(6)模型预测
(7)模型评估
(8)配置文件
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容