



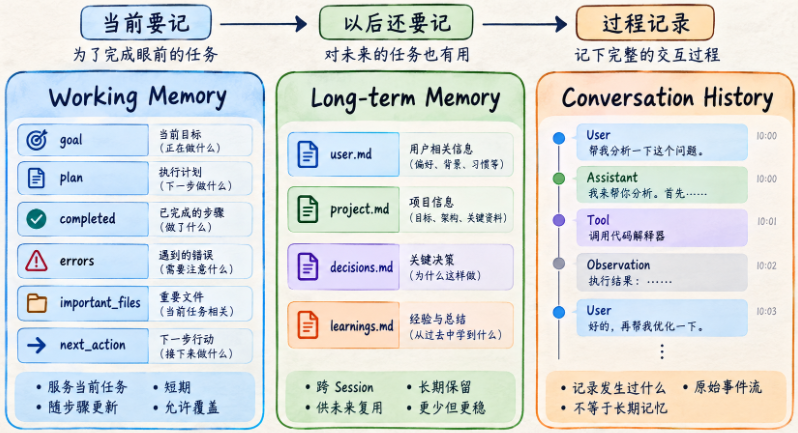
小节一:Long-term Memory 和 Working Memory 到底差在哪——“当前要记”与“以后还要记”不是一回事
先别急着往下看代码,咱们先把这三个容易混在一起的概念摆平。下面这张图把 Working Memory、Long-term Memory、Conversation History 放到了一起,对照着看会更直观。 你可以把它简单理解成...

小节二:先用文件系统设计四类 Memory——user、project、decisions、learnings 各自放什么
这一小节最适合先看一眼全貌。四类文件虽然都叫 Memory,但职责完全不同,别把偏好、事实、决策、经验一股脑塞进同一个文件里。 这张图其实回答了一个很常见的问题:为什么长期记忆要拆文件?&n...
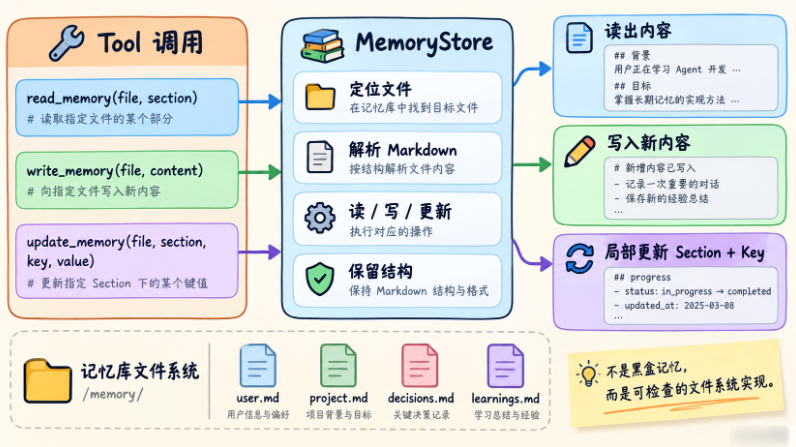
小节三:实现 read_memory、write_memory、update_memory——让 Agent 真正能读写长期记忆
把概念讲清楚以后,真正落地就要靠工具了。下面这张图把 read_memory、write_memory、update_memory 和 MemoryStore 的关系串起来了,大家可以先建立一个整体印象。 换句话说,这里不是搞一...
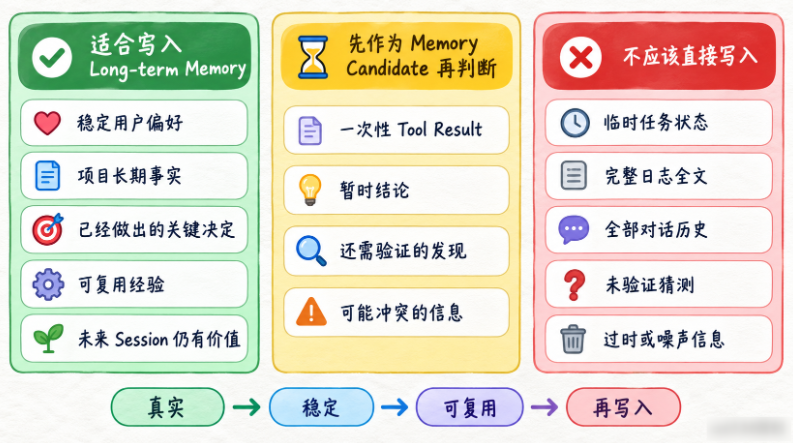
小节四:什么值得长期保存,什么不应该——记忆系统最大的风险不是“忘”,而是“记错”
到了这里,重点就从“怎么存”切到“该不该存”了。长期记忆最怕的并不是少记一点,而是把不该记的东西写进去,后面还一直当真。先看下面这张判断图,思路会清楚很多。 可以把它理解成一个很朴...
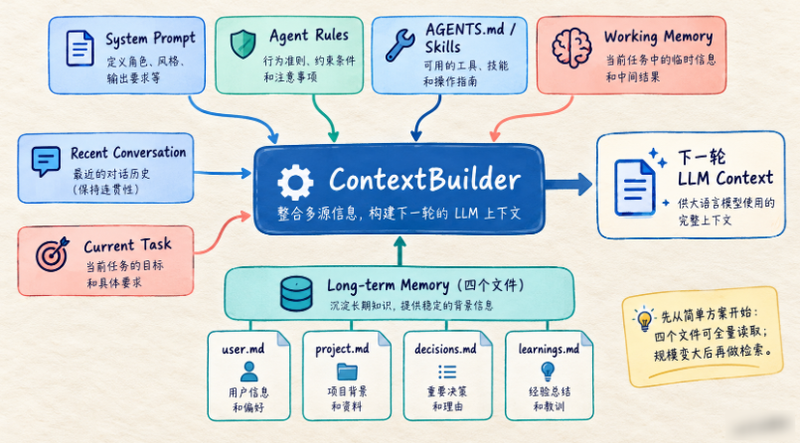
小节五:把 Long-term Memory 接回 ContextBuilder——不是每次全量加载,而是先从简单方案开始
前面把长期记忆存下来了,真正发挥作用还得接回上下文构建阶段。也就是说,记忆不是躺在文件里好看,而是要在下一轮推理时重新被取回来。结合下面这张图,这个位置就很好理解了。 你可以把 ...

案例分析二:Data Analysis Agent 如何把“业务口径”记到明天,而不是每次重新问?
这个场景在数据分析里也非常典型。很多口径不是一次性条件,而是一个项目里长期共用的业务规则。 这里最值得注意的一点是:先判断这条信息究竟属于“个人偏好”还是“项目规则”。如果是大家在...
章末自测
题目 1:Working Memory 和 Long-term Memory 最大的区别是什么? 请分别从生命周期、内容类型、更新频率和典型字段四个角度说明,并举一个 Coding Agent 例子。 Working Memory 服务当前 Run ...
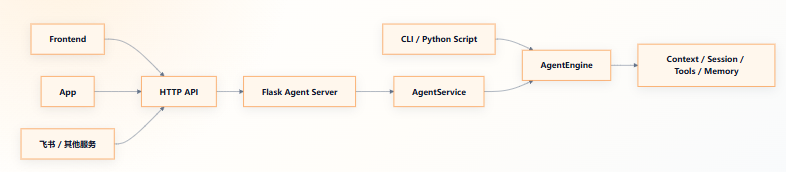
第4部分:Python + Flask 服务化 为什么 Agent 不能永远运行在 Python 脚本里?
到上一部分结束,我们已经把 Agent Harness 最核心的一大块能力搭出来了。 现在这个 Agent 已经不再只是一个最小 while True Demo,而是已经拥有: Main Loop Agent State LLM Provid...
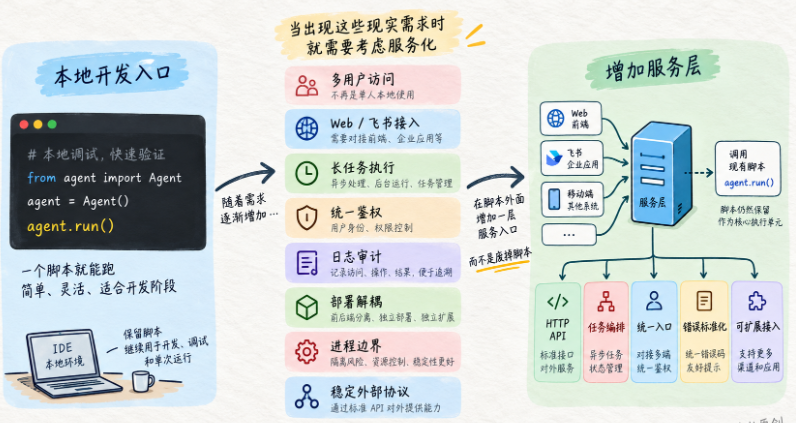
小节一:从 agent.run() 出发,哪些接入需求值得增加服务层?
这一部分先配一张总览图会更直观。左边是本地开发阶段直接跑 agent.run() 的方式,中间把真正推动服务化的现实需求列了出来,右边则是增加服务层之后,入口、编排、错误标准化和可扩展接入如...
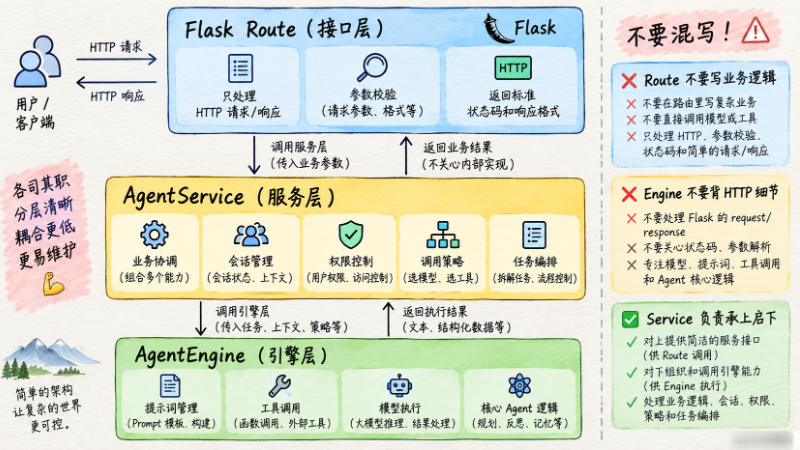
小节二:Flask Route、AgentService、AgentEngine 为什么必须分层?
先别急着看代码,先把分层关系在脑子里建立起来。下面这张图把三层结构拆得很细:最上层 Flask Route 只处理 HTTP 请求与响应,中间 AgentService 负责业务协调、会话、权限和任务编排,最下层 ...

