


这个场景在数据分析里也非常典型。很多口径不是一次性条件,而是一个项目里长期共用的业务规则。
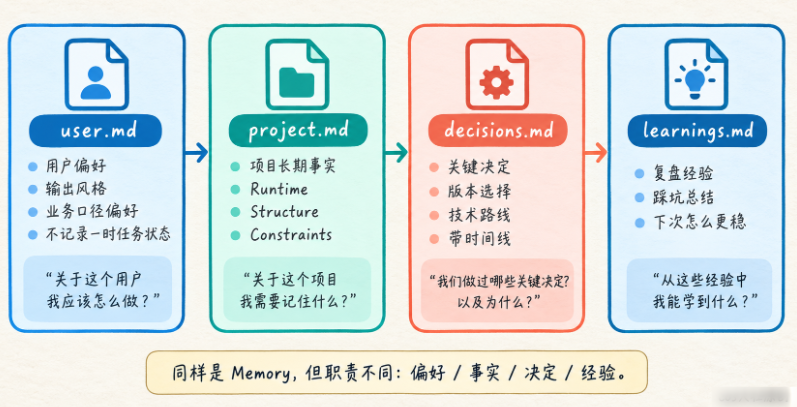
这里最值得注意的一点是:先判断这条信息究竟属于“个人偏好”还是“项目规则”。如果是大家在同一个项目里都要遵循的分析口径,那它更应该进入 project.md,而不是 user.md。一旦这个边界分清了,后面每次新 Session 进来,Agent 都能直接按约定口径开展分析,自然也就不用重复追问。
场景背景
用户分析广告收入时明确说明,“我们内部默认收入都看 mt_income,除非我特别说明,不用 gross_income。”
这不是一次查询条件。
而是长期业务口径。
如果 Agent 每个 Session 都忘记,就会反复问,“你说的收入是 gross_income 还是 mt_income?”
写入 user.md 还是 project.md?
如果这是:
这个用户个人偏好可以放 user.md。
如果这是:
整个项目 / 团队统一业务口径更适合 project.md。
假设这里属于项目规则。
写入:
## Metric Conventions

- 默认收入指标:mt_income
- 仅在用户明确要求时使用 gross_income
第二天新 Session
用户,“看看昨天收入为什么降了。”
Agent读取 Project Memory 后,默认查询:
mt_income不需要重新澄清。
什么时候应该更新?
如果后来用户明确说,“以后统一切 gross_income。”
那就:
update_memory更新当前口径。
并在:
decisions.md记录切换原因。
复盘
这个案例说明 Long-term Memory 不只是“记住聊天内容”。
它更重要的价值是,把长期业务语义、规则和决策变成 Agent 的稳定背景。
迁移
类似长期记忆还可以保存:
默认时间范围
统一指标口径
常用维度名称
项目表白名单
团队约定测试命令
部署环境限制
只要它们是稳定、明确、未来仍然会影响决策的信息。
常见误区
误解: 有了 Long-term Memory,就可以把所有历史都永久保存,以后模型想知道什么都能找。
正解: 长期记忆最大的风险不是“记得少”,而是“记得太多、太杂、甚至记错”。完整历史可以保存在 Session Store 或 Trace,Long-term Memory 应只保留未来仍然会影响行为的稳定事实、偏好、决策和经验。它是精炼知识层,不是归档仓库。
误解: Working Memory 和 Long-term Memory 只是存储时间长短不同,可以直接用同一份结构。
正解: Working Memory 保存 Goal、Plan、Errors、Next Action 等当前任务状态,频繁更新、任务结束后大部分可以丢弃;Long-term Memory 保存跨 Session 仍然有价值的信息,例如项目运行版本、用户长期偏好和架构决策。两者字段、更新频率和可信度要求都不同,最好分开管理。
误解: 一开始就应该使用向量数据库,否则 Memory 不够高级。
正解: 向量数据库解决的是“海量 Memory 怎么检索”的问题,不解决“什么值得记、记忆是否正确、怎么更新冲突”这些更根本的问题。课程先用 Markdown 文件,是为了让每条 Memory 都可读、可审计、可修改。等内容规模真的变大,再引入 Embedding 和 Vector DB 更合理。
误解: Agent 一旦形成一个结论,就可以自动写进 Long-term Memory。
正解: 许多结论只是临时假设。比如“入口可能是 app.py”如果没有验证就永久写入,第二天会持续误导 Agent。更稳的做法是建立 Memory Write Policy:用户明确长期偏好、稳定项目事实、已确认重要决策和经过验证的经验才写;猜测、一次性错误和临时计划默认不写。
误解: write_memory 只需要 append,永远不用 update。
正解: 长期事实会变化。如果 project.md 已写“入口 app.py”,后来项目重构为“src/main.py”,继续 append 会形成冲突。当前事实应该用 update_memory 更新;如果这个变化本身是重要决策,再额外写到 decisions.md 保存历史原因。Memory 必须能维护“当前真相”,而不是只会堆积旧信息。
误解: Long-term Memory 只要保存在文件里,就应该每轮全量加入 Context。
正解: 文件系统只是存储方式,不代表每轮都需要把全部内容发送给模型。Memory 小时全量读取没问题;规模扩大后,应按任务相关性检索。最终仍然要遵守 Context Budget。Storage 可以很大,当前 Context 仍然应该只放真正相关的信息。
误解: Memory 是系统自己保存的,所以取回后可以直接当成 System Prompt。
正解: 记忆可能来自历史用户输入、网页、Tool Result 或模型总结,其中都可能有过期信息和指令注入文本。检索结果应该作为低权限历史数据进入 Context,并明确标注“不是指令”;关键决定还要回查来源。相关性分数只回答“像不像当前问题”,不回答“是不是真”。
误解: 给每个用户建一个目录,就已经完成用户隔离。
正解: 目录或 scope_id 只是存储分区,不是授权。服务层仍要校验当前身份是否能访问这个用户或项目作用域;检索前先过滤作用域,写入、更新和删除还要进入审计。否则只要传入别人的 ID,仍可能读到不属于自己的记忆。
误解: 用户纠正偏好后,再追加一条新偏好就够了。
正解: 旧记录、检索索引、缓存摘要和已经构建的 Context 都可能继续返回旧偏好。更新时要让旧值失效,删除时要清理衍生副本;并发更新则用版本号发现冲突,不能让最后一次写入静默覆盖新证据。















请登录后查看评论内容