

这一部分先配一张总览图会更直观。左边是本地开发阶段直接跑 agent.run() 的方式,中间把真正推动服务化的现实需求列了出来,右边则是增加服务层之后,入口、编排、错误标准化和可扩展接入如何自然形成一条完整链路。
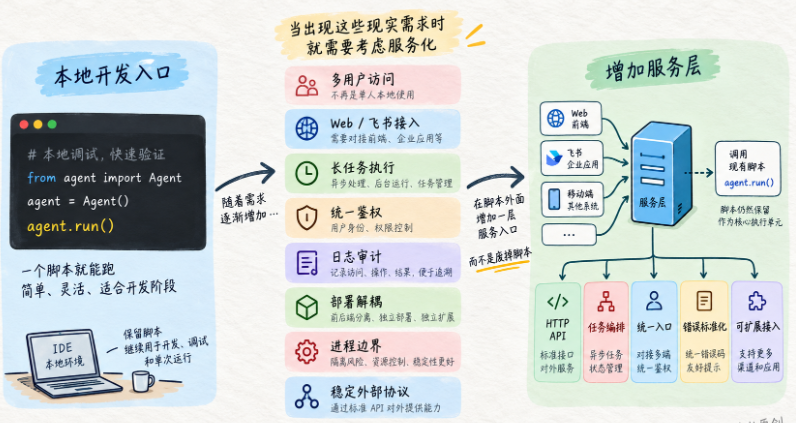
这张图最核心的一点不是“脚本不行”,而是脚本适合开发入口,服务层适合对外入口。也就是说,随着多用户访问、Web/飞书接入、长任务执行和统一鉴权这些需求出现,你不是把原来的脚本废掉,而是在它外面增加一层更稳定的服务边界。
我们从最直接的调用方式开始。
假设核心 Engine:
class AgentEngine:

    def run(
        self,
        task: str,
    ) -> str:
        ...
内部调用非常舒服。
但它天然假设,调用方已经进入当前 Python 进程。
这对于真实产品有几个限制。
调用方必须共享 Python 运行环境
如果调用者是:
React 前端
iOS App
Android App
Java 服务
Go 服务
飞书 Bot
显然不能要求它们都安装你的 Python 项目,然后:
import agent_engineHTTP API 把这一层解耦掉。
调用方只需要知道:
URL
HTTP Method
Request Schema
Response Schema
至于 Agent 内部使用 Python、什么模型、几个 Tool,对外都可以隐藏。
脚本没有稳定的外部协议
最开始:
agent.run(
    "分析这个项目"
)
一个字符串就够。
但真实接口很快会需要:
session_id
message
workspace
metadata
stream
user
响应也不会永远只是字符串。
可能变成:
{
  "session_id": "sess_xxx",
  "run_id": "run_xxx",
  "status": "COMPLETED",
  "answer": "..."
}
有了 API Contract,客户端才能稳定接入。
跨过进程边界以后,参数也不能再是任意 Python 对象。Path、异常对象、数据库连接和自定义类实例都不能自然变成 JSON。Service 应该接收明确的数据结构,并返回可序列化结果;内部 Exception 则映射成稳定错误码,而不是把 traceback 原样送给客户端。
这一步看似只是“换成 JSON”,实际上是在定义兼容承诺。字段是否必填、空字符串是否允许、未知字段怎么处理、时间和状态用什么格式,都要由服务端和客户端共同遵守。
多个入口不应该复制 Agent
这一段很适合结合架构图一起看。图里把 CLI、Web、飞书机器人、定时任务以及其他系统都放到了一起,但它们并不是各自维护一套 Agent,而是通过统一的 AgentService / API 去复用同一个 AgentEngine。
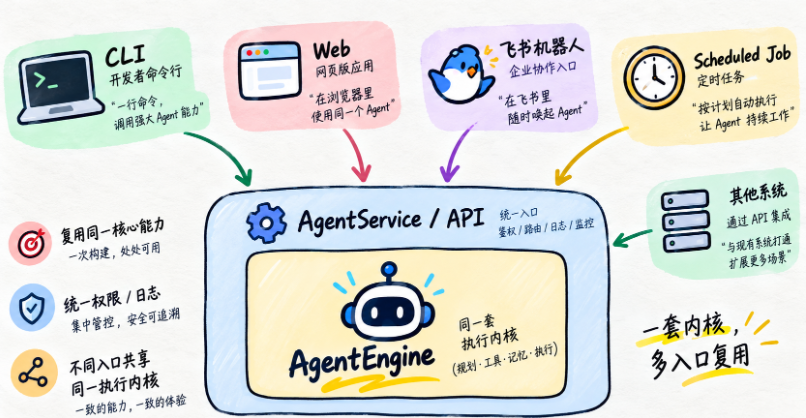
这样设计的好处很直接:同一套核心能力只维护一次,不同入口共享统一权限、日志、监控和调用方式。说白了,复用的是执行内核,不是复制一堆实现,后面扩展新入口时会轻松很多。
如果没有统一服务,你可能写:
web_agent.py
feishu_agent.py
cron_agent.py
internal_agent.py
一开始只是入口不同。
过几个月就可能:
Web 用新 Prompt
飞书少注册了一个 Tool
Cron 还在旧 Provider
内部服务没有新的安全规则
真正好的方式是:
Web -------┐
App -------┤
飞书 ------┼→ Agent Server → AgentEngine
Other -----┘
核心逻辑只有一份。
本地脚本不天然适合长任务
一个 Agent Run 可能执行:
20 秒
60 秒
5 分钟
终端里等待没问题。
但 HTTP 客户端需要知道:
任务是否还在跑
是否失败
是否超时
目前做到哪一步
所以后面会出现:
run_id
status
streaming
这些都不是普通 agent.run() 返回字符串能解决的。
还要注意,HTTP 连接的生命周期不等于 Agent Run 的生命周期。用户关掉页面、代理超时,甚至移动网络断开,都不必然表示任务应该被取消。更稳的做法是先创建独立的 run_id,再由客户端查询或订阅它;是否取消必须有明确动作和状态,而不是根据连接断开来猜。
多用户以后,内存边界也会变化
这个地方很多同学在本地测试时不容易踩坑,但一上线就会出问题。下面这张图把“单 Worker 本地开发”和“多 Worker 上线部署”的差别画得很清楚:本地时所有请求都落在同一个进程里,Session 像是能正常工作;可一旦多进程部署,请求被分发到不同 Worker,进程内内存就不再共享了。
所以这里真正该记住的不是“Session 失效很玄学”,而是进程内状态只在当前进程内成立。只要进入多 Worker 场景,就要把 Session 等共享状态放到 Redis、数据库或其他外部存储里,不然状态丢失和不一致几乎是早晚的事。
本地时你只有一个人。
服务化后:
User A
User B
User C
可能同时调用。
他们的:
Session
Working Memory
Tool History
Workspace
Long-term Memory
必须严格隔离。
这也是为什么我们前面提前把 Session 和 Memory 设计成独立组件。
本地 Demo 常把 SessionManager 放在模块全局变量里,这在单进程下看不出问题。一旦生产服务器启动多个 Worker,User A 的第二次请求可能落到另一个进程,而那个进程看不到第一个进程的内存。需要跨请求、跨 Worker、跨重启保留的状态,最终要落到共享存储;进程内缓存只能是加速层,不能悄悄成为唯一事实来源。
结论:不是废掉脚本,而是增加入口
真正推荐的是:
CLI --------┐
HTTP -------┤
Cron -------┼→ AgentService → AgentEngine
Feishu -----┘
CLI 继续保留。
HTTP 只是新增一个对外 Adapter。
这很重要,因为以后调试 Agent 时,CLI 往往仍然是最快路径。















请登录后查看评论内容