



4. 模型选择与构建
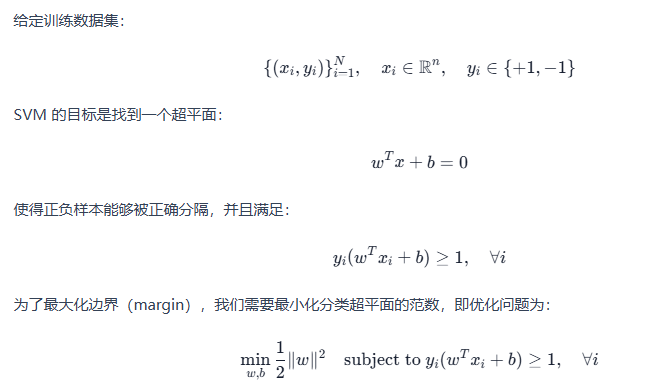
我们需要构建一个既能处理高维稀疏文本数据,又能具备较好泛化能力的分类模型。 经过对数据特点的分析,我们选择 支持向量机(Support Vector Machine, SVM) 作为主要模型,具体原因...
5.3 参数初始化
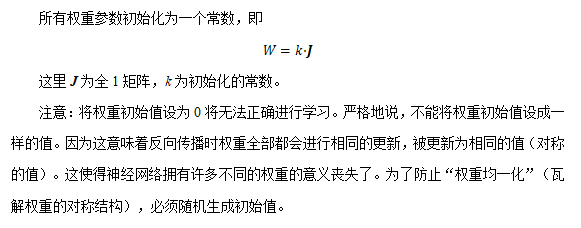
参数初始化方案的选择在神经网络学习中起着举足轻重的作用,它对保持数值稳定性至关重要。此外,这些初始化方案的选择可以与激活函数的选择有趣的结合在一起。我们选择哪个激活函数以及如何初始...
3. 特征工程
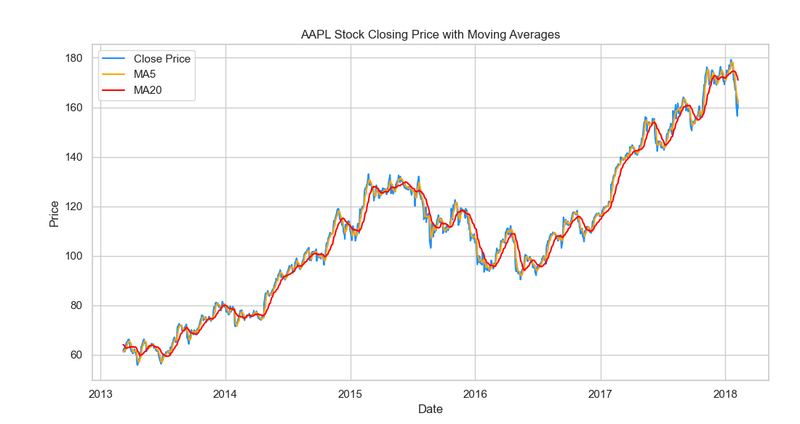
在数据探索后,我们需要进行特征工程,目的是选择合适的特征,并构造新的特征,以便后续的机器学习模型能更好地学习股票价格的变化规律。 3.1 特征选择 我们从原始数据中提取以下特征: 基本价...
5. 模型训练与评估
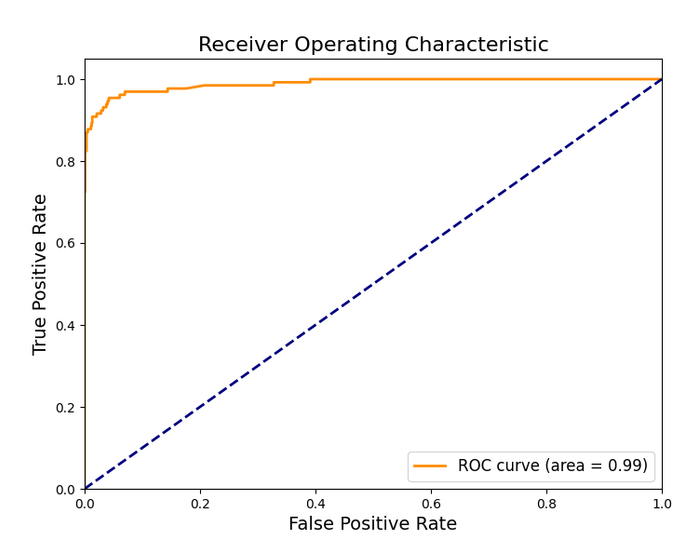
在这一部分,我们将详细介绍如何使用 Python(基于 sklearn)训练 SVM 模型,并评估其性能。 步骤包括: 模型训练 利用网格搜索(Grid Search)对超参数(如正则化参数 C 以及最大迭代次数 max_...
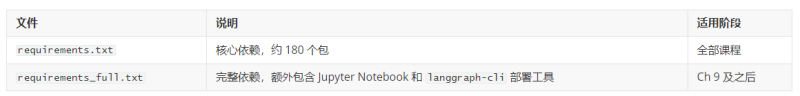
5. 安装课程依赖
课程提供了两个依赖文件,均位于 2.资料/ 目录下: 5.1 安装核心依赖 # 确保已激活 langgraph 环境 conda activate langgraph # 进入项目根目录 cd 课程目录/langgraph # 安装核心依赖 pip inst...
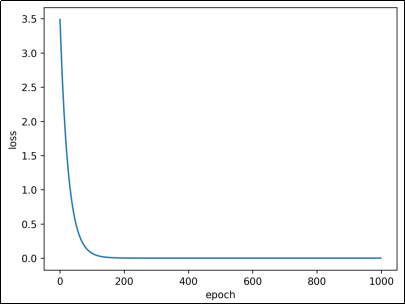
6.11 机器学习案例:线性回归
在此虚拟环境中没有matplotlib,先安装:pip install matplotlib==3.9。 通过PyTorch训练一个模型一般分为以下4个步骤: 准备数据 → 构建模型 → 定义损失函数与优化器 → 模型训练 接下来,构...
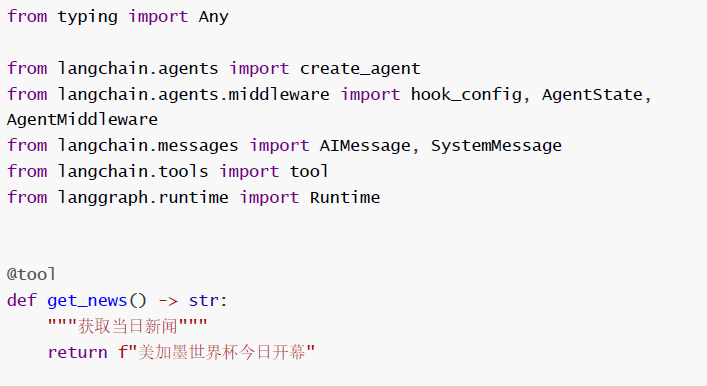
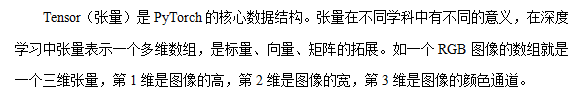
6.3 张量创建
6.3.1 基本张量创建 1.torch.tensor(data)创建指定内容的张量 import torch import numpy as np # 创建标量张量 tensor1 = torch.tensor(10) print(tensor1) # 使用列表创建张量 tensor2 = torc...
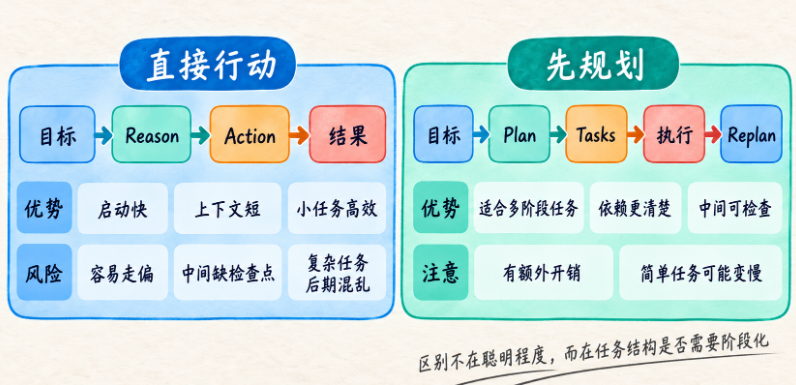
小节三:实现一个简单 Planner——输出 Task,而不是输出“漂亮但没法执行”的大纲
很多 Planner 的实现,问题不在“不会规划”,而在“只会说得很好听”。说白了,就是输出一个漂亮大纲,但落不到执行层。下面这张图把这个问题讲得很直白:左边是不够用的泛化大纲,右边才是一...
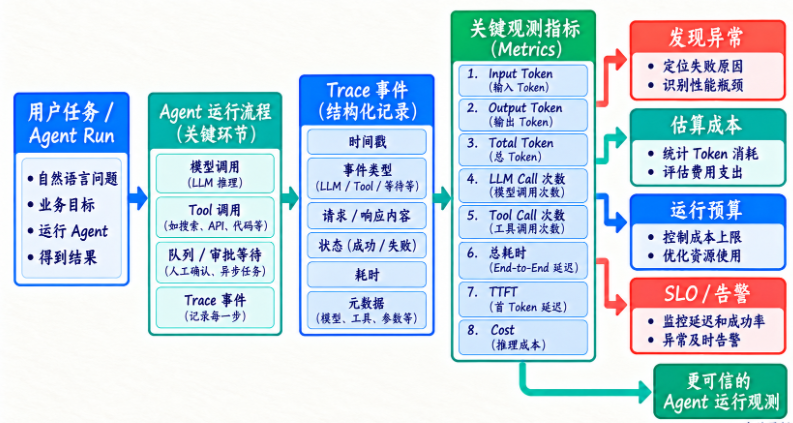
Token、成本与耗时监控
上一节,我们已经用 Trace 把一次 Run 里的 Prompt、模型响应、Tool Call、Observation 和状态变化记录下来。但“能够复盘”还不等于“能够比较”:如果不把这些事件进一步聚合成 Token、Latenc...

