

上一节,我们已经用 Trace 把一次 Run 里的 Prompt、模型响应、Tool Call、Observation 和状态变化记录下来。但“能够复盘”还不等于“能够比较”:如果不把这些事件进一步聚合成 Token、Latency、Cost 和调用次数,我们仍然不知道任务为什么突然变慢、变贵,或者是否出现了重复工作。
这一节就沿着 Trace 继续往前走,把运行记录转换成可以统计、比较和告警的 AgentOps 指标。
为什么要监控 Agent 的资源消耗
先把这一章的主线放在脑子里,后面很多指标就不容易看乱。你会发现,Agent 的观测并不是“记几个数字”这么简单,而是从一次任务开始,一路经过运行过程、Trace 事件、指标聚合,最后再回到异常定位、成本估算、SLO 和预算控制。把这条链路看顺了,后面每个字段为什么要记、每个指标为什么要拆,就都比较顺手了。
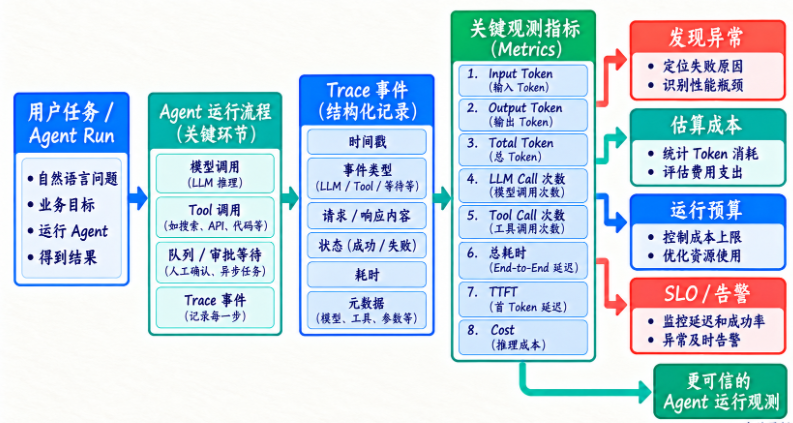
上面这张图更像是本章的总览版。顺着看一遍就会明白:Token、Latency、Cost、LLM Call、Tool Call 这些指标不是凭空出现的,它们都来自 Trace 里的结构化事件;而这些数字最终也不是为了“报表好看”,而是要服务于异常发现、运行预算和治理动作。
Agent 不像普通函数只执行一次。它可能连续调用模型、读取文件、运行命令、重试失败操作,再把越来越长的上下文重新发给模型。如果只看最终答案,就无法知道任务为什么变慢、变贵,或者在什么时候开始重复工作。
Observability 的下一步不是“收集更多日志”,而是把 Trace 转换成可以比较的指标:
Input Token
Output Token
Total Token
LLM Call 次数
Tool Call 次数
总耗时
平均 Step 耗时
估算成本
这些数字看起来不复杂,真正容易出错的是“每个数字究竟从哪来”。我们先定一条计量契约:一次真实模型调用只有一个 llm_call_id,usage 只记在这个调用的终态事件上;Tool 通过 parent_event_id 或调用 ID 关联,不复制模型用量。重试是又一次真实调用,应该拥有新 ID,不能因为 Prompt 一样就把它去重掉。
一、从事件记录中提取指标
这一部分最容易踩坑的地方,是把“原始事件”和“最终结算事件”混在一起。实际做聚合时,通常要先把事件分流,再只挑真正适合结算的终态事件来统计,否则调用次数、费用和耗时很容易被重复算一遍。
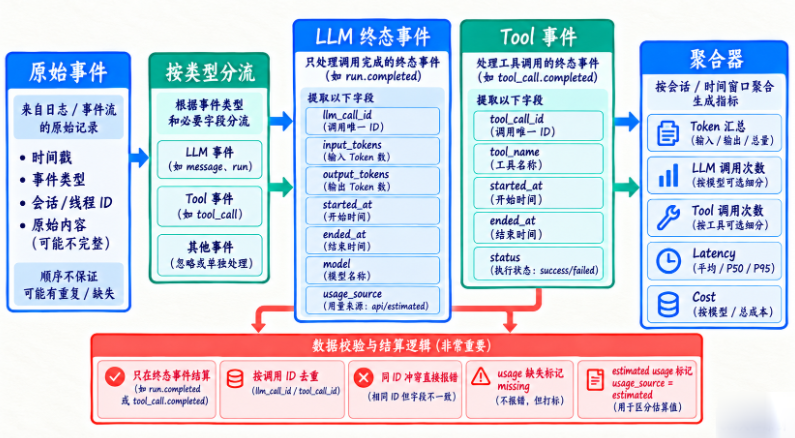
这张图把思路拆得比较细:左边是原始事件,中间是 LLM 与 Tool 的终态事件,右边才是最终聚合出来的指标。底部那一条红色校验逻辑也很关键,像“按调用 ID 去重”“同 ID 冲突直接报错”“usage 缺失要打标”,都直接决定了后面这份账本到底可信不可信。
每个 LLM 调用至少应保存 llm_call_id、input_tokens、output_tokens、started_at、ended_at、model 和 usage_source;每个 Tool 调用至少应保存 tool_call_id、tool_name、started_at、ended_at 与 status。在 Run 结束时,可以先用一个最小版本感受聚合过程:
def summarize_run(steps):
    llm_steps = [
        s for s in steps
        if s["event_type"] == "llm" and s["status"] in {"completed", "failed"}
    ]
    tool_steps = [
        s for s in steps
        if s["event_type"] == "tool" and s["status"] in {"completed", "failed"}
    ]

    input_tokens = sum(s.get("input_tokens", 0) for s in llm_steps)
    output_tokens = sum(s.get("output_tokens", 0) for s in llm_steps)
    return {
        "input_tokens": input_tokens,
        "output_tokens": output_tokens,
        "total_tokens": input_tokens + output_tokens,
        "llm_calls": len(llm_steps),
        "tool_calls": len(tool_steps),
        "step_count": len({s["step_no"] for s in steps if s["step_no"] > 0}),
    }
这段代码还只适合单一终态事件的入门记录。如果采集系统可能重投事件,要先按调用 ID 去重,并在同 ID 的数据冲突时报错,不能随手保留其中一条。后面的完整例子会把这一层补上。
不要把“模型返回的 Token”与“本地估算的 Token”混为一谈。Provider 返回的 usage 应作为费用估算的优先依据;在响应没有 usage 时,我们可以保留本地估算,但必须标记 usage_source=estimated 和误差范围。如果连估算都没有,就记为 missing,不能把缺失值包装成“零消耗”。
还有一个细节很值得提前说清:Token 的分词规则、推理 Token 的归属、缓存读写的字段都可能因 Provider 而异。Harness 内部要保留一份统一口径,同时留下 Provider 的原始 usage 作为可追溯证据。本地 tokenizer 适合做调用前预算,不适合冒充最终账单。
二、计算一次任务的成本
成本这块表面上像小学四则运算,实际真正难的是口径统一。尤其是一旦引入缓存输入、不同输入输出单价、价格版本这些因素,如果脑子里没有一张结构图,算着算着就会把历史任务和最新价格混在一起。
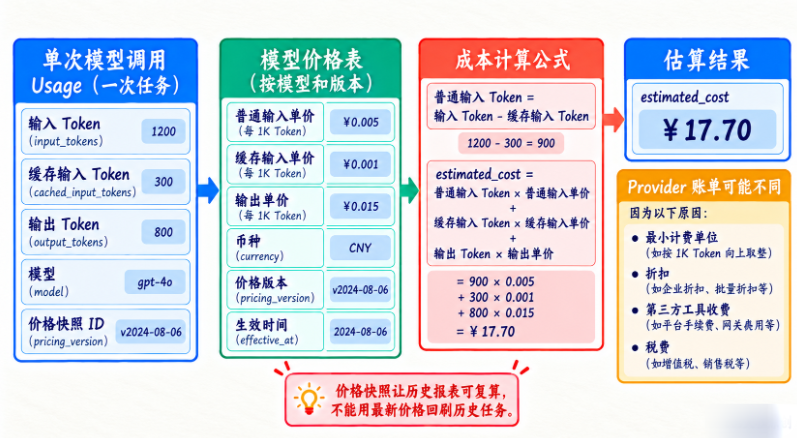
这张图先从一次模型调用的 usage 出发,再接到模型价格表,最后落到估算公式和结果上。比较值得留意的是最下面那句提醒:价格快照不是装饰,它的意义是让历史报表可以复算,不会因为今天调价,就把昨天的任务费用“回刷”成新的数字。
不同模型的输入和输出单价通常不同,因此成本不能只用总 Token 乘一个单价。更可靠的做法是把模型、输入 Token、输出 Token 和价格表一起保存:
def estimate_cost(input_tokens, output_tokens, input_price, output_price):
    return (
        input_tokens / 1_000_000 * input_price
        + output_tokens / 1_000_000 * output_price
    )
在真实系统中还应记录 pricing_version、币种和价格生效时间。这样价格调整后,历史 Run 仍然可以按当时的价格复算,而不是因为全局配置变化导致历史报表漂移。
更稳妥的做法是在调用完成时保存“用量事实 + 价格快照 ID”,计算结果则标成 estimated_cost。它与 Provider 最终对账单上的金额可能不完全相同:最小计费单位、免费额度、批处理折扣、第三方 Tool 收费和税费都可能不在 Token 公式里。监控数字用于运行决策,正式结算仍以账单为准。
三、把耗时拆开看
讲耗时时,很多同学最容易把“用户等了多久”和“系统真正干了多久”混成一个数。可一旦任务里有排队、流式输出、审批等待或者并发 Tool,这几个概念就必须分开,不然报表看起来清楚,实际解释问题时会非常混乱。
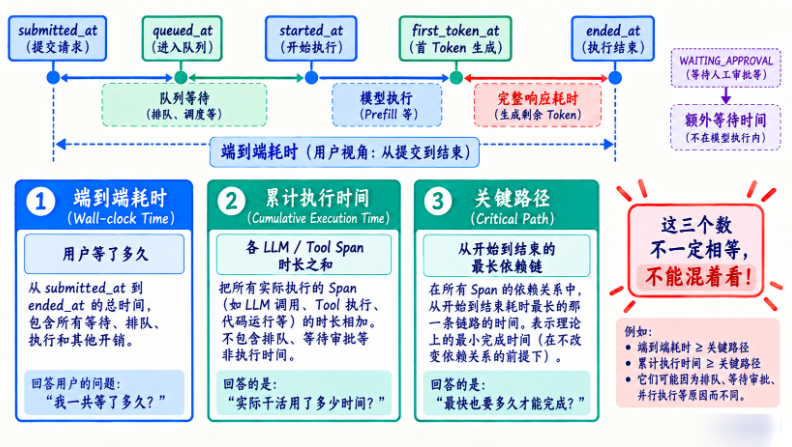
如图这样拆开以后,几个概念一下就清晰了:端到端耗时回答的是用户一共等了多久,累计执行时间回答的是系统实际干了多少活,而关键路径回答的是在当前依赖关系不变的前提下,最快也要多久才能完成。它们三个都重要,但说的不是同一件事。
“一次 Run 花了 30 秒”能说明用户等了多久,但还解释不了慢在哪里。我们继续把它拆开,看看下面几段各自用了多少时间:
- 排队或调度耗时:任务等待资源的时间。
- LLM 耗时:请求模型、等待首 Token 和接收完整响应的时间。
- Tool 耗时:文件、网络、数据库、Shell 或 Python 执行时间。
- 人工等待耗时:进入
WAITING_APPROVAL后等待用户确认的时间。 - 其他编排耗时:序列化、持久化、重试和结果合并时间。
Run 的端到端 duration 应保留从提交到终态的完整时间,包括等待。我们还可以分别记录 queue_latency、llm_latency、tool_latency、approval_wait 和 orchestration_latency,帮助判断应该优化哪一段。遇到并发时,这些阶段可能重叠,不能把所有数值相加后直接当成端到端耗时。
我们可以用一条时间线把口径稳定下来:
submitted_at ── queued_at ── started_at ── first_token_at ── ended_at
       队列等待              首 Token 延迟            端到端耗时
ended_at - submitted_at 回答“用户等了多久”;各 Span 时长之和回答“系统累计做了多少工作”;最长依赖链回答“哪条关键路径拖住了完成时间”。这三个数不一定相等。流式输出还要同时看 TTFT(Time To First Token)和完整响应耗时:前者影响“有没有开始回应”的感受,后者决定下一步 Tool 何时能开始。
四、用指标定位异常
把指标采上来之后,真正有价值的部分,还是“看到异常以后能不能迅速想到该往哪查”。单独盯着 Token、Cost 或 Latency 这一个数字,很多时候只能看到“变高了”,但并不知道为什么变高。把几组指标放在一起看,判断会快很多。
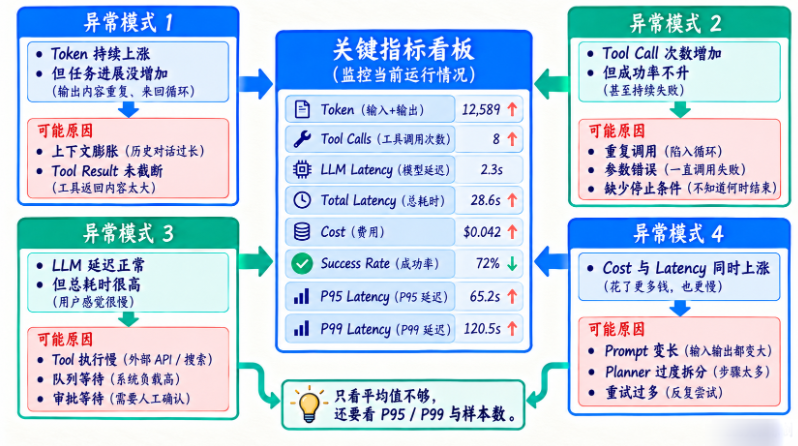
这张图其实就是一张排障思路图。比如 Token 一直涨但任务不推进,优先怀疑上下文膨胀或者 Tool Result 没截断;如果 Tool Call 越来越多但成功率不升,那就要看是不是在循环重试、参数错误或者缺少停止条件。尤其是底部那句提醒很重要:平均值只能说明大概,真正容易把体验拉垮的,往往是 P95/P99 这些长尾指标。
常见异常模式包括:
- Token 持续上涨,但任务进展没有增加:可能是上下文膨胀或 Tool Result 没有截断。
- Tool Call 次数快速增加,成功率没有提升:可能是重复调用、参数错误或缺少停止条件。
- LLM 延迟正常,但总耗时很高:可能是 Tool、队列或人工审批在等待。
- 成功率不变,Cost 和 Latency 同时上涨:可能是 Prompt 变长、Planner 过度拆分或重试过多。
- 平均值正常,但 P95/P99 很差:说明少数复杂任务存在严重长尾,不能只看平均数。
监控指标应该与 run_id、session_id、模型版本、Prompt 版本、Skill 和 Tool 版本关联。只有保留这些维度,后续才能回答“哪一次改动让成本上升了”这种工程问题。
五、从统计走向治理
统计指标的最终目的,是让 Harness 能够做出限制和决策。例如为一次 Run 设置最大 Token、最大成本、最大总耗时和最大 Tool Call 数;超过预算时,进入明确的 FAILED 或 BUDGET_EXCEEDED 状态,并把原因写入 Trace,而不是让任务悄悄继续消耗资源。
到这里,我们已经可以回答:
一个 Agent Task 用了多少 Token?
调用了多少次模型和 Tool?
跑了多久?慢在哪里?
大概花了多少钱?
下一节会进一步讨论:有了这些数据以后,如何用固定 Benchmark 判断一个 Agent 版本到底好不好。
六、从仪表盘到 SLO 与告警
平均值会掩盖少量极慢、极贵的 Run。按模型、Prompt/Skill/Tool/Policy 版本和任务类别聚合 P50/P95/P99,分别设置成功率、首 Token 延迟、总耗时、单 Run 成本与拒绝率的 SLO。告警应指向可行动原因,例如“某 Tool v3 的 P95 超预算”而非“图表有一条线变高”。同时记录缓存命中、重试与审批等待,避免把它们误归因给模型。
维度也不是越多越好。run_id、原始 Prompt 和用户自由文本属于高基数数据,适合留在 Trace 中查单次记录,不适合直接成为时序指标标签。告警还应设置最小样本数、持续时间和冷却期,否则一个慢样本就能造成误报风暴。
七、成本预算是运行时控制信号
到了这里,观测数据就不能只停留在报表层了。真正成熟一点的系统,会把 usage、cost 和 latency 再接回运行时,让它参与“能不能继续执行”的判断。这样观测才不只是事后总结,而是变成任务执行过程中的控制信号。
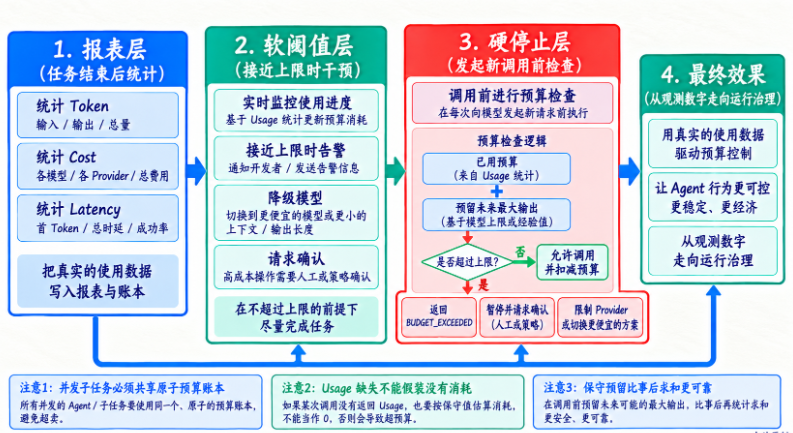
可以把这张图理解成一条治理闭环:左边是事后统计,中间是接近上限时的软干预,右边是发起新调用前的硬检查。这样一来,Agent 就不是等任务跑完才告诉你“超预算了”,而是在逼近上限时就开始告警、降级,必要时直接停止继续调用。
预算不是报表字段。每次模型调用前,根据已消耗 usage、价格版本和剩余 Task 估算检查是否还有继续空间;达到阈值进入 BUDGET_EXCEEDED 或请求用户选择是否继续。价格表、币种和生效期需版本化,历史报表才不会在模型调价后漂移。
八、跟着一次任务,把用量和费用算清楚
这一节最适合配一张“把账本摊平”的图。因为一旦把两次调用、缓存输入和逐项费用都摊开看,很多之前容易混的点,比如“缓存 Token 要不要再加一次”“缺失 usage 能不能当 0”,基本就不会再绕晕。
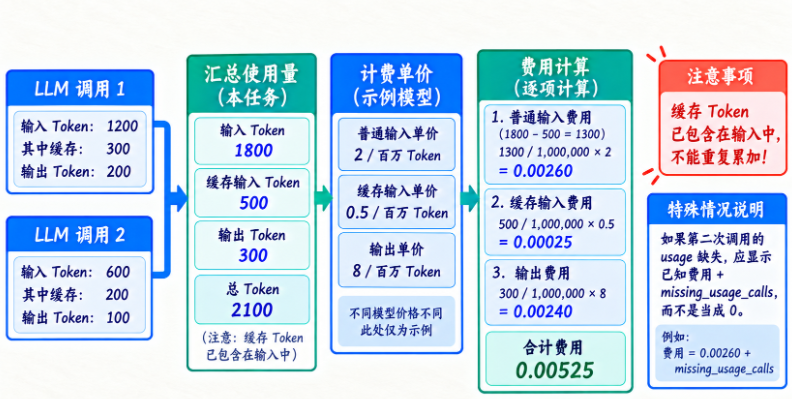
顺着这张图看,会发现整件事其实很机械:先按调用汇总输入、缓存输入和输出,再按单价逐项计算,最后汇总成总费用。最关键的一句仍然是红色那块——缓存 Token 已经包含在输入里,所以成本计算时是把输入拆分成“普通输入”和“缓存输入”,而不是在总输入之外再额外加一次缓存。
我们先拿一份小记录练习。假设一次任务调用模型两次:第一次输入 1200 Token,其中 300 命中输入缓存,输出 200;第二次输入 600,其中 200 命中缓存,输出 100。这里约定 input_tokens 已经包含 cached_input_tokens。不同接口的 usage 定义可能不同,Provider 应先完成口径转换,再交给统一聚合器。
两次调用合计输入 1800、输出 300,总计 2100 Token。缓存 Token 是输入的一部分,不能再加一次。如果第二次响应缺少 usage,我们应该报告已知用量和缺失次数,而不能把第二次记成零后宣称这是完整账单。
接下来使用一组纯教学价格:每百万普通输入 Token 为 2 个货币单位,缓存输入为 0.5,输出为 8。这些数字用于演算,不代表任何真实模型价格。普通输入为 1800 − 500 = 1300,因此估算费用是:
普通输入:1300 / 1,000,000 × 2   = 0.00260
缓存输入: 500 / 1,000,000 × 0.5 = 0.00025
输出:     300 / 1,000,000 × 8   = 0.00240
合计:                           0.00525
实际接入时,还要根据服务账单处理其他收费项。例如有的工具单独计费,有的缓存创建和读取采用不同价格。推理 Token 如果已经包含在接口报告的输出总量中,也不能再重复累加。我们先把输入数据的含义讲清楚,再讨论公式。
一个可以独立运行的聚合例子
下面的例子按模型调用 ID 统计,并将缺失 usage 显式保留下来。它使用独立教学数据结构,不直接替换项目中的 MetricsAggregator。价格单位为“货币单位/百万 Token”,全部调用暂时假设采用同一教学价格;多模型场景应先按每次调用对应的价格版本计费,再汇总同币种金额。
这段代码中,重复出现的 first 仍只计费一次,因为它代表同一次模型调用。若相同 call_id 的内容不同,我们直接报冲突,防止用去重悄悄掩盖记录错误。真正的两次重试则应有不同调用 ID:即便请求内容相同,只要服务分别执行并计费,就要分别记录。
Decimal 可以减少费用计算中的二进制浮点误差,但不会把估算变成正式账单。调用方仍需对价格配置、币种、usage 来源与其他费用负责。这里的延迟函数也只处理有限、有效的样本;生产采集还应验证缺失值和非有限数字。
九、并行执行时,耗时为什么不能直接相加
并发一进来,很多同学会本能地把每个 Span 的时间都加起来,然后把这个结果当作“用户等
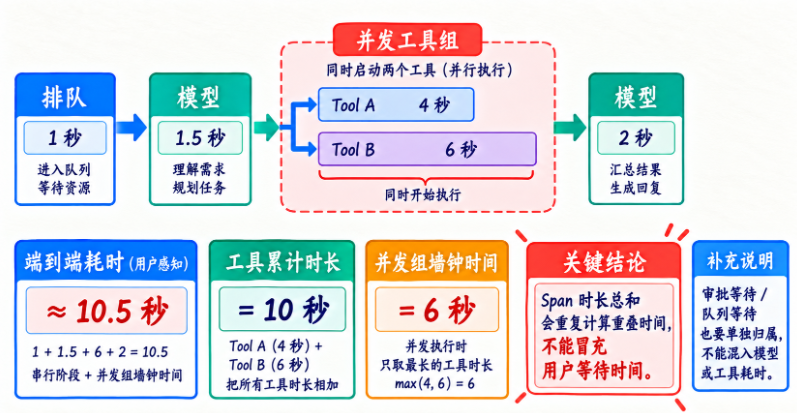
看完这张图就比较直观了:Tool A 和 Tool B 虽然累计占用了 10 秒,但因为它们是同时开始、并行执行,所以这组并发阶段的墙钟时间其实只取较长的那条,也就是 6 秒。也正因为如此,Span 时长总和更适合表达“系统累计占用”,不能直接拿来冒充“用户等了多久”。
我们假设一次任务排队 1 秒,第一次模型调用 1.5 秒,然后两个工具同时开始,分别执行 4 秒和 6 秒,最后模型用 2 秒生成回答。忽略其他开销时,用户等待约 10.5 秒:
排队 1 秒 → 模型 1.5 秒 → 并发工具组 6 秒 → 模型 2 秒两个工具的执行时间之和为 10 秒,表示工具累计占用;并发组的墙钟时间约为 6 秒,表示这段流程实际持续多久。把所有 Span 相加,会把重叠时间重复计入。审批等待、队列等待也应明确归属,不能为了展示更短的耗时而从用户等待时间中无声排除。
如果我们需要看端到端 P95,应收集每次 Run 的端到端时长;若要看模型调用 P95,就收集每次模型调用时长。这是两组不同样本。上面的 nearest-rank 只是一个明确的分位数定义,不同监控工具可能采用插值方法,跨系统比较前要统一口径。
五个样本可以帮助理解公式,但不足以稳定判断线上长尾。报表应同时显示样本数、时间范围和任务类别。只把一次慢任务混进大量简单任务,平均值可能很好看,却无法反映复杂任务的用户体验。
十、案例:工具一并发,Token 怎么也翻倍了
假设我们把两次文件读取改成并发,用户等待时间缩短,报表里的模型输入用量却翻倍。我们先沿调用 ID 检查 Trace。如果同一次模型响应请求了两个工具,而每个工具记录都保存了一份完整模型 usage,按工具记录求和就会重复计算模型消耗。
这时应检查事件归属:一次模型调用记录一次用量,工具记录通过父事件 ID 关联它,各自只保存自己的执行数据。配套通用 Engine 现在已经按这个口径拆分 LLM 与 Tool 事件,MetricsAggregator 只计算模型终态事件,并按 llm_call_id 去重。如果同 ID 出现不同 usage,聚合器会报冲突,避免“去重成功”却把数据问题藏起来。
复核时,我们同时看模型调用总数、工具总数和 usage。正确结果是:两次读取变成并发后,工具仍为两个,同一次模型调用仍只计一次。若任务因此减少了后续模型轮次,总成本才可能随之下降,不能单凭“工具更快”推导费用一定更低。
十一、案例:审批等了十分钟,是模型变慢了吗
一个 Run 总耗时十分钟,但模型与工具合计只用了几秒。查看状态事件后,我们发现大部分时间停在 WAITING_APPROVAL。这里需要同时保留用户等待时间与系统主动执行时间,报告它们回答的问题。
我们可以展示“从提交到完成 10 分钟,其中等待确认 9 分 50 秒”。这帮助产品判断是否需要更清楚的确认提示,也帮助工程人员避免误调模型参数。审批拒绝属于明确结果,不应简单并入模型故障率;被策略正确拒绝的请求也需要单独统计。
要建立 SLO,我们先约定衡量范围:是否包含用户等待、哪些任务类型适用、失败或取消如何计入。随后再设置告警阈值。否则同一组日志可以算出多个互相矛盾的“平均耗时”,大家却都觉得自己的报表没有错。
十二、把用量统计接回运行预算
有了统计,我们可以在下一次调用前检查剩余预算。但已经发生的调用无法靠下一轮检查撤销费用。如果业务要求硬成本上限,需要结合最大输出、工具限额、预留额度和实际执行机制控制;简单的事后求和属于软约束。
多工具或子 Agent 并发时,要先为各任务预留共享预算,再按实际用量结算。否则两个子任务都看到“还剩一块钱”,可能各自花掉一块。等待审批期间是否继续计算执行超时,也应写进运行策略,并在恢复时保持一致。
配套 RunGuard 已经限制步数、工具次数、运行时间和累计 Token,多 Tool 批次也会在执行前整批预留次数。但它还没有根据模型、价格版本和币种执行金额硬上限,也不能在调用前准确预知未来输出会用多少 Token。课程里的费用示例已接入项目聚合器,它提供可追溯的估算,不等于整个项目已具备硬费用封顶。
十三、从软告警到硬停止,中间还差一步
运行时预算大致分三层。第一层是报表,任务结束后告诉我们花了多少;第二层是软阈值,用量接近上限时记录告警或降级模型;第三层才是硬停止,在发起新调用之前就拒绝不可接受的风险。
难点在于未来输出未知。假设已用 9000 Token,上限是 10000,我们不能因为“当前还有 1000”就放行一次最多可输出 4000 Token 的调用。更稳妥的方式是先预留可能的最大费用,响应返回后再按真实 usage 结算。并发子任务必须使用同一个原子预算账本,否则每个子任务都会看到同一份“剩余额度”。
如果 Provider 没有返回 usage,硬预算策略不能假装没有消耗。可以采用保守预留、暂停后请求确认,或将该 Provider 限制在软预算模式。选哪一种取决于业务风险,但这个降级必须在 Trace 中看得见。
十四、一张可信的仪表盘应该带哪些说明
当页面上显示“Token 2100、Cost 0.00525、Latency 10.5s”时,还应让人知道这些数字的范围。至少配上时间窗口、样本数、任务类别、模型版本、价格版本、币种、usage 完整度和耗时口径。“已知费用”和“完整费用”是两句不同的话,只要有一次 usage 缺失,界面就要把这个不完整性显示出来。
分位数同样需要口径。P95 要从原始 Run 样本计算,不要把每天的 P95 再求平均;单位要固定为毫秒或秒,避免 1500ms 和 1.5s 混在一列;失败、取消、策略拒绝是否进入分母,也要在 SLO 定义中写明。报表不用把所有字段都堆在首屏,但要能从异常指标一路下钻到 Run 和 Trace。
十五、几个特别容易算错的地方
- 把
started和completed都当成一次调用,调用数和费用随之翻倍。我们只在终态事件结算,再按调用 ID 防重投。 - 把缓存 Token 加到 Input Token 上。本节的约定是缓存部分已经包含在输入中,成本计算时才分成普通输入与缓存输入。
- 把缺失 usage 当成 0。这会让最不完整的报表反而看起来最便宜,必须同时输出
missing_usage_calls和usage_complete。 - 用最后一个模型的价格乘整次 Run 用量。多模型任务要先逐调用按价格快照计算,再汇总同币种金额。
- 用 Span 时长总和冒充端到端耗时。并发时 Span 会重叠,这个总和反映累计占用,不是用户的墙钟等待。
- 只看平均值,或在小样本上频繁告警。先显示样本数与任务分类,再看 P95/P99,长尾问题才不会被均值掩盖。
十六、把术语放回运行现场
Usage:Provider 报告的模型用量。我们要保留来源与完整性,不把估算和缺失混在一起。
TTFT:从模型请求发出到收到首个 Token 的时间。它影响流式界面的首次反馈,但不代表整个响应已完成。
端到端耗时:从任务提交到进入终态的墙钟时间,通常包含队列和审批等待。
累计执行时间:各 LLM 与 Tool Span 的时长之和。并发时它可能大于端到端耗时。
关键路径:从开始到完成的最长依赖链。要降低端到端耗时,通常应优先优化它,而不是随便找一个最慢 Span。
价格快照:某个生效时点下,模型、Token 类型、币种和单价的版本化记录。它让历史估算可复算,不随全局配置漂移。
章末练习:我们能否解释每一个数字
先运行本节聚合代码,再给它增加一次缺失 usage 的调用。请检查报表是否仍明确标记不完整。参考结果是已知费用继续显示,缺失调用数量增加,但不能把已知费用命名为最终总账单。
接着将两个并发工具改为顺序执行。按本节时间假设,端到端耗时由约 10.5 秒增加到约 14.5 秒;两工具各自时长不变,模型 Token 也不会仅因为调度方式改变就自动翻倍。
最后,给两个不同模型使用不同价格配置。参考思路是先根据每次调用的模型与价格版本分别计算,再汇总同币种费用;不能用最后一个模型的单价乘整次任务所有 Token。若这些数字都能沿调用记录复算,我们就可以进入下一节,比较不同 Agent 版本是否值得采用。
本章总结
这一节我们从一份具体调用记录出发,算清了已知用量、缓存费用和缺失数据,又沿执行时间线区分了用户等待与工具累计占用。遇到“任务突然变贵或变慢”,我们现在可以先查调用次数、上下文大小、工具重试与审批等待,再决定改哪里。
接下来做 Evaluation 时,请把这组统计与任务结果一起保留。成功率、成本和延迟需要同时解释:一个版本可能少花 Token,却更容易提前结束;另一个版本可能验证得更充分,但耗时也更长。我们需要用同一组任务和明确口径比较,才能判断这些变化是否值得。
















请登录后查看评论内容