

题目 1:Run、Step、Trace、普通日志分别解决什么问题?
请从任务生命周期、过程索引、详细证据和服务运维四个角度解释。
Run 表示一次完整 Agent 任务的生命周期,例如 READY、RUNNING、COMPLETED、FAILED;Step 表示 Run 内的过程序号和阶段;Trace 保存每一步更细的 Prompt、模型可见输出、Tool、参数、结果、Token 和延迟等证据;普通日志则更适合服务启动、HTTP 错误、数据库连接等运维事件。四者有关联,但职责不同。
题目 2:一条完整 Agent Trace 至少应该记录哪些字段?
请说明 Prompt、LLM Response、Tool、Arguments、Tool Result、Latency、Token、Status 各自为什么重要。
Prompt 说明模型当时看到了什么;LLM Response 说明模型返回了什么可见决策;Tool 与 Arguments 说明系统实际准备执行什么;Tool Result 是环境 Observation;Latency 说明慢在哪;Token 用于成本和 Context 分析;Status 说明步骤是完成、失败、阻塞还是等待审批。把这些字段串在同一个 Step 中,才能完整复盘行为链。
题目 3:编程实现——定义一个最小 TraceStep
要求至少包含 run_id、step_no、tool_name、tool_arguments、latency_ms、status。
from __future__ import annotations
from dataclasses import dataclass
from typing import Any, Optional


@dataclass
class TraceStep:
    run_id: str
    step_no: int
    tool_name: Optional[str]
    tool_arguments: Optional[dict[str, Any]]
    latency_ms: float
    status: str


if __name__ == "__main__":
    item = TraceStep(
        run_id="run_demo",
        step_no=3,
        tool_name="read_file",
        tool_arguments={
            "path": "app.py"
        },
        latency_ms=18.6,
        status="completed",
    )

    print(item)
#真实项目可以继续增加 prompt、llm_response、tool_result、tokens 和 error 等字段。
题目 4:为什么 Trace 中最好记录“最终 ContextBuilder 输出”,而不仅是用户原始问题?
请结合 AGENTS.md 和 Skill 漏加载的案例说明。
模型真正看到的输入通常不只是用户一句话,而是 System Prompt、项目规则、Skills、Memory、Conversation、Reminder 等组合。如果只保存用户问题,就无法判断某次违规修改是模型不遵守规则,还是 ContextBuilder 根本没把 AGENTS.md 放进去。记录最终可见上下文能帮助工程师区分 Prompt 构建问题与模型决策问题。
题目 5:为什么 Tool Result 需要截断、脱敏或使用 Artifact 引用?
请从 Context、存储成本、隐私与安全四个方面说明。
Tool Result 可能包含巨量日志、SQL 数据、文件内容甚至凭据。原样永久保存会快速增加数据库和存储压力,也可能把用户隐私或秘密复制到 Trace。更合理的是保存结构化摘要、长度、样本、错误信息和 Artifact 指针,对敏感字段脱敏,对超大内容截断。Trace 要保留证据,但不能成为新的数据泄露源。
题目 6:如何用 Trace 判断一个错误是 Tool 问题还是模型解释问题?
请用收入下降案例说明。
先看 Tool Arguments 是否符合任务,再看 Tool Result 是否已经包含正确事实。如果 SQL 查询字段、时间范围和结果都正确,例如请求量基本稳定、eCPM 明显下降,而下一步 LLM Response 却总结“请求量下降是主因”,说明错误发生在模型解释层;如果 Tool Result 本身就查错日期或指标,则应先修 Tool 或参数生成逻辑。Trace 可以避免修错层。
题目 7:为什么 Tracing 是后续 AgentOps 和 Evaluation 的基础?
请至少给出五个后续可以从 Trace 计算的指标。
Trace 已经记录每个 Step 的 Token、Latency、Tool、Status 和 Error,因此可以进一步计算平均 Steps、输入输出 Token、总成本、平均 LLM 延迟、Tool 调用次数、Tool Error Rate、Retry Rate、重复调用率、成功 Run 的平均耗时、失败原因分布等。Evaluation 还可以比较不同 Prompt、Skill、模型版本的行为差异,因此 Trace 是后续 AgentOps 的原始数据层。
题目 8:为什么 step_no 不能作为 Trace Event 的唯一键?
同一个 Main Loop Step 可能包含 LLM started/completed、多个 Middleware 决策、多个并行 Tool started/completed 和 Approval 事件,它们拥有相同 step_no。应使用 event_id 唯一标识、sequence 排序,再用 llm_call_id、tool_call_id 和 parent_event_id 还原关系。
题目 9:一次 Provider 调用抛出 TimeoutError,完整 Trace 至少应留下哪些事件?
先有 Run running 和 llm.started,再有携带异常类型、耗时与 llm_call_id 的 llm.failed,最后有 Run failed 或对应的可恢复状态。如果只有最外层 FAILED,就无法判断请求是否真正发出、等待了多久,也无法区分 Provider 超时和 Tool 失败。
题目 10:如何避免 Trace 自己成为敏感信息泄露源?
在落盘前按字段标注和规则脱敏,截断大文本,把完整大结果放入受控 Artifact;同时实施租户与项目所有权校验、最小查看权限、加密、访问审计和保留删除策略。正则只能提供基础防线,不能替代数据分类与权限治理。
题目 11:两个 Tool 并行执行时,成本指标和耗时指标应如何计算?
模型 Token 只归属产生这批 Tool Call 的一次 LLM Event,不能复制到每条 Tool Event。Tool 调用次数按不同 tool_call_id 统计;资源工作量可以看各 Tool Latency 之和,端到端耗时则看从 Step 开始到全部结果就绪的墙钟时间,通常接近关键路径而不是简单求和。
进一步阅读
在进入资料列表前,我们先把课程 Trace 和 OpenTelemetry 对上一次。两者不是替代关系:TraceRecorder 负责保存课程运行时的完整业务事实,OpenTelemetry 负责把跨服务观测字段送进统一 Collector。直接让核心循环依赖某个 OTel SDK,会把教学模型、采样配置和部署环境绑在一起;更稳的是先经过一个薄映射层。
配套项目中的 trace_step_to_otel() 会把 Run、LLM 与 Tool 事件分别映射为 invoke_agent、chat 和 execute_tool,并保留 event、parent、llm_call 和 tool_call 关系:
from agent_harness.observability.otel import trace_to_otel


spans = trace_to_otel(
    trace.list_steps(run_id)
)

for span in spans:
    print(
        span.name,
        span.parent_event_id,
        span.attributes,
    )
映射层默认不复制 Prompt、Tool Arguments 和 Tool Result。原因很实际:这些字段既可能很大,也很可能带有代码、业务数据或凭据。Token、模型名、Tool 名、调用 ID 和低基数错误类型足够支持大多数聚合;确实需要内容观测时,也应经过显式开关、脱敏、长度限制和访问控制。
OpenTelemetry 的 GenAI Semantic Conventions 仍在独立仓库持续演进,所以这里提供的是可测试的 Span DTO,不冒充完整 OTLP Exporter。接入 SDK 时,只需要把 DTO 转成真实 Span;课程内部 Trace 格式和业务证据不必跟着 Collector 版本变化。可对照 OpenTelemetry GenAI Agent Spans 与 GenAI 属性注册表 查看当前字段定义。
- Distributed Tracing:理解 Trace、Span、Parent/Child 关系。
- OpenTelemetry Concepts:了解标准化 Trace / Metric / Log 思想。
- Structured Logging:日志为什么也应该包含 run_id、step_id。
- Agent Observability:模型、Tool、Context、Policy 多层可观测。
- Redaction / Data Governance:Trace 中敏感数据的脱敏和保留策略。
- Latency Profiling:区分 LLM Latency、Tool Latency、Queue Time。
- Token Accounting:下一节会进一步统计 Token、成本与耗时。
- Agent Evaluation:Trace 如何成为 Benchmark 的执行证据。
术语表
- Tracing:对一次 Agent Run 的执行过程进行结构化记录,使每个 Step 的输入、输出、Tool、延迟、Token 与状态都可追踪。
- TraceStep:Trace 中最基本的执行单元,通常对应 Agent Main Loop 的一次决策或动作阶段。
- Run Trace:以 run_id 为根,把一次完整任务中的所有 Step 串起来形成的执行轨迹。
- LLM Event:一次模型调用相关事件,包括输入消息、可见输出、Token、Latency 和状态。
- Tool Event:一次工具执行相关事件,包括 Tool 名、Arguments、Result、Latency、Status 与 Error。
- Event ID:每条 Trace Event 的唯一标识,不能用可能重复的 step_no 代替。
- Sequence:同一 Run 内用于稳定排序的递增序号,服务重启或并发写入时仍需保持一致。
- Correlation ID:把同一次逻辑调用的 started、completed、failed 和重试关联起来的 ID,例如 llm_call_id、tool_call_id。
- Parent Event / Span:表示事件或 Span 的直接上游,用来构建 Run、SubAgent、LLM 与 Tool 的父子树。
- Redaction:在 Trace 落盘前移除或替换凭据、隐私和敏感字段。
- Trace Sampling:按策略选择保留哪些 Run 的详细轨迹;尾部采样可以在知道最终状态后优先保留异常 Run。
- Latency:一次模型调用、Tool 调用或完整 Step 所花费的时间,是性能分析的重要指标。
- Token Usage:模型调用消耗的 input_tokens、output_tokens 与 total_tokens,是成本、Context 和效率分析基础。
- Observability:系统通过 Trace、Metric、Log 等数据,让内部运行状态可以被理解、定位和评估的能力。
本章总结
回头看这张知识回顾图,可以把整章压缩成一条思路:Trace 记录发生了什么;Run / Step / Events 提供结构;Recorder 负责跨组件收集;持久化让证据留得下来;最后才能逐层定位故障。
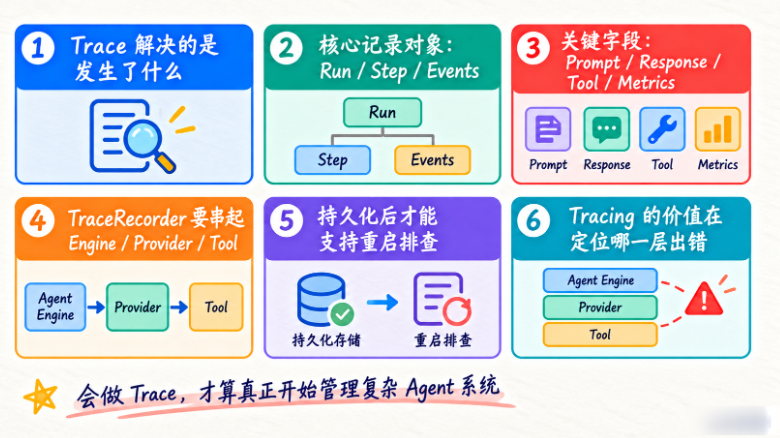
做到这里,Trace 才不只是“多几条日志”,而是能支撑后续排查、评估与审计的运行证据。
这一节,我们终于开始解决一个复杂 Agent 系统必然会遇到的问题,出问题以后,到底发生了什么?
Agent 越复杂:
Planner
SubAgent
Skills
AGENTS.md
Middleware
Approval
Tool
Memory
参与的组件越多。
如果只看到:
Run = FAILED几乎没有调试价值。
所以我们引入,Tracing。
最终希望形成:
Run
 ├─ Step 01
 ├─ Step 02
 ├─ Step 03
 └─ Step 04
每一个 Step 都能够回答:
模型看到了什么?
模型返回了什么可见决策?
调用哪个 Tool?
Arguments 是什么?
Tool Result 是什么?
耗时多久?
用了多少 Token?
最终状态是什么?这一章最重要的第一条原则是,Run 是任务,Step 是过程,Trace 是证据。
普通日志可以告诉你:
接口 500
数据库连接失败
但 Trace 能告诉你:
第 7 步为什么选了这个 Tool
为什么传这个参数
为什么下一步又重试第二条原则是,Trace 要结构化。
只有字段化记录:
run_id
step_no
tool_name
latency_ms
input_tokens
status
后面才能统计:
平均 Steps
Token
成本
Tool Error Rate
Retry Rate
Latency第三条原则是,Trace 要记录最终可见输入和输出,而不是只记录用户问题。
因为模型真正看到的是:
System Prompt
AGENTS.md
Skills
Memory
Conversation
Reminder
Tool Results
如果这些没记录,后面就无法判断:
是模型没遵守规则
还是 ContextBuilder 根本没加载规则。第四条原则是,Trace 不应该依赖隐藏推理。
工程系统真正需要保存的是:
模型收到的可见输入
模型返回给 Harness 的可见输出
结构化 Tool Call
Arguments
Observation
状态变化
这些已经足够支持绝大多数复盘和评估。
第五条原则是,失败 Step 和成功 Step 都要记录。
很多错误不是发生在最后一刻。
而是前面某个看似成功的动作:
成功读了错误文件
成功执行了错误 SQL
成功修改了不该修改的文件
一步步积累出来的。
所以必须记录完整 Run。
我们实现了:
TraceStep
TraceRecorder
SQLiteTraceStore
PersistentTraceRecorder
把:
Prompt
LLM Response
Tool
Arguments
Tool Result
Latency
Token
Status
真正落到结构化数据中。
现在一条 Trace 还会带上:
event_id
sequence
event_type
llm_call_id
tool_call_id
parent_event_id
payload_digest
它们让同一 Step 中的模型、策略、审批和并行 Tool Event 能够准确关联。started 与 completed / failed 成对出现,取消、预算耗尽和最终答案也有 Run 终态;模型 Token 只记录一次,不会复制到每条 Tool Event。
记录边界同样重要。Recorder 在保存时深拷贝可变对象,先脱敏和截断,再写入 SQLite;大结果使用 Artifact 引用。生产环境还要继续补租户隔离、加密、访问审计、保留删除和按 Run 采样,因为 Trace 本身就是一份高敏感度的执行证据。
并且通过 Coding Agent 和 Data Analysis Agent 两个案例,看到 Trace 最重要的价值,它能告诉你错在哪一层。
可能是:
Context Error
LLM Decision Error
Argument Error
Tool Error
Policy Error
Interpretation Error
Orchestration Error
这比一句:
“Agent 做错了。”有价值得多。
从这一章开始,我们终于拥有了,可复盘的 Agent。
下一节,我们会直接利用 Trace 中已经记录的:
input_tokens
output_tokens
latency
tool_calls
steps继续做,Token、成本与耗时监控。
也就是说,下一节我们会开始回答:
一次 Agent 任务到底花了多少 Token?
调用了多少次模型?
调用了多少次 Tool?
跑了多久?
平均每一步多慢?
这就是 AgentOps 真正开始落地的地方。
















请登录后查看评论内容