

数据分析里,一条看起来合理的结论可能在“读到结果 → 解释结果”的环节就走偏。下面的图把 SQL、真实返回、模型解释和最终文字结论分别画出来,方便观察这些环节如何对照。
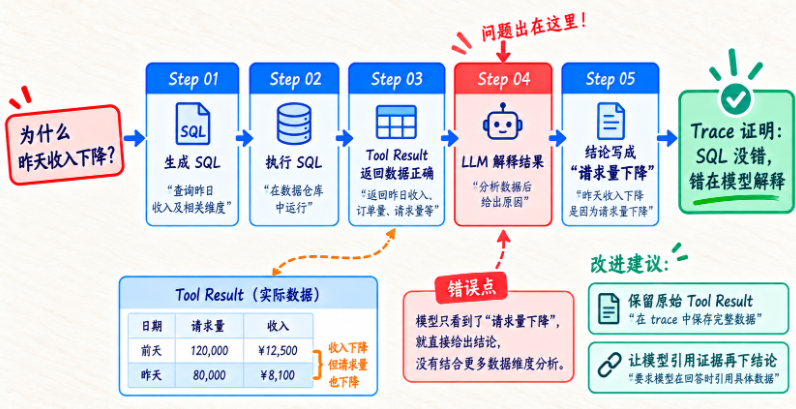
注意:图中的表格数值是示意,不是这个案例的实际 Trace 数据。 是否真能排除 SQL 错误、确定是模型解释错误,必须结合正文对应 Run 中的原始 Tool Result、实际查询口径和模型可见内容判断,不能仅靠示意图作出归因。
场景背景
用户,“为什么昨天收入下降?”
最终 Agent:
请求量下降导致收入下降。用户说不对。
Trace
Step 04:
Tool:
query_sql
Arguments:
date = yesterday
metrics = request, impression, income, ecpm
Tool Result:
request: -0.8%
impression: -1.2%
income: -21%
ecpm: -34%
SQL 数据非常清楚。
Step 05 LLM Response
请求量下降是主要原因。这说明:
Tool Correct
Data Correct
Interpretation Wrong
下一步怎么改?
可以:
加强 data-analysis Skill
加入指标分解规则
加入验证步骤
要求最终结论引用 Tool Result
而不是浪费时间去改 SQL Tool。
复盘
这就是 Trace 帮我们避免,修错层。
Agent 系统越复杂,这个价值越大。
常见误区
误解: 已经有日志了,所以不需要专门的 Agent Tracing。
正解: 普通日志主要记录服务级事件,而 Agent Trace 要围绕 run_id、step_no 还原一次任务的决策链。它需要把 Prompt、可见模型输出、Tool Request、Arguments、Tool Result、Latency、Token、Status 串在一起。没有这种结构化关系,即使日志很多,也很难回答“第 7 步为什么调用了这个 Tool”。
误解: Trace 只需要记录 Tool Call,模型输入和输出不重要。
正解: 如果不记录模型最终看到的 Context,很难判断错误来自 Prompt 构建还是模型决策;如果不记录可见模型输出,也不知道 Tool Call 是如何形成的。Trace 的价值就是把输入、决策结果和环境反馈连成完整链路。至少要保存可审计的可见输入与输出,敏感字段则应脱敏或截断。
误解: 为了完整复盘,应该记录模型所有隐藏推理内容。
正解: 工程 Tracing 并不需要依赖不可见的内部推理。真正可操作的是记录最终 Prompt、模型返回给 Harness 的可见响应、结构化 Tool Call、参数、Observation 与状态变化。调试目标是复盘系统行为,而不是获取隐藏思维过程。可见决策证据已经足够支持大多数工程定位。
误解: Tool Result 越完整越好,最好原样永久保存。
正解: Tool Result 可能非常大,也可能包含敏感数据、密钥、用户隐私或大量无意义日志。生产 Trace 应支持截断、摘要、脱敏和 Artifact 引用。真正重要的是保留足够证据定位问题,而不是无边界复制所有原始数据。Trace 本身也需要数据治理。
误解: 失败的 Step 才值得 Trace,成功 Step 没必要。
正解: 很多失败是由前面某个“看似成功”的动作埋下的。例如成功读取了错误文件、成功执行了错误 SQL、成功修改了不该改的文件。只有完整记录前后 Step,才能看出错误是如何逐步形成的。Tracing 应覆盖整个 Run,而不是只在异常发生时临时打开。
误解: Trace 数据只是 Debug 用,和 AgentOps、Evaluation 没关系。
正解: 后续统计平均 Steps、Token、Tool Error Rate、Retry Rate、Latency、Cost、成功率,都需要 Trace 的结构化字段。没有 Trace,Agent Evaluation 只能看最终答案,很难解释为什么某个版本更好或更差。Tracing 实际上是整个 Observability、AgentOps 和 Benchmark 的底层数据基础。
误解: run_id + step_no 足以唯一定位一条 Trace。
正解: 一轮模型可能产生多条 Policy 和 Tool Event,它们共享同一个 step_no。每条事件要有 event_id 和 sequence,模型与工具再分别使用 llm_call_id、tool_call_id 关联。否则并行完成顺序一变,记录就接错了。
误解: 只保存 completed / failed,started 没有信息量。
正解: started 没有对应终态,恰恰是识别崩溃、悬挂和 Worker 丢失的重要证据。开始与终态配对,还能把排队、模型、策略和工具耗时拆开。
误解: Trace 查询页加一层登录,就可以保存所有原始 Prompt。
正解: 权限控制不能替代落盘前脱敏。备份、管理员工具、数据导出和误配置都可能扩大暴露面。应先最小化、脱敏和截断,再做租户隔离、加密、访问审计与保留周期。
误解: 为节省存储,可以随机删掉一个 Run 中的部分事件。
正解: 零散采样会留下无法解释的半条链。更合适的是以 Run 为单位采样,或在 Run 结束后用尾部采样优先保留失败、超时和高风险轨迹。
误解: 两个并行 Tool 各耗时 2 秒,这一步总耗时就是 4 秒。
正解: 如果它们同时执行,用户等待时间接近最长的那条关键路径,再加调度开销。各 Span 耗时之和表示资源工作量,不等于端到端墙钟时间。
















请登录后查看评论内容