

前面两节,我们已经做了两件非常关键的事。
第一件:
Tracing让我们可以完整看到:
Run
 ├─ Step 01
 ├─ Step 02
 ├─ Step 03
 └─ Step 04
并记录:
Prompt
LLM Response
Tool
Arguments
Tool Result
Latency
Token
Status
第二件:
Token、成本与耗时监控让我们能回答:
一个 Agent Task
用了多少 Token?
调用多少次模型?
调用多少次 Tool?
跑了多久?
大概花了多少钱?但到这里,还有一个更关键的问题,这个 Agent 到底好不好?
很多团队一开始做 Agent,评价方式非常直觉:
“我试了几个任务,感觉还不错。”或者:
“回答看起来挺聪明。”甚至:
“这次终于跑通了。”这些当然可以作为早期感受。
但不能作为真正工程评价。
因为 Agent 是一个有状态、会调用 Tool、会多步执行、会 Retry、会消耗 Token、会产生副作用的系统。
所以真正评价它,不能只看,“最后一段话看起来像不像对的。”
我们必须同时关心:
Task Success Rate

平均 Step

平均 Token

Tool Error Rate

Retry Rate

Latency

Cost最终建立,自己的 Agent Benchmark。
这一章,我们就把前面 Trace 与 Metrics 的数据真正用起来。
开场引入
先看两个 Agent。
版本 A:
任务成功率:82%
平均 Step:7
平均 Token:28K
平均耗时:25 秒
平均成本:低
版本 B:
任务成功率:86%
平均 Step:18
平均 Token:110K
平均耗时:80 秒
平均成本:高
如果只看:
Success RateB 更好。
但如果业务场景是:
低延迟
高并发
大量日常任务
那 4% 的提升可能不值得 4 倍成本。
反过来。
如果业务场景是:
高价值代码修复
复杂生产排障
一次任务价值很高
那 4% 成功率提升可能非常值得。
所以,Agent Evaluation 不是寻找一个万能分数。
而是建立一组指标,然后结合业务目标做判断。
再看另一个例子。
版本 C:
最终成功率 90%看起来很好。
但 Trace 发现:
30% 的成功任务
修改了不该修改的 tests/
那这个“90% 成功率”其实没有意义。
因为:
结果成功
≠
过程合规
所以一个真正的 Agent Benchmark,需要先定义,什么叫成功?
再定义,成功的代价是多少?
这就是这一章最核心的逻辑。
知识地图
先把任务、运行过程和最终产物连起来看,后面那些指标就有了出处。Trace 负责留下过程证据,最终结果依据成功标准判定,两路信息合在一起才构成评测报告。
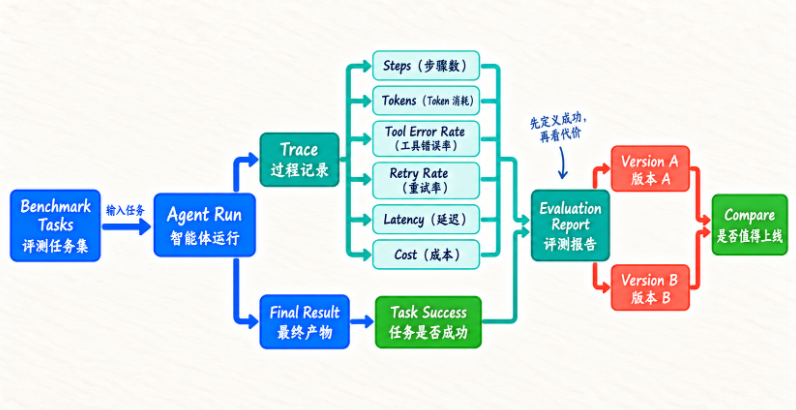
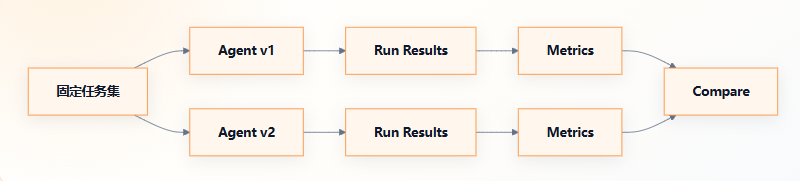
图中的报告同时接收过程指标与任务结果;比较版本时还要固定任务集和运行条件,否则数字变化未必来自 Agent 本身。
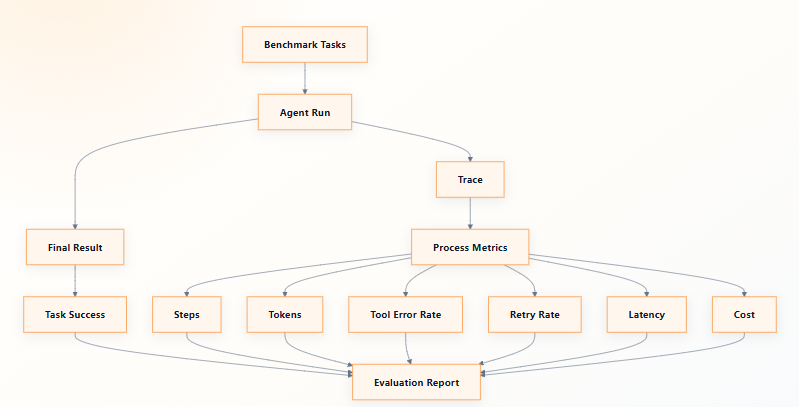
完整 Benchmark:
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容