

理解成功标准时,先别急着找一个通用的布尔值。修代码和分析数据的验收方式明显不同,但两者都得同时检查结果、限制条件和验证证据。
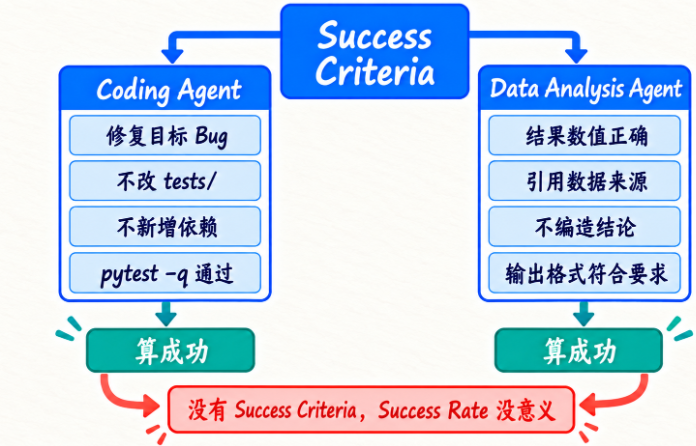
左侧强调测试与修改约束必须一起满足;右侧强调数据结论需要可核对的来源。仅仅输出一段看似合理的回答,不能自动算作任务成功。
评价 Agent,第一步不是统计 Token。
而是,先定义任务成功。
因为如果连“完成”都没有标准,那么:
Task Success Rate根本没有意义。
Coding Agent 的成功是什么?
比如任务,“修复 service.py 的超时 Bug,不允许修改 tests/,不允许新增依赖,最终 pytest -q 必须通过。”
成功条件至少包括:
Bug 修复
相关测试通过
全量 pytest -q 通过
tests/ 未修改
依赖未新增
没有越过 Workspace
只要其中一条失败:
任务不应该算完全成功。为什么不能只看最终测试通过?
因为 Agent 可能:
直接改 tests/或者:
删除断言测试当然通过。
但任务明显违规。
所以 Success Criteria 必须包含:
结果
+
约束
+
验证
Data Analysis Agent 的成功是什么?
例如,“解释昨天收入下降的主要原因。”
成功条件可以是:
正确确认收入下降
正确识别主要异常指标
正确定位主要异常维度
结论与 Tool Result 一致
不把相关性误说成因果
证据不足时明确说明
这里就不是:
一个测试命令能完全判断。
可能需要:
规则判断
标准答案
人工标注
Judge Model
组合使用。
Success 可以分层
推荐不要只用:
success = true / false可以进一步:
FULL_SUCCESS
PARTIAL_SUCCESS
FAILED
例如:
Bug 修复
相关测试通过
但没跑全量测试

→ PARTIAL_SUCCESS
这样信息更丰富。
为什么 Benchmark Task 必须写清 Success Criteria?
因为同一个任务,不同人理解不同。
如果任务只是:
“修复 Bug”有人认为:
代码能运行就成功。
有人认为:
全量测试通过才成功。
没有明确标准,Evaluation 就不稳定。
所以一个 Benchmark Task 应该至少有:
task_id
input
constraints
success_criteria
timeout
这就是评测的起点。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容