

3.3 贝叶斯定理
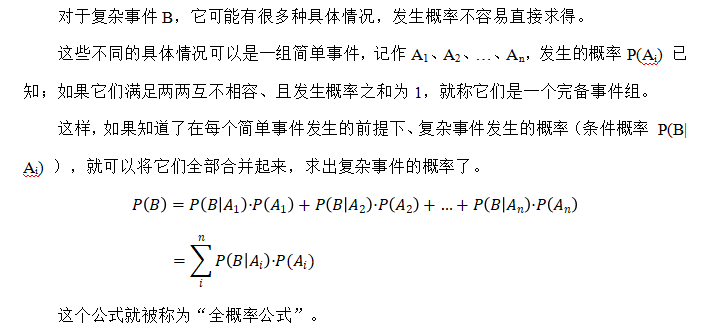
贝叶斯定理(Bayes' Theorem)是概率论中的一个核心定理,用于描述在已有条件概率信息的基础上,如何更新或计算事件的概率。它以英国数学家托马斯·贝叶斯的名字命名。贝叶斯定理特别适合处理“...
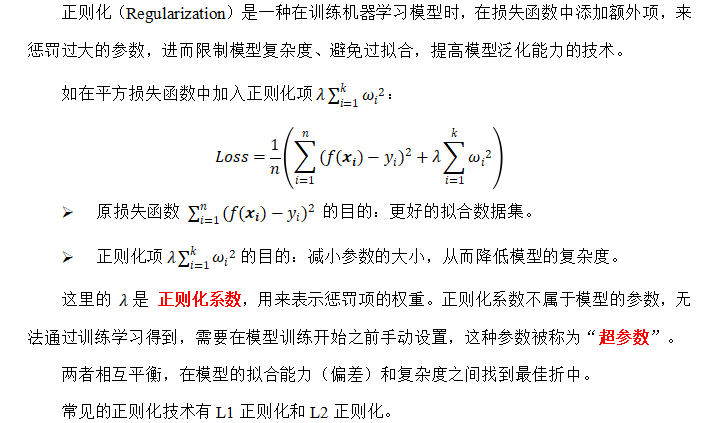
2.5.4 正则化
import numpy as np import matplotlib.pyplot as plt from sklearn.model_selection import train_test_split from sklearn.linear_model import LinearRegression, Lasso, Ridge from sklearn...
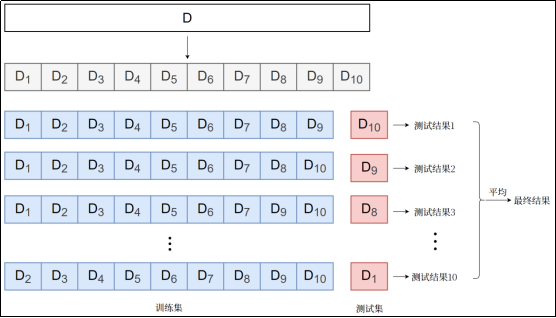
2.5.5 交叉验证
交叉验证(Cross-Validation)是一种评估模型泛化能力的方法,通过将数据集划分为多个子集,反复进行训练和验证,以减少因单次数据划分带来的随机性误差。通过交叉验证能更可靠地估计模型在未知...
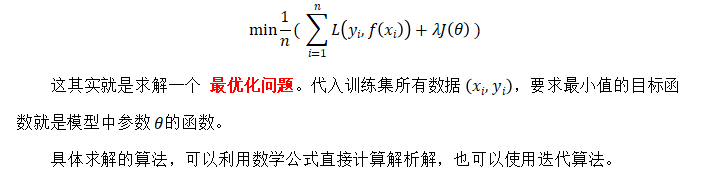
2.6 模型求解算法
正则化可以有效防止过拟合,增强模型的泛化能力。这时模型的评估策略,就是让结构化的经验风险最小,即增加了正则化项的损失函数最小,称为 结构风险最小化(Structural Risk Minimization,SRM...
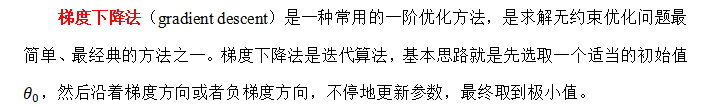
2.6.2 梯度下降法
梯度方向:函数变化增长最快的方向(变量沿此方向变化时函数增长最快) 负梯度方向:函数变化减少最快的方向(变量沿此方向变化时函数减少最快) 因为损失函数是系数的函数,那么如果系数沿着损...
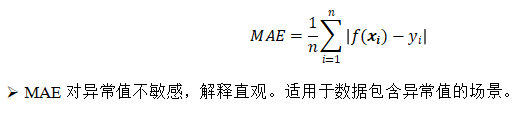
2.7 模型评价指标
对学习的泛化性能进行评估,不仅需要有效可行的实验估计方法,还需要有衡量模型泛化能力的评价指标,也叫做性能度量(performance measure)。 回归模型评价指标 模型的评价指标用于衡量模型在...
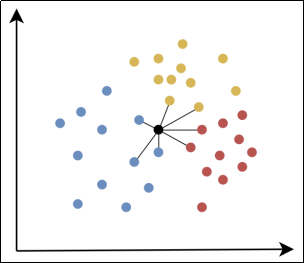
第 3 章 KNN算法
3.1 KNN算法介绍 K近邻算法(K-Nearest Neighbors,KNN)是一种基本的分类与回归方法,属于监督学习算法。其核心思想是通过计算给定样本与数据集中所有样本的距离,找到距离最近的K个样本,然后...
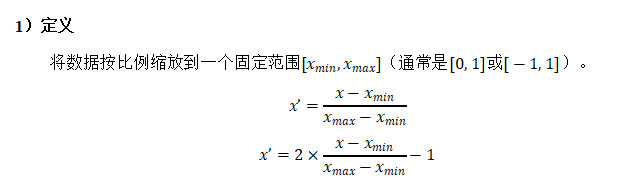
3.3 归一化与标准化
3.3.1 归一化 4)API使用 from sklearn.preprocessing import MinMaxScaler X = [[2, 1], [3, 1], [1, 4], [2, 6]] # 归一化,区间设置为(-1,1) X = MinMaxScaler(feature_...
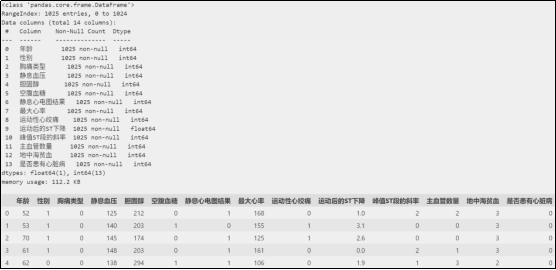
3.4 案例:心脏病预测
3.4.1 数据集说明 Heart Disease数据集https://www.kaggle.com/datasets/johnsmith88/heart-disease-dataset。 年龄:连续值 性别:0-女,1-男 胸痛类型:0-典型心绞痛,1-非典型心绞痛,2-非心...

