


6. 结果分析与解读
在这一部分,我们将对模型的结果进行详细分析,解释不同聚类方法(K-Means 和 GMM)在客户数据上的表现,并给出具有业务指导意义的解读。 6.1 K-Means 聚类结果分析 6.1.1 K-Means 聚类的特点 ...
八、信用卡交易数据的基本探索
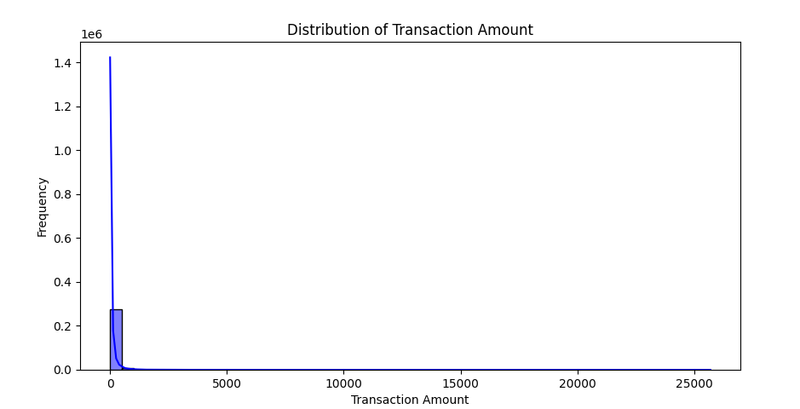
1. 目标定义和假设设定 1.1 目标定义 本次数据分析的目标是对信用卡交易数据进行基本探索,以识别潜在的欺诈交易模式,并为后续的机器学习建模奠定基础。 具体目标: 数据理解:分析数据的分布...
3. 特征工程
在这一部分,我们将对数据进行特征工程处理,包括特征选择、数据预处理以及数据集划分,为后续建模做准备。 3.1 特征选择 我们需要确定哪些特征对于欺诈交易检测是重要的,可能需要去除无用特征...
4. 模型选择与构建
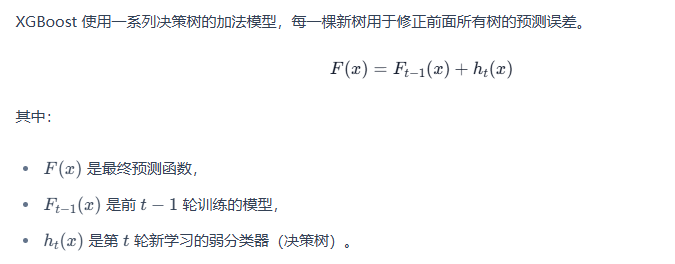
选择一个适合的模型进行欺诈交易检测,并详细介绍其原理及适用性。 此外,我们会进行多维度数据分析,以提高欺诈识别的准确性。 4.1 模型选择 在欺诈交易检测问题中,我们面临以下几个挑战: 类...
5. 模型训练与评估
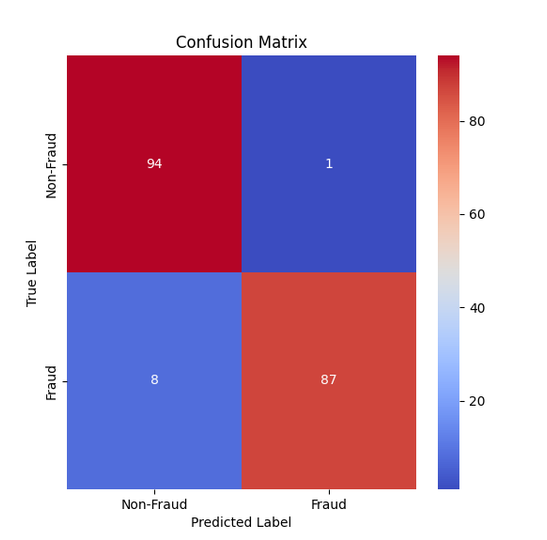
在这一部分,我们对 XGBoost 模型进行训练,并使用多种指标评估其性能。 接着,我们会进行超参数优化(使用网格搜索或随机搜索),以提升模型效果,并可视化模型的表现。 5.1 模型训练 在上一部...
6. 结果分析与解读
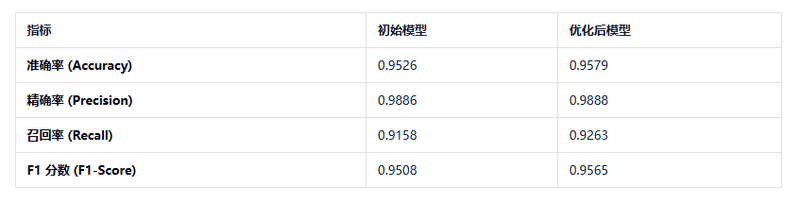
在本部分,我们将详细解读模型的评估结果,分析欺诈交易检测的有效性,并提供对业务的指导性见解。 6.1 评估结果回顾 在第 5 部分,我们训练了 XGBoost 模型,并使用** 随机搜索(Ran...
九、垃圾邮件检测的基础探索
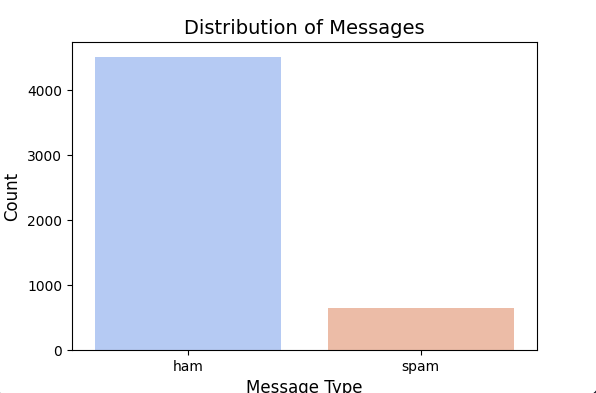
1. 目标定义和假设设定 1.1 背景介绍 在现代通信中,垃圾短信(Spam SMS)不仅影响用户体验,还可能涉及诈骗、广告骚扰等问题。因此,自动化垃圾短信检测是一个重要的任务。通过机器学习,我们...
3. 特征工程
在完成数据探索之后,我们需要将短信文本转换为机器学习可用的特征,以便进行分类任务。 这部分包括以下内容: 处理类别标签:将垃圾短信(Spam)和正常短信(Ham)转换为数值型标签。 文本特征...
4. 模型选择与构建
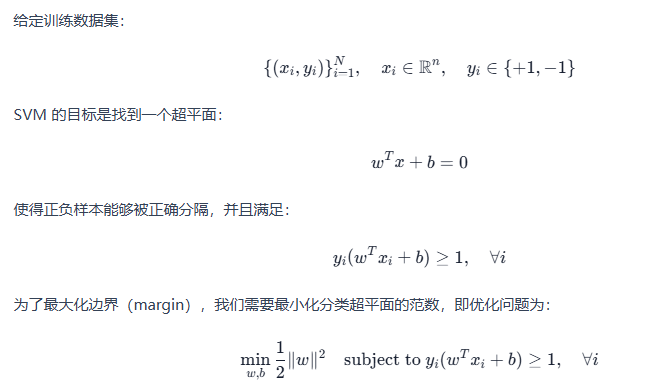
我们需要构建一个既能处理高维稀疏文本数据,又能具备较好泛化能力的分类模型。 经过对数据特点的分析,我们选择 支持向量机(Support Vector Machine, SVM) 作为主要模型,具体原因...
5. 模型训练与评估
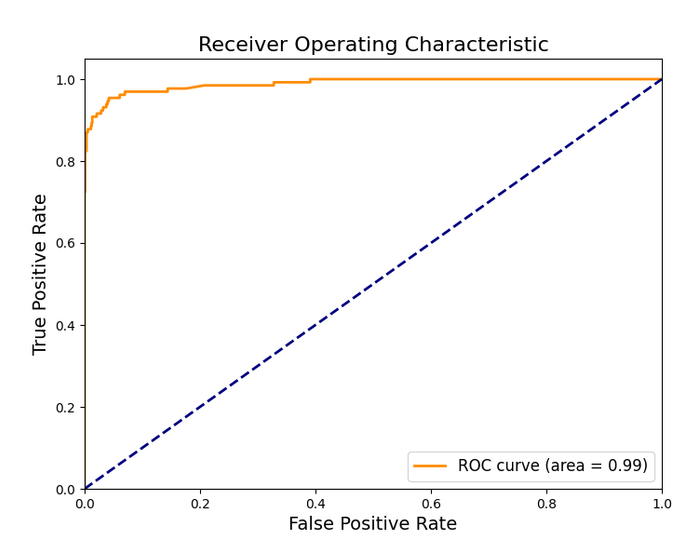
在这一部分,我们将详细介绍如何使用 Python(基于 sklearn)训练 SVM 模型,并评估其性能。 步骤包括: 模型训练 利用网格搜索(Grid Search)对超参数(如正则化参数 C 以及最大迭代次数 max_...

