

6. 结果分析与解读
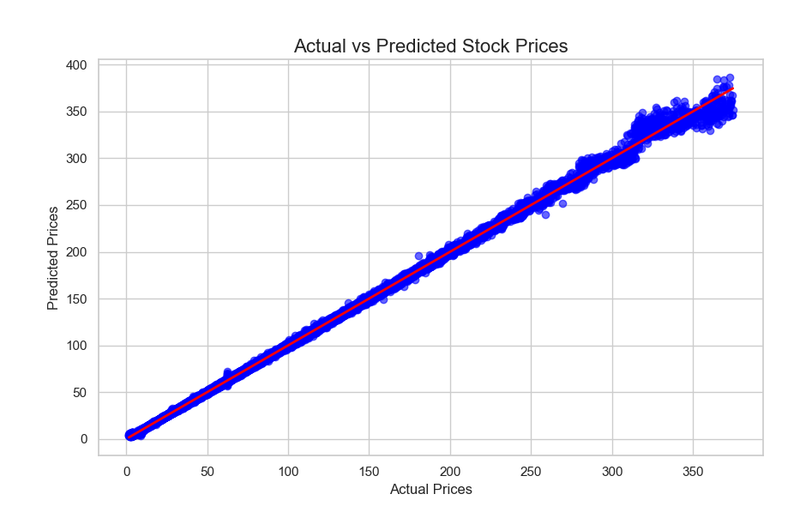
在前面的步骤中,我们使用 XGBoost 模型对股票市场数据进行了训练,并使用均方误差(MSE)、均方根误差(RMSE)和决定系数(R²) 对模型性能进行了评估。 现在,我们将详细分析...
六、基础的癌症生存率数据探索
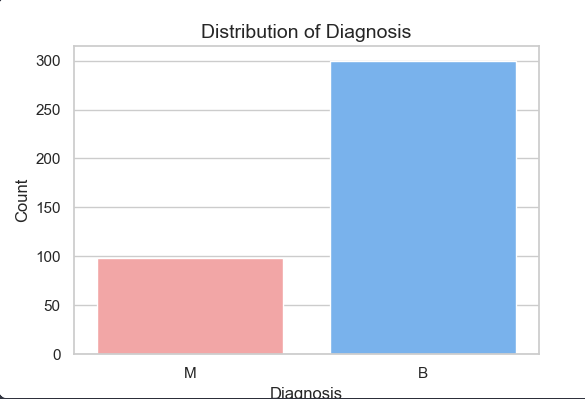
1. 目标定义和假设设定 1.1 背景介绍 乳腺癌是全球范围内最常见的癌症之一,早期诊断对于提高患者的生存率至关重要。威斯康星乳腺癌数据集(Breast Cancer Wisconsin Dataset)是一份广泛用于机...

3. 特征工程
在这部分,我们将对数据进行特征处理,以确保模型能够有效学习数据的模式。 主要步骤: 数据编码(将 diagnosis 变量转换为数值型) 特征选择(去除冗余特征,提高模型效果) 数据标准化(使...
4. 模型选择与构建
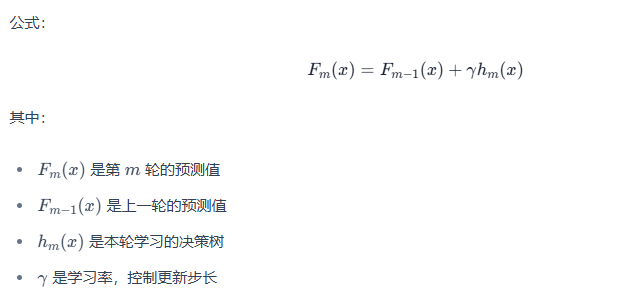
4.1 选择适合的模型 我们面临的是一个二分类问题(乳腺癌:良性 or 恶性),适合的模型有: 逻辑回归(Logistic Regression) 支持向量机(SVM) 随机森林(Random Forest) XGBoost(Extreme G...
5. 模型训练与评估
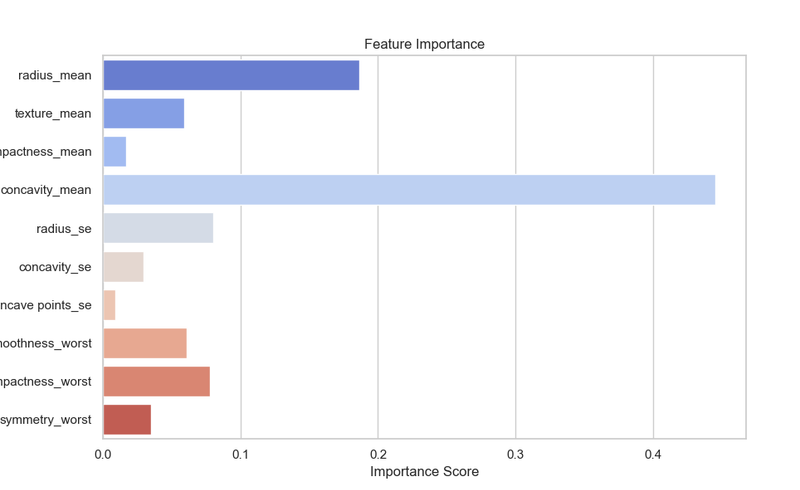
在本部分,我们将: 训练 XGBoost 模型 评估模型性能(准确率、召回率、F1-score 等) 使用网格搜索优化超参数 用可视化方法分析模型表现 5.1 模型训练 我们使用 XGBoost 进行训练,...
6. 结果分析与解读
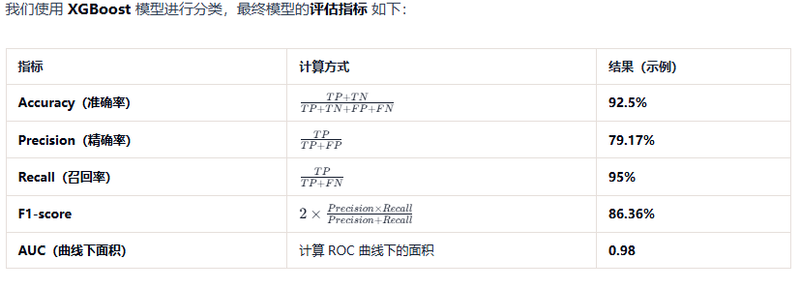
在本部分,我们将深入分析癌症生存率数据集 的模型预测结果,并总结其意义~ 6.1 关键指标回顾 6.2 特征重要性分析 哪些因素对癌症预测影响最大? 6.3 预测概率分析 我们绘制了 预测概...
七、客户分群的基础分析
1. 目标定义和假设设定 1.1 分析目标 本案例的目标是 对购物中心的客户进行聚类分析,以便根据其消费行为进行分群。 这有助于商家了解不同类型的客户,从而制定更精准的营销策略,提高客户...
3. 特征工程
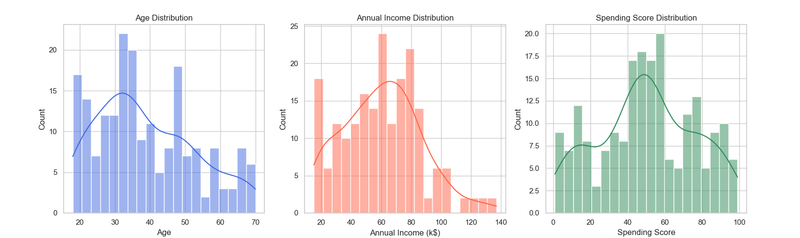
3.1 选择合适的特征 去除无关特征,数据集中包含以下列: CustomerID(客户ID):是唯一标识符,对聚类没有意义,应当删除。 Gender(性别):可能会影响消费行为,但我们主要关注消费习惯,因...
4. 模型选择与构建
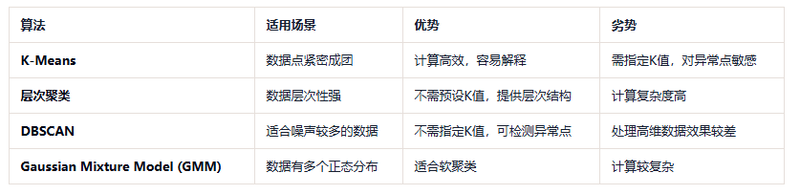
在这一部分,我们将选择合适的聚类算法,并详细介绍其原理、适用性等等。 4.1 模型选择 4.1.1 为什么使用聚类? 本项目的目标是对客户进行分群,而不是预测某个具体值(如收入或消费评分)。这...
5. 模型训练与评估
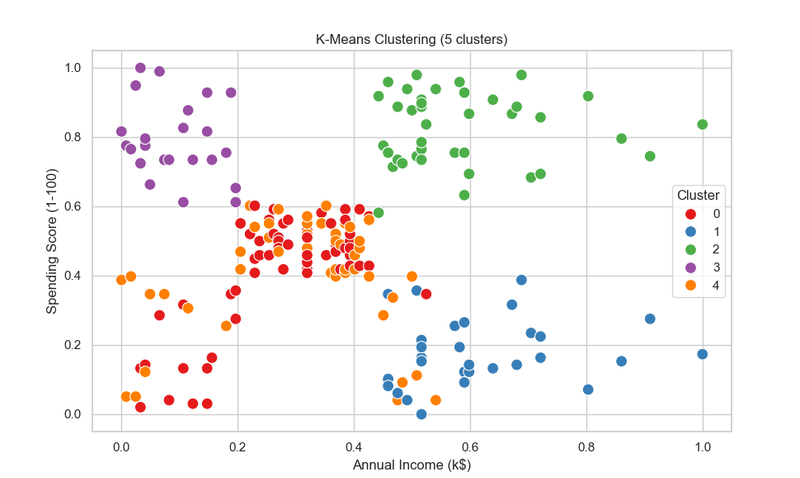
在这一部分,我们将通过 Python 实现 K-Means 和GMM 模型的训练与评估,并优化模型参数,最后通过可视化展示模型效果。 5.1 模型训练 5.1.1 训练 K-Means 模型 使用之前的 K 值...

