
2026年11月的文章 第53页

3.4.3 SGD
在神经网络的学习过程中,可以使用梯度下降法来更新参数,目标就是减小损失函数的值。 实际操作时,一般会从训练数据中随机选择一个小批量数据(mini-batch),然后用梯度下降法迭代多个轮次(i...
 16天前
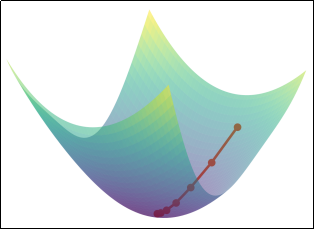
3.4 随机梯度下降法(SGD)
3.4.1 梯度下降法 梯度下降法(Gradient Descent)是一种用于最小化目标函数的迭代优化算法。核心是沿着目标函数(如损失函数)的负梯度方向逐步调整参数,从而逼近函数的最小值。梯度方向指示...
16天前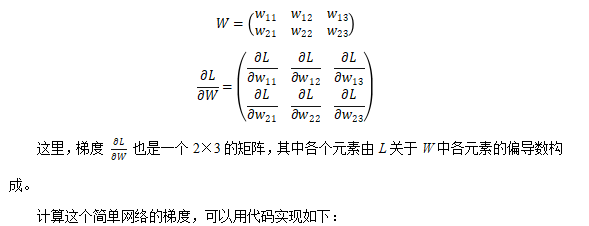
3.3 神经网络的梯度计算
在神经网络的学习中,梯度的计算非常重要。神经网络中的梯度,指的就是损失函数关于权重参数的梯度。 我们以一个单层的简单网络为例,形状为2×3,权重参数为W,损失函数记为L。那么它的权重参...
16天前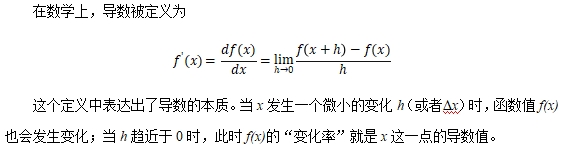
3.2 数值微分
损失函数的值越小,代表我们选取的参数越适合;想要求得损失函数的最小值,最基本的想法就是对函数求导,解出导数值为0的点,并判断它是否为极小值/最小值。 然而,实际的函数直接求导,不容易...
16天前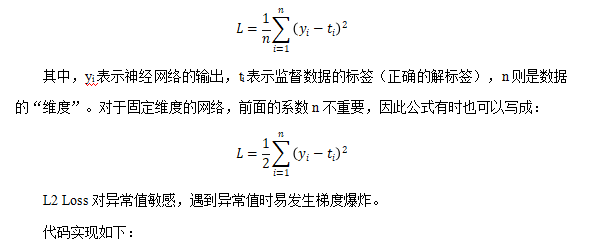
第 3 章 神经网络的学习
神经网络的主要特点,就是可以从数据中进行“学习”。这个学习的过程,就是让训练数据自动决定最优的权重参数。 神经网络(深度学习)也是机器学习的一种;跟传统机器学习方法相比,神经网络不...
16天前2.4 应用案例:手写数字识别
我们依然使用Digit Recognizer数据集来进行手写数字识别:https://www.kaggle.com/competitions/digit-recognizer。 文件train.csv中包含手绘数字(从0到9)的灰度图像,每张图像为28×28像素,...
16天前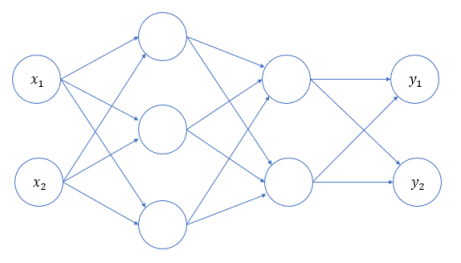
2.3 神经网络的简单实现
深度神经网络由多个层(layer)组成,通常将其称之为 模型(Model)。整个模型接受原始 输入(特征),生成 输出(预测),并包含一些 参数。而在模型内部,每个单独的层都会接受一些输入(由前...
16天前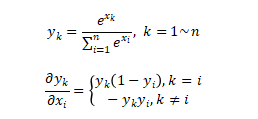
2.2.6 Softmax函数
Softmax将一个任意的实数向量转换为一个概率分布,确保输出值的总和为1,是二分类激活函数Sigmoid在多分类上的推广。Softmax常用于多分类问题的输出层,用来表示类别的预测概率。 Softmax会放大...
16天前
3.2.3 分词工具
概述 目前市面上可用于中文分词的工具种类繁多,按照实现方式大致可以分为如下两类: 一类是基于词典或模型的传统方法,主要以“词”为单位进行切分; 另一类是基于子词建模算法(如BPE)的方式...
16天前
