排序
第 5 章 学习的技巧
5.1 深度神经网络及其问题 5.1.1 深度学习 当神经网络的层数加深时,往往可以有效地提高识别精度;特别是对于大规模的复杂问题,通常都需要用更多的层来分层次传递信息,而且可以有效减少网络的...
 3小时前
6.3 张量创建
6.3.1 基本张量创建 1.torch.tensor(data)创建指定内容的张量 import torch import numpy as np # 创建标量张量 tensor1 = torch.tensor(10) print(tensor1) # 使用列表创建张量 tensor2 = torc...
3小时前
4.7 反向传播的综合代码实现
现在可以在之前手写数字识别案例的基础上,对SGD的计算过程进行优化。核心就是使用误差的反向传播法来计算梯度,而不是使用差分数值计算;这将大大提升学习的效率。 对于二层网络TwoLayerNet,...
3小时前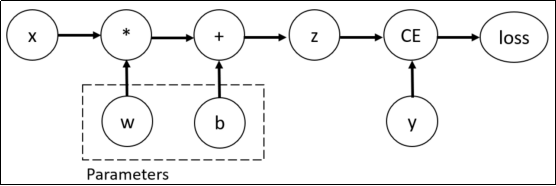
6.9 张量拼接操作
1)torch.cat()张量拼接,按已有维度拼接。除拼接维度外,其他维度大小须相同 import torch tensor1 = torch.randint(1, 9, (2, 2, 5)) tensor2 = torch.randint(1, 9, (2, 1, 5)) print(tensor...
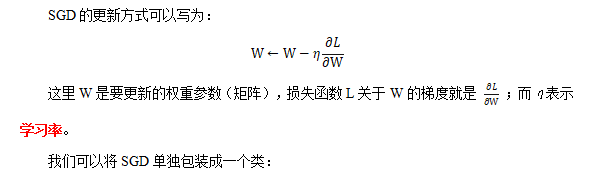
2小时前3.4.3 SGD
在神经网络的学习过程中,可以使用梯度下降法来更新参数,目标就是减小损失函数的值。 实际操作时,一般会从训练数据中随机选择一个小批量数据(mini-batch),然后用梯度下降法迭代多个轮次(i...
3小时前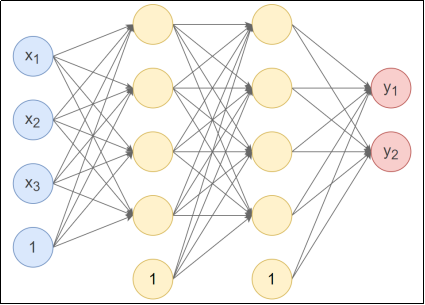
7.3 搭建神经网络
7.3.1 自定义模型 在神经网络框架中,由多个层组成的组件称之为 模块(Module)。 在PyTorch中模型就是一个Module,各网络层、模块也是Module。Module是所有神经网络的基类。 在定义一个Module...
2小时前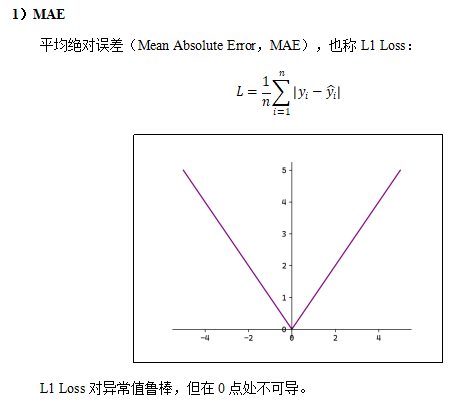
7.4.2 回归任务损失函数
import torch from torch import nn, optim class Model(nn.Module): # 初始化 def __init__(self): # 调用父类初始化 super(Model, self).__init__() ...
2小时前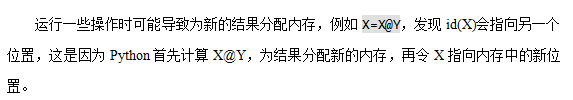
6.5.2 哈达玛积(元素级乘法)
两个矩阵对应位置元素相乘称为哈达玛积(Hadamard product)。 使用*、mul()实现两个形状相同的张量之间对位相乘。 import torch tensor1 = torch.tensor([[1, 2], [3, 4]]) tensor...
3小时前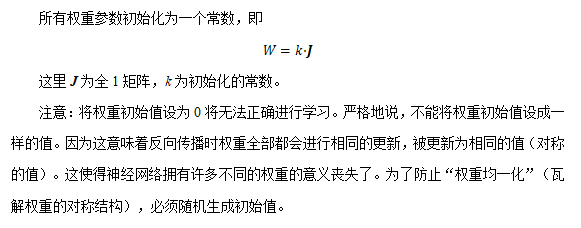
5.3 参数初始化
参数初始化方案的选择在神经网络学习中起着举足轻重的作用,它对保持数值稳定性至关重要。此外,这些初始化方案的选择可以与激活函数的选择有趣的结合在一起。我们选择哪个激活函数以及如何初始...
3小时前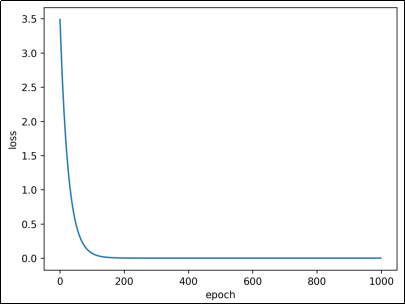
6.11 机器学习案例:线性回归
在此虚拟环境中没有matplotlib,先安装:pip install matplotlib==3.9。 通过PyTorch训练一个模型一般分为以下4个步骤: 准备数据 → 构建模型 → 定义损失函数与优化器 → 模型训练 接下来,构...
2小时前
