

7.2.1 决策树简介
决策树(Decision Tree)是一种基于树形结构的算法,根据一系列条件判断逐步划分数据,缩小范围,最终得出预测结果。决策树由4部分组成:
- 根节点:树的节点,包含所有数据。
- 内部节点:表示特征上的判断条件。
- 分支:根据判断条件分出的路径。
- 叶节点:最终分类或回归的结果。
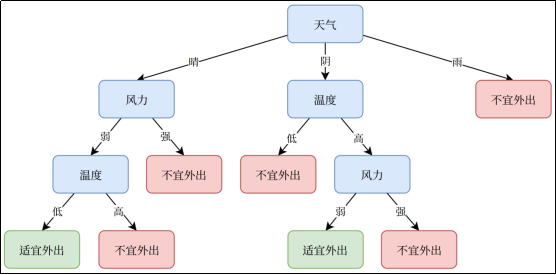
决策树适用于需要规则化、可解释性和快速决策的场景,尤其在数据特征明确、样本量适中的情况下表现良好。在复杂任务中,它常作为基础模型,与集成学习结合(如随机森林、梯度提升树)以提升性能。
7.2.2 决策树工作过程
决策树的学习通常包括3个步骤:特征选择、决策树的生成和决策树的剪枝。
如果特征数量很多,可以在决策树学习之前对特征进行选择,只留下对训练数据有足够分类能力的特征。
学习时通常是递归地选择最优特征,并根据该特征对训练数据进行划分,使得对各个子数据集有一个最好的分类。
- 首先构建根结点,将所有训练数据都放在根结点。
- 选择一个最优特征,按照这一特征将训练数据集划分成子集,使得各个子集有一个在当前条件下最好的分类。
- 如果这些子集已经能够被基本正确分类,那么构建叶结点,并将这些子集分到所对应的叶结点中去;如果还有子集不能被基本正确分类,那么就对这些子集选择新的最优特征,继续对其进行划分并构建相应的结点。
- 如此递归直至所有训练数据子集被基本正确分类,或者没有合适的特征为止。
最后每个子集都被分到叶结点上,即都有了明确的类,这就生成了一棵决策树。决策树的每次划分都相当于在特征空间中引入一个超平面将当前空间一分为二。
以上方法生成的决策树可能对训练数据有很好的分类能力,但对未知的测试数据却未必,即可能发生过拟合现象。因此需要对已生成的树自下而上进行剪枝,将树变得更简单,从而使它具有更好的泛化能力。具体地,就是去掉过于细分的叶结点,使其回退到父结点或更高的结点,然后将父结点或更高的结点改为新的叶结点。
决策树的生成只考虑局部最优,决策树的剪枝则考虑全局最优。
7.2.3 特征选择与决策树生成
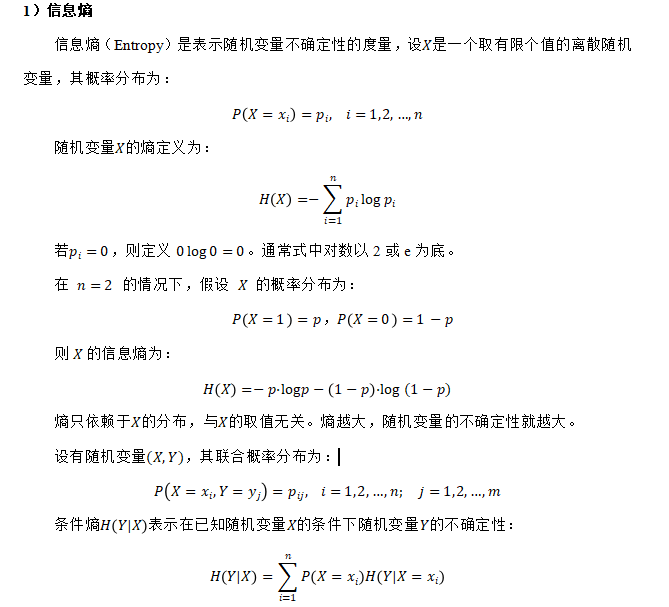
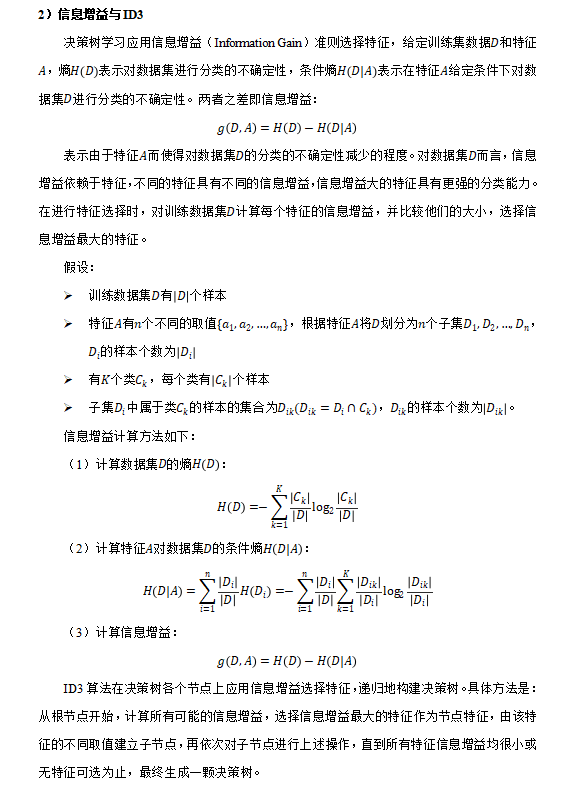
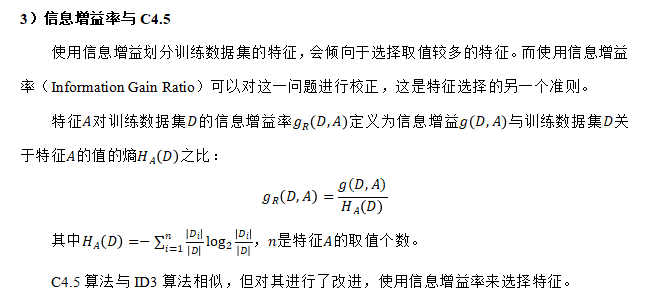
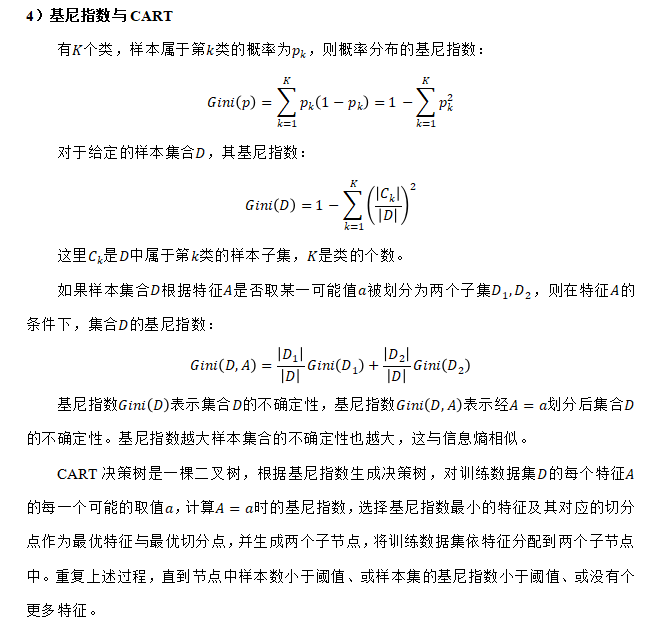
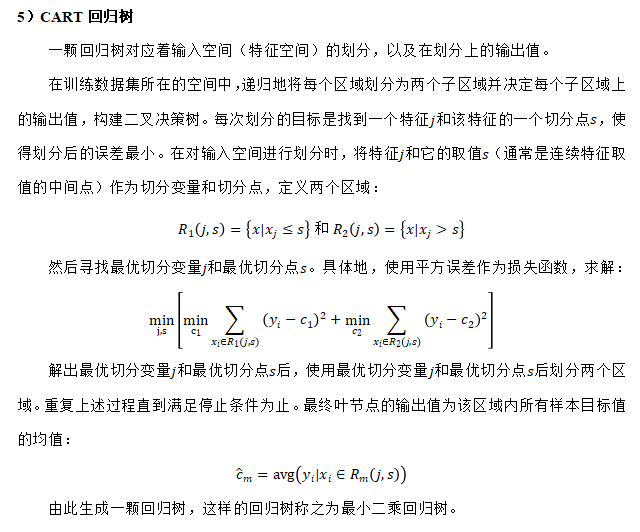
特征选择在于选取对训练数据具有分类能力的特征,这样可以提高决策树学习的效率。如果利用一个特征进行分类的结果与随机分类的结果没有很大差别,则称这个特征是没有分类能力的,经验上扔掉这样的特征对决策树学习的精度影响不大。通常特征选择的准则是信息增益或信息增益率。
7.2.4 决策树的剪枝
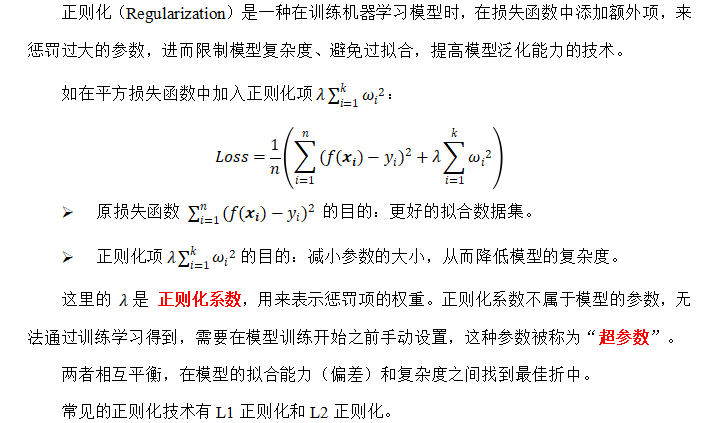
决策树出现过拟合的原因在于学习时过多的考虑如何提高对训练数据的正确分类,从而构建出过于复杂的决策树。为了避免过拟合,可以对已生成的决策树进行剪枝,从决策树上裁掉一些子树或叶节点,并将其根节点或父节点作为新的叶节点,从而简化模型。
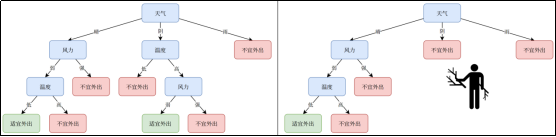
决策树的剪枝通常分为预剪枝(Pre-Pruning)和后剪枝(Post-Pruning)。
预剪枝是在决策树生成过程中,通过设置一些限制条件提前停止树的生长,避免过度分裂。常见的停止条件有:限制最大树深度、限制每个节点最小样本数、限制最小的误差减少量、限制最大叶节点数量等。但过于严格的停止条件可能导致欠拟合,并且可能难以确定最佳阈值,需要多次尝试。
后剪枝是在决策树完全生成之后,基于某种评估准则从底部向上逐步判断是否移除分支。常见的后剪枝方法有代价复杂度剪枝(Cost-Complexity Pruning,CCP)和减少误差剪枝(Reduced Error Pruning,REP)等。










请登录后查看评论内容