

4.3.1 概述
Gated Recurrent Unit(GRU)是为了进一步简化 LSTM 结构、降低计算成本而提出的一种变体。GRU 保留了门控机制的核心思想,但相比 LSTM,结构更为简洁,参数更少,训练效率更高。
在许多实际任务中,GRU 能在保持类似性能的同时,显著减少训练时间。
4.3.2 基础结构
与LSTM相比,GRU做出了以下改进:
- 取消了LSTM中独立的记忆单元,只保留隐藏状态。
- 通过两个门控结构控制信息流动:更新门(Update Gate)和 重置门(Reset Gate)。
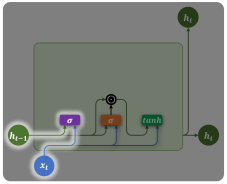
具体结构如下图所示:
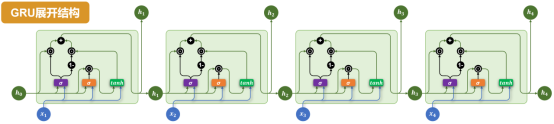
各部分说明如下:
- 重置门(Reset Gate)
重置门由上一个时间步的隐藏状态和当前时间步的输入计算得到:
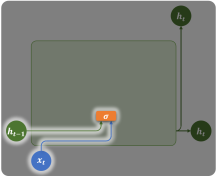
计算公式如下:
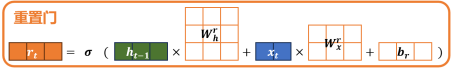
重置门会在计算当前时间步信息(候选隐藏状态)时,作用在上一个时间步的隐藏状态,用于控制遗忘多少旧信息,如下图所示:
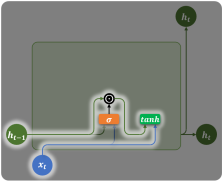
当前时间步的信息(候选隐藏状态)的计算公式为:
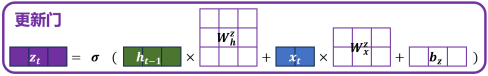
- 更新门(Update Gate)
更新门也由上一时间步的隐藏状态和当前时间步的输入计算得到,如下图所示
计算公式为
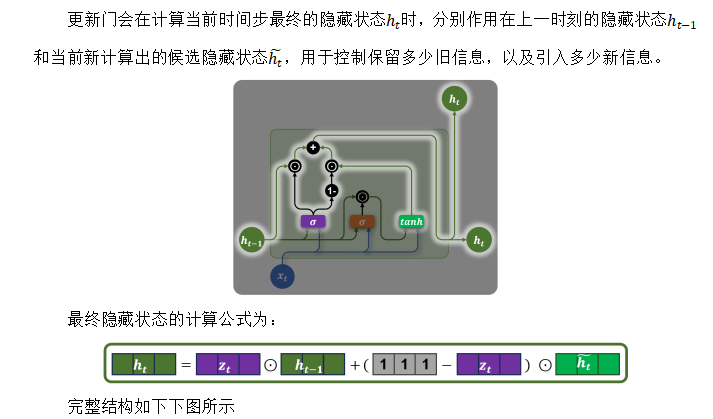
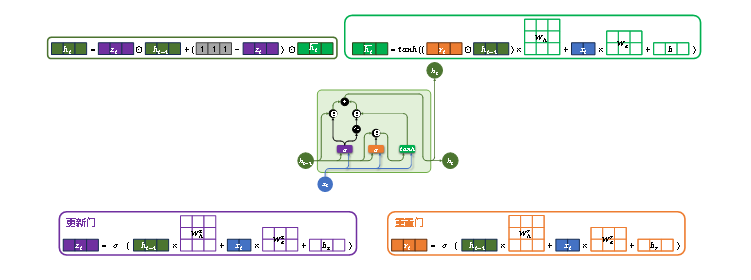
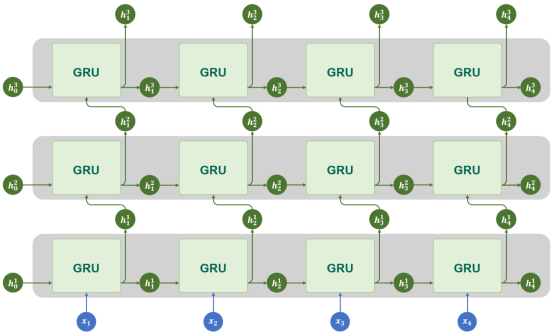
4.3.3 多层结构
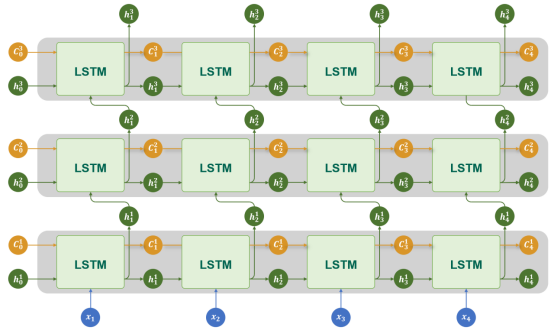
GRU同样支持多层结构
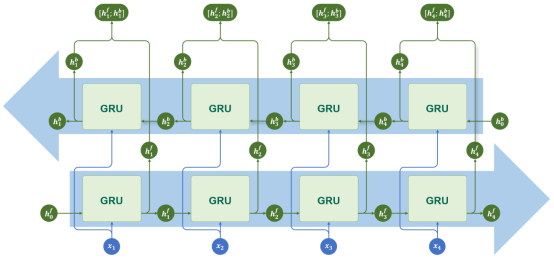
4.3.4 双向结构
GRU同样支持双向结构
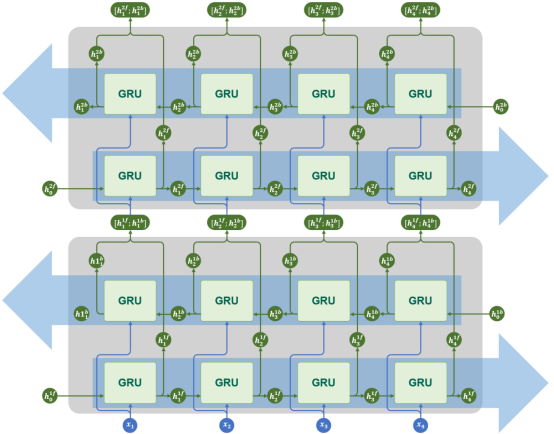
4.3.5 多层+双向结构
GRU同样支持多层结构和双向结构
4.3.6 API使用
torch.nn.GRU 是 PyTorch 中实现门控循环单元(Gated Recurrent Unit, GRU)的模块。它用于对序列数据建模,在自然语言处理(NLP)、时间序列预测等任务中广泛使用。该模块支持单层或多层 GRU,可选择是否使用双向结构(bidirectional)。
torch.nn.GRU与torch.nn.RNN的API几乎完全相同。
- 参数说明
构造GRU层所需的参数如下:
torch.nn.GRU(input_size, hidden_size, num_layers=1, bias=True, batch_first=False, dropout=0.0, bidirectional=False, device=None, dtype=None)各参数含义如下
| 参数名 | 类型 | 说明 |
| input_size | int | 每个时间步输入特征的维度(词向量维度) |
| hidden_size | int | 隐藏状态的维度 |
| num_layers | int | RNN 层数,默认为 1 |
| bias | bool | 是否使用偏置项,默认 True |
| batch_first | bool | 输入张量是否是 (batch, seq, feature),默认 False 表示 (seq, batch, feature) |
| dropout | float | 除最后一层外,其余层之间的 dropout 概率 |
| bidirectional | bool | 是否为双向 RNN,默认 False |
| device | torch.device or str | 模块的初始化设备,如 ‘cuda’, ‘cpu’ |
| dtype | torch.dtype | 模块初始化时的默认数据类型,如torch.float32 |
2.输入输出
示例代码如下
gru= torch.nn.GRU()
output, h_n = gru(input, h_0)
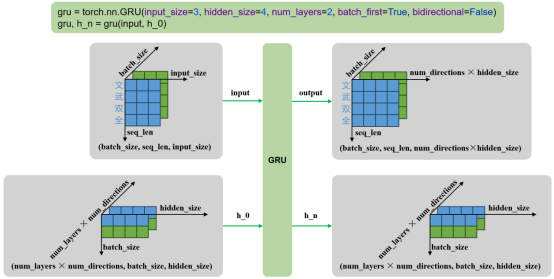
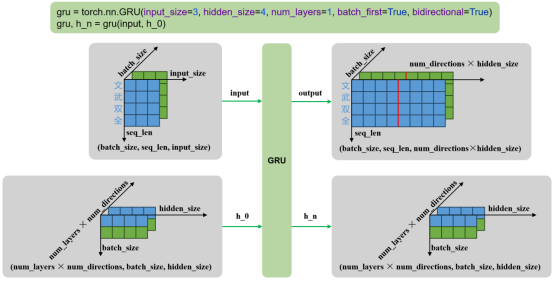
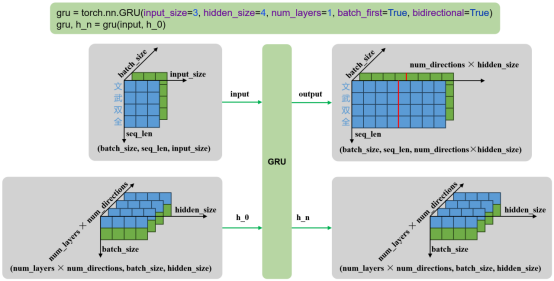
输入输出内容如下
| 输入 | input | 输入序列,形状为(seq_len, batch_size, input_size),如果 batch_first=True,则为 (batch_size, seq_len, input_size) |
| h_0 | 可选,初始隐藏状态,形状为 (num_layers × num_directions, batch_size, hidden_size) | |
| 输出 | output | RNN层的输出,包含最后一层每个时间步的隐藏状态,形状为 (seq_len, batch_size, num_directions × hidden_size ),如果如果 batch_first=True,则为(batch_size, seq_len, num_directions × hidden_size ) |
| h_n | 最后一个时间步的隐藏状态,包含每一层的每个方向,形状为 (num_layers × num_directions, batch_size, hidden_size) |
输入输出形状如下
- 单层单向
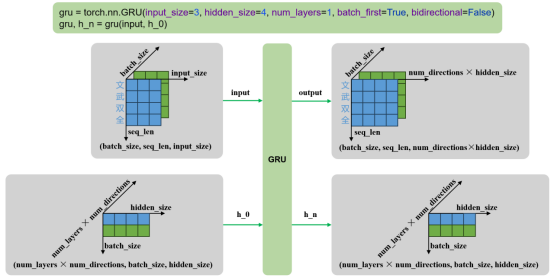
- 多层单向
- 单层双向
- 多层双向
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容