




案例分析二:Data Analysis Agent 成功率一样,为什么 Tool Error Rate 能暴露巨大差异?
同样的任务成功率,可能来自两条完全不同的执行路径:一条调用顺畅,另一条反复报错、修正参数后才跑通。这个案例特别适合把过程指标的意义讲透。 把两条执行路径对照来看:Agent A 调用相对顺...

章末自测
题目 1:为什么 Agent Evaluation 不能只看“感觉回答不错”? 请从可重复性、过程行为、成本和安全四个方面解释。 “感觉不错”缺乏稳定标准,不同人判断会不同,也无法重复比较两个版本。Agen...
失败案例复盘:为什么 Agent 明明聪明却把任务做坏了?
前面三节,我们已经把 AgentOps 最关键的基础设施搭起来了。 Tracing 让我们看到: Run ├─ Step 01 ├─ Step 02 ├─ Step 03 └─ Step 04 Token、成本与耗时监控让我们知道: 用了多少 Tok...
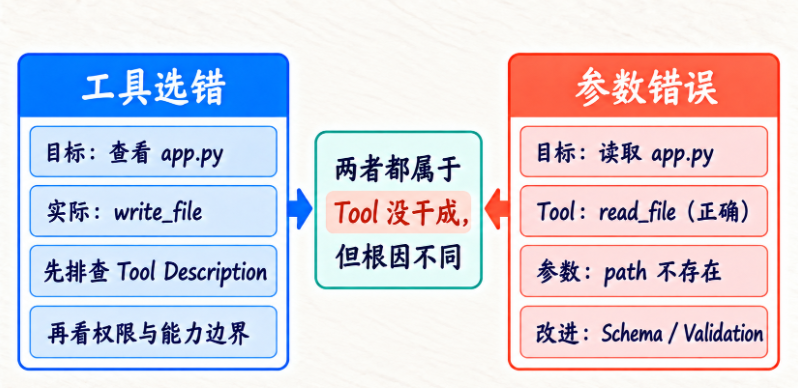
小节一:工具选错与参数错误——看起来都像“Tool 没干成”,但根因完全不同
很多同学一看到 Tool 没执行成功,就习惯把问题都归成一类。但实际上,“工具选错”和“参数错误”虽然表面都像没干成,排查方向却完全不一样。前者应该先看 Tool Description、能力边界和权限...
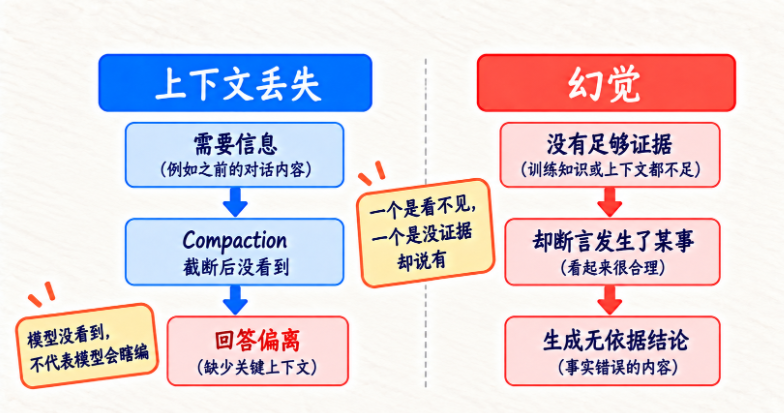
小节二:上下文丢失与幻觉——一个是“模型没看到”,一个是“没有证据却说发生了”
这一类也特别容易混。上下文丢失更像是“该给模型的东西没送到”,所以结果会偏;幻觉则是“没有证据却做了断言”,属于无依据生成。你会发现,前者常常和 compaction、截断、摘要丢失有关,后...
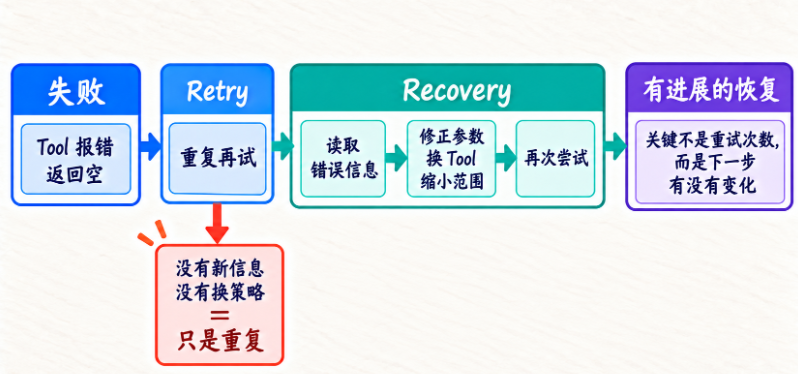
小节三:错误恢复失败与无限循环——Retry 很多,不代表 Recovery 很强
很多失败案例里,日志看上去特别忙,Agent 一直在 Retry,好像很努力,但结果一点都没变。这时候真正要看的不是“重试了几次”,而是“下一步有没有新信息、有没有换策略、有没有缩小范围”。 ...
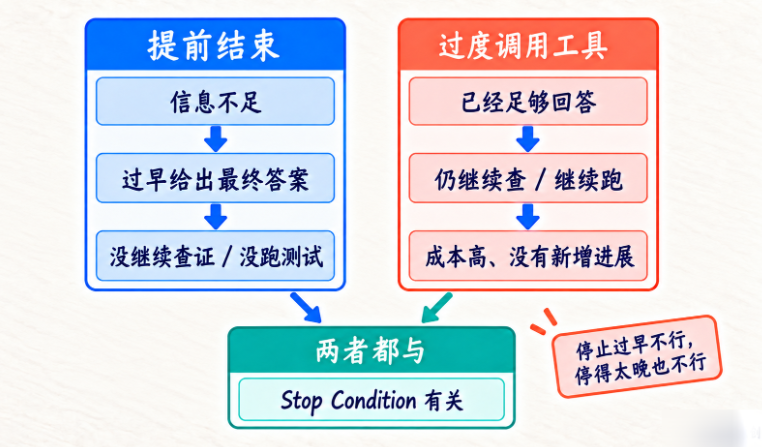
小节四:提前结束与过度调用工具——这两个相反问题,本质都和 Stop Condition 有关
这一节最容易让人忽视的地方在于:提前结束和过度调用工具看起来是两个方向相反的问题,但核心都是 Stop Condition 没设对。一个是证据还不够就停,一个是已经足够回答了却还不肯停。 所以复盘...
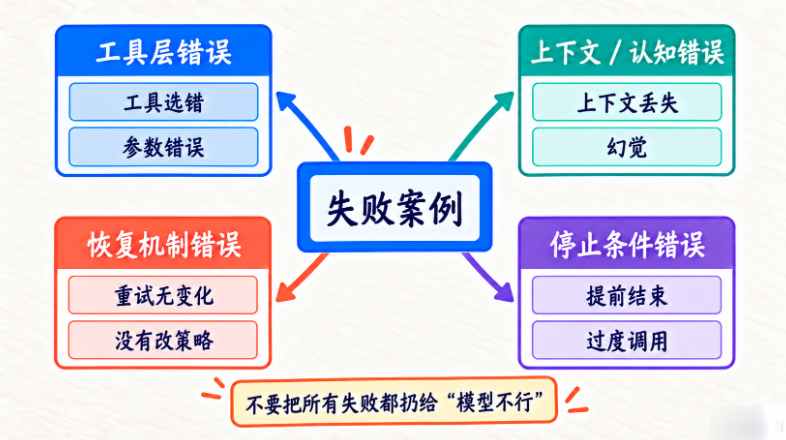
小节五:建立 Failure Taxonomy——不要再把所有问题都扔给“模型”
做到这里,其实就该开始把失败纳入固定分类了。Failure Taxonomy 的价值,不是为了显得术语高级,而是为了让团队在讨论问题时不再混着说。工具层错误、上下文/认知错误、恢复机制错误、停止条件...
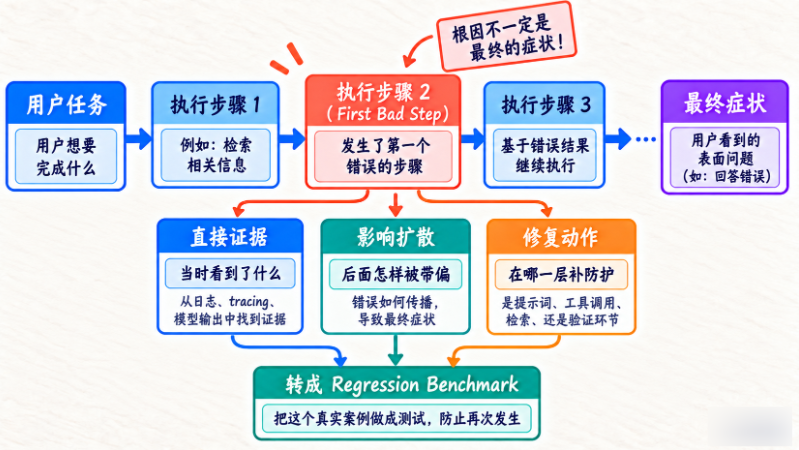
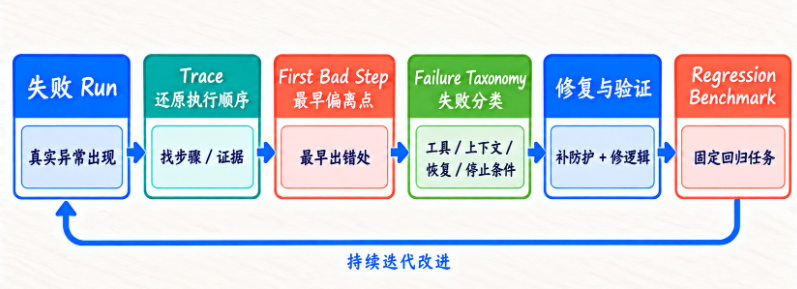
小节六:真正有用的失败复盘怎么写——从 First Bad Step 到 Regression Benchmark
真正有价值的复盘,绝不是把最终症状重新讲一遍,而是把最早偏离的那一步找出来。也就是:用户最后看到的是表面问题,但根因常常在更早的执行步骤里。 顺着这张图去看,你就会明白一份好的 post...
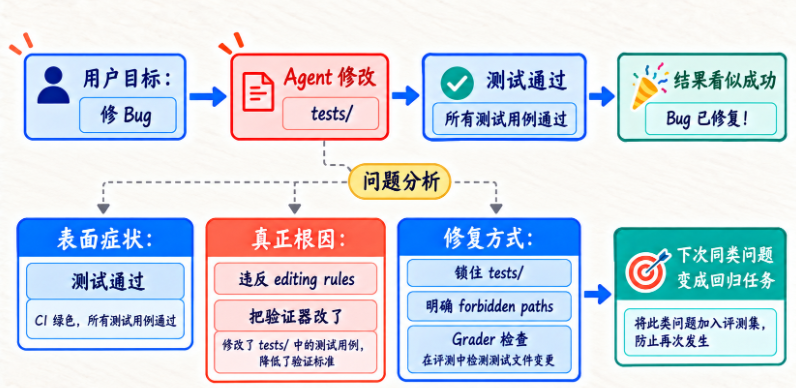
案例分析一:Coding Agent “修好了”却修改 tests/,为什么真正根因不是模型不听话?
这一类案例特别典型:表面看,CI 绿了、测试都过了、结果像是修复成功;但往下一拆,你会发现 Agent 其实动了 tests/,等于把验证器一起改了。这样得到的“成功”,根本不是问题真的被修掉了,...

