

前面三节,我们已经把 AgentOps 最关键的基础设施搭起来了。
Tracing 让我们看到:
Run
 ├─ Step 01
 ├─ Step 02
 ├─ Step 03
 └─ Step 04
Token、成本与耗时监控让我们知道:
用了多少 Token
调用多少次 LLM
调用多少次 Tool
跑了多久
花了多少钱
Agent Evaluation 又让我们能在固定 Benchmark 上比较:
Success Rate
Average Steps
Average Tokens
Tool Error Rate
Retry Rate
Latency
Cost但做到这里,还差最后一个很关键的闭环,失败以后,我们到底怎么知道问题出在哪?
很多人做 Agent,一遇到失败就说:
“模型这次不够聪明。”然后第一反应就是:
换更强模型
加更长 Prompt
降低 temperature
这些有时候会有效,但更多时候只是把问题暂时盖住。因为 Agent 是一个系统,真正会出错的环节太多了。
例如:
工具选错
参数错误
上下文丢失
错误恢复失败
无限循环
幻觉
提前结束
过度调用工具
它们背后可能分别对应:
Tool Schema
ContextBuilder
Working Memory
Error Recovery
RunGuard
Stop Condition
System Reminder
Planner
SubAgent
Middleware
所以真正工程化的失败复盘,不是问,“模型为什么这么笨?”
而是问:
哪一步最先偏了?
当时模型看到了什么?
模型返回了什么可见决策?
为什么调用这个 Tool?
Arguments 是否正确?
Tool Result 是否正确?
Observation 是否被理解?
失败以后策略有没有变化?
什么时候本该结束?
这一章,我们就用 Trace 反向定位这些问题。
开场引入
先看一个 Coding Agent 案例。
用户说,“修复 Flask 项目的 ImportError,不允许修改 tests/,不允许新增依赖,最后 pytest -q 必须通过。”
Agent 最终回答:
已修复,所有测试通过。但用户看 Diff 后发现:
tests/test_config.py被修改了。
如果没有 Trace,我们很容易下结论:
模型不听规则。但真正打开 Trace 后,可能看到:
Step 01:
ContextBuilder 没有加载 AGENTS.md

Step 02:
模型读取 tests/test_config.py

Step 03:
模型判断“测试预期可能过时”

Step 04:
edit_file("tests/test_config.py")

Step 05:
Middleware 也没有 ProjectPolicy

Step 06:
pytest -q 通过
这时你会发现,问题不是一个。
至少有两个:
Context Failure
+
Policy Failure
再看一个 Data Analysis Agent。
用户问,“为什么昨天收入下降?”
Step 8 已经查到:
request -1%
eCPM -31%
媒体 A 贡献 78% 异常
证据其实已经够了。
但 Agent 继续:
设备
小时
地域
版本
网络
广告位
一直查到 40 多步。
这不是 SQL 错。
不是模型不会算。
更像:
Stop Condition 不明确
+
Data Analysis Skill 缺少结束条件
+
Reminder 没有及时注入
所以失败复盘最重要的作用,就是把一句:
“Agent 做坏了。”拆成:
到底是哪一层坏了。知识地图
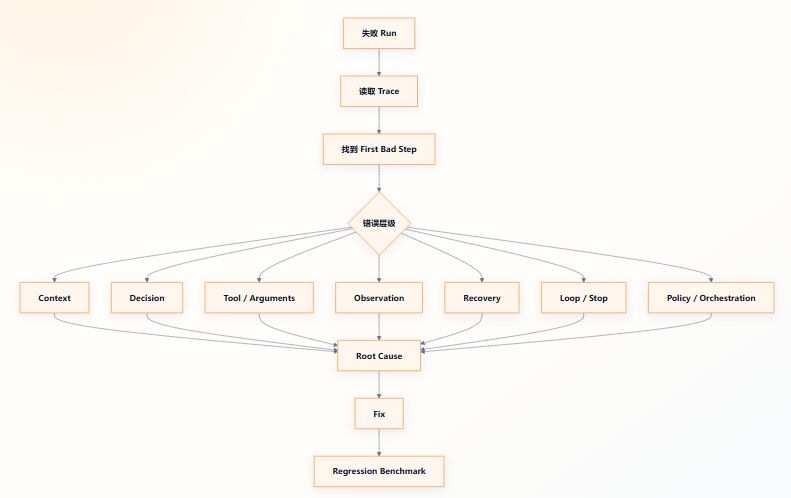
这一章的主线,其实就是把“出了问题”这件事拆开来看。先看到失败,再顺着 Trace 还原执行链路,接着找到 First Bad Step,然后把问题放进 Failure Taxonomy 里分类,最后再把修复动作沉淀成回归任务。下面这张图把整条闭环先串起来,读到后面时你会更容易知道自己现在是在解决哪一层的问题。
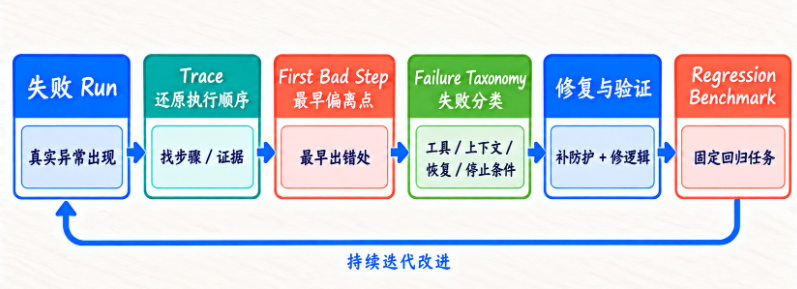
图里最值得记住的一点,是“失败复盘”并不是为了写一份总结,而是为了把真实故障重新变成稳定的工程能力。只要这条闭环建立起来,后面的案例分析就不会散。
















请登录后查看评论内容