

真正有价值的复盘,绝不是把最终症状重新讲一遍,而是把最早偏离的那一步找出来。也就是:用户最后看到的是表面问题,但根因常常在更早的执行步骤里。
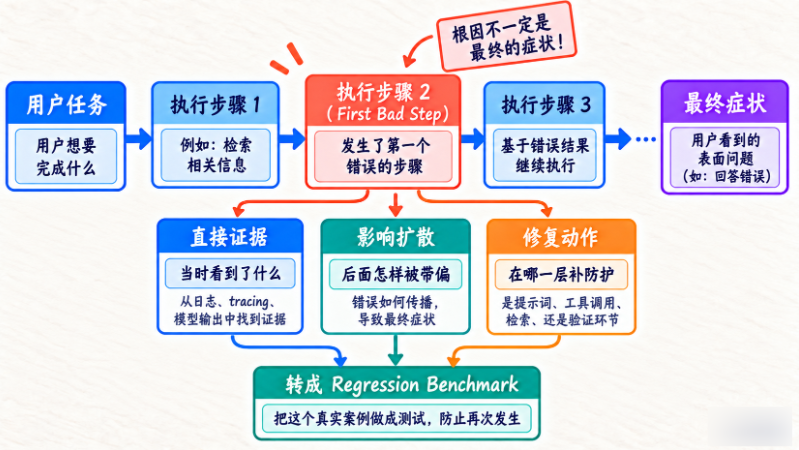
顺着这张图去看,你就会明白一份好的 postmortem 至少要回答四个问题:最早错在哪、证据是什么、错误如何扩散、最后应该补哪一层防护。只有这样,复盘才能自然落到回归测试上。
失败复盘最好固定成模板。
先把一组容易混在一起的词拆开。症状 是我们直接看到的异常,例如 Run 在第 30 步超限;触发条件 是当时让问题暴露的输入或环境,例如一个不存在的文件路径;直接原因 是紧邻故障的错误动作,例如连续重试同一参数;系统根因 则要回答“为什么 Harness 允许这个错误持续发生”,可能是没有 No-progress Gate;辅助因素 会放大影响,却不一定单独造成事故。
这个区分很重要。“最后报了 MAX_STEPS_EXCEEDED”是症状,“所以步数上限太小”却是没有证据的跳跃。把上限从 30 改成 60,可能只是让同一个错误多消耗一倍资源。
1. Task
写清:
用户任务
约束
Success Criteria
2. Observed Failure
不要写:
Agent 不行。要写具体:
修改了 tests/
结论与 SQL 相反
重复调用 query_sql 42 次
未跑全量测试就结束
3. First Bad Step
这是最关键的。
不是找:
最后 FAILED 的 Step。而是找,最早偏离正确执行路径的 Step。
例如最终:
Step 30:
MaxStepsExceeded
但真正 First Bad Step 可能:
Step 8:
收到同样 AssertionError 后仍重复同样 edit。
如果只修:
MAX_STEPS 从 30 改 50问题反而更严重。
4. Trace Evidence
列出支持根因的证据:
Prompt
LLM Response
Tool
Arguments
Tool Result
State
Policy
5. Root Cause
例如:
AGENTS.md 未注入 Context而不是:
模型没认真看。6. Contributing Factors
很多事故不是单一原因。
比如:
Context 丢规则
+
Middleware 没硬拦截
7. Fix
修具体层:
ContextBuilder
Tool Schema
RunGuard
Middleware
Stop Condition
8. Regression Benchmark
最后必须把失败样本加入固定 Benchmark。
这一步非常重要。
因为,一次修好,不等于以后永远不会回归。
一个简单 FailureReport
这份报告以后可以:
入库
做 Dashboard
关联 Trace
关联 Benchmark
让失败真正变成团队资产。
配套项目中的 FailureReport 还会检查 Failure Type、时间线、置信度和措施状态。只有根因已有 Trace Evidence、所有纠正措施都已验证,且报告进入 resolved 后,才能导出 Regression Case。写了一条“后续优化 Prompt”并不等于问题已经关闭。
从第一个错误决定,追到可验证的修复
我们看到最终报告说“已修复”,测试却仍然失败。先不要直接归因于模型能力,沿 Trace 往前找:工具是否执行、结果是否进入上下文、完成门禁是否检查、错误是否被忽略。最早偏离正确路径的位置,往往比最后一句错误回答更接近可修复原因。
复盘时区分观察与推断。“测试返回码为 1”是观察,“模型没有理解错误”是推断,还需要请求快照或行为证据支持。若轨迹本身缺失,就先说明无法确认的部分,避免把猜测写成确定根因。
找 First Bad Step,不是找第一个看起来可疑的 Step
我们可以用“最后正常状态→第一个错误转换”来缩小范围。先从终态向前找最后一份确定可信的状态,再逐步检查 Context、Decision、Policy、Tool 和 Observation。候选 Step 找到后,问一个反事实问题:如果这里换成正确输入或正确决策,后续失败是否大概率不再发生?
这个检查可以防止我们把无关差异当成根因。例如 Step 5 的 Prompt 比上一版长 200 Token,只能说两版不同;要证明它造成了越权写入,还要有规则未进入 Context、Decision 忽略约束或 Policy 未拦截的证据。时间上先发生,不自动等于因果上导致。
轨迹不完整时,“无法确认”比编一个根因更专业
如果 Tool 只有 started 没有终态,或者中间某段 Context 被采样丢弃,我们可以确认的只是“证据链不完整”。这时将 Failure Type 暂时记为 unknown,把缺失事件列入 unknowns,再补 Collector、持久化或关联 ID,是正常的调查结果。
自动检测器可以标出“相同 Tool + Arguments + Error 连续出现”、“没有验证证据却进入 COMPLETED”或“Policy DENY 后出现同一 Tool 的 completed”。它们是调查信号,不是自动根因判定。人仍然需要把信号放回任务、输入和系统边界中解释。
单次轨迹适合查事实,失败聚类更适合定优先级
模型具有随机性,同一任务可能有多种失败路径。看完一条 Trace 以后,我们还要检查它是偶发样本,还是某个 Agent/Model/Prompt/Tool 版本上的稳定模式。可以按 Failure Type、Error Signature、First Bad Step 动作、Tool 版本和任务类别聚类,再看频率、影响和趋势。
一次低影响偶发与一个正在快速上升的越权模式,优先级完全不同。严重度不应只由是否 FAILED 决定:已被 Policy 阻止、没有产生真实损害的高风险 Near Miss,仍然值得按安全事件复盘。反过来,用户主动取消一个正常 Run,不应默认记成 Agent Failure。
最小修复完成后,将原始任务固定为回归案例,再补一个相邻正常案例。例如修复提前结束时,也要检查已经满足条件的任务能够停止,避免变成永远不允许完成。教材中的模拟案例可以保留,但应标明模拟输入和预期结果;未实际测量的数据不能写成真实效果。
一项修复要同时考虑预防、检测与缓解
假设根因是 ContextBuilder 漏了项目规则,预防措施 可以是让规则加载成为不可跳过的构建步骤;检测措施 可以是记录规则 fingerprint,在缺失时告警;缓解措施 则是让 Middleware 仍然硬拦截 tests/ 写入。只做其中一层,很可能还会留下单点失效。
每项措施都要有负责人、状态和验证方式。“已改 Prompt”是实施记录,不是有效性证据;“原始失败任务与相邻正常任务均通过,并在固定 Benchmark 上无新回归”才是。如果高风险问题暂时无法根治,先禁用相关 Tool、缩小权限或要求人工审批,同样是正式措施,不是“先凑合用”。
复盘针对系统条件,不针对某个人的性格
高质量复盘会写“发布流水线没有检查 Grader 版本”,而不是“某人不够仔细”。这并不是回避责任,而是把修复放到能阻止下一个人犯同样错误的位置。只有这样,复盘才会让大家愿意带着完整证据进来,而不是为了自保隐藏细节。
再补一条事故时间线,我们才能改进“多久能发现和止损”
对影响线上用户、数据或真实外部系统的失败,复盘还应记录开始、首次可观测异常、检测、缓解、恢复和完全修复的时间。这条时间线帮我们回答:问题持续了多久,监控是否太晚报警,有没有更快的降级或关停手段。
MTTD(平均检测时间)和 MTTR(平均恢复时间)可以用于看长期趋势,但单次复盘应优先保留原始时间点和实际影响。别为了让平均值好看,把未被监控发现、最后由用户报告的事故排除在外。
复盘附件通常包含 Prompt、Tool Arguments、数据库结果和用户输入,分享前要继续遵守 Trace 的脱敏、最小可见权限和保留期。“为了查事故”不意味着密钥和个人数据可以出现在一份广泛流转的 Markdown 中。
动手写一页复盘
用“审批要求被当作失败”这个问题,依次记录目标、实际轨迹、首次错误转换、影响和修复验证。参考回归是要求审批时暂停且不执行,批准后按约定继续,拒绝后保持未执行。只有修改一个错误提示字符串,不能解决状态转换问题。
















请登录后查看评论内容