

很多失败案例里,日志看上去特别忙,Agent 一直在 Retry,好像很努力,但结果一点都没变。这时候真正要看的不是“重试了几次”,而是“下一步有没有新信息、有没有换策略、有没有缩小范围”。
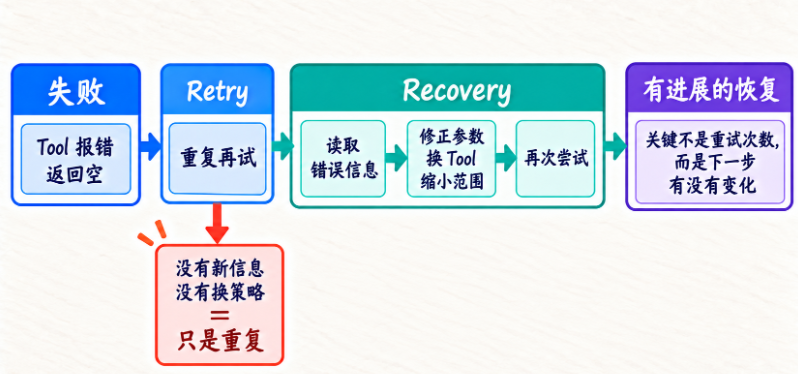
如图你可以直观看到,重复再试只是动作次数多;真正的 Recovery,应该带来新的判断依据或者新的执行路径。没有变化的 Retry,本质上只是循环。
Tool 失败本身其实很正常。
例如:
FileNotFoundError
Timeout
pytest failed
SQL syntax error
PermissionDenied
真正决定 Agent 成熟度的是,失败以后做什么。
Retry 不等于 Recovery
一个非常典型的假恢复:
read_file("config.py")
→ FileNotFoundError

read_file("config.py")
→ FileNotFoundError

read_file("config.py")
→ FileNotFoundError
它只是重复。
并没有利用 Observation。
真正有效的恢复应该:
read_file("config.py")
→ FileNotFoundError

list_files()
→ 发现 app/config.py

read_file("app/config.py")
→ success
这个过程里,错误真正改变了下一步策略。
Recovery Failure 的几个信号
Trace 中如果看到:
相同 Tool
相同 Arguments
相同 Error Signature
连续出现,就是高风险信号。
另一个信号是:
每次 Retry 都换一点无关参数,
但根本没有重新判断错误类型。
例如 SQL 报:
unknown column revenueAgent 却不断改:
LIMIT
ORDER BY
date range
问题显然不在这些参数。
无限循环为什么难发现?
因为每一步局部都可能“有理由”。
典型:
read
→ edit
→ test
→ fail
→ read
→ edit
→ test
→ fail
模型每一轮都在做事。
但是全局状态没有推进。
这就是,Local Reasonableness ≠ Global Progress。
Trace 如何定位循环?
可以比较:
Tool Sequence
Arguments
Error Signature
File Diff
Test Result
Working Memory
如果:
相同测试一直失败
代码修改没有实质变化
Tool 序列重复
就是 No Progress。
应该怎么修?
前面课程已经给过一整套工具:
RepetitionDetector
No Progress Detector
RunGuard
MAX_STEPS
MAX_TOOL_CALLS
System Reminder
Replan
不同情况用不同东西。
如果只是忘记目标:
Reminder如果原计划本身错:
Replan如果已经达到资源上限:
RunGuard如果同一个动作机械重复:
RepetitionDetector这就是 Failure Postmortem 的价值,不要只看到“死循环”,还要知道为什么没走出来。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容