

这一类也特别容易混。上下文丢失更像是“该给模型的东西没送到”,所以结果会偏;幻觉则是“没有证据却做了断言”,属于无依据生成。你会发现,前者常常和 compaction、截断、摘要丢失有关,后者才更像认知层面的事实错误。
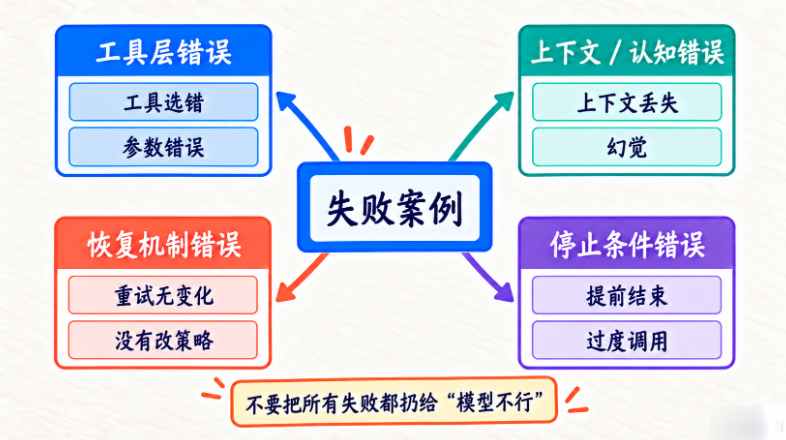
把这两者区分清楚以后,修复动作也会更具体:一个优先补上下文传递链路,另一个优先补证据约束、引用机制和验证逻辑。
第二类特别容易混淆的问题,是 Context Failure 和 Hallucination。
什么叫上下文丢失?
例如:
AGENTS.md:
不允许修改 tests/
明明存在。
但 Tracing 中最终送给模型的 Prompt 根本没有这条规则。
结果模型修改了:
tests/test_service.py这时不能简单说:
模型不遵守 AGENTS.md。因为它压根没看到。
这是,Context Failure。
常见原因包括:
ContextBuilder 漏掉 Project Rules
Session 恢复时少了一段 Working Memory
Compaction 把关键 Completion Criteria 压掉
SubAgent 没继承父任务约束
Skill 被错误卸载
Tool Result 没进入下一轮 Context
这类问题应该去修:
ContextBuilder
Session
Memory
Compaction
SubAgent Task Envelope
什么叫幻觉?
例如 Trace 中从来没有:
pytest -q
returncode = 0
但最终回答却说:
所有测试都已经通过。这就是,没有执行证据,却声称真实动作已经完成。
Agent 场景里的幻觉比普通聊天更危险。
普通聊天说错一个事实,可能只是内容错误。
Agent 如果声称:
文件已修改
测试已通过
SQL 已执行
部署已成功
用户会以为真实世界已经发生变化。
所以 Agent 最重要的底线之一就是,没有 Tool Result,不得声称执行成功。
如何从 Trace 反查?
最终回答如果说:
测试通过。我们应该能在 Trace 找到:
run_shell
Arguments:
pytest -q

Tool Result:
returncode = 0
找不到,就属于 Unsupported Completion Claim。
如何修复?
可以增加:
System Prompt:
不得伪造 Tool 执行结果

Working Memory:
verified_actions

Final Answer Verifier:
检查结论是否有 Trace Evidence

Completion Gate:
没有必要验证结果,不允许 COMPLETED
这比简单加一句:
“请谨慎,不要幻觉。”更工程化。
为什么 Compaction 特别容易制造 Context Failure?
长 Run 中我们会压缩旧消息。
如果 Compaction 只保留:
“Bug 已经修复。”却丢了:
“必须跑全量 pytest -q。”Agent 后面就可能提前结束。
所以 Compaction 必须优先保留:
Goal
Constraints
Completion Criteria
重要 Tool Evidence
未完成任务
这也是前面 Context Engineering 章节为什么非常重要。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容