



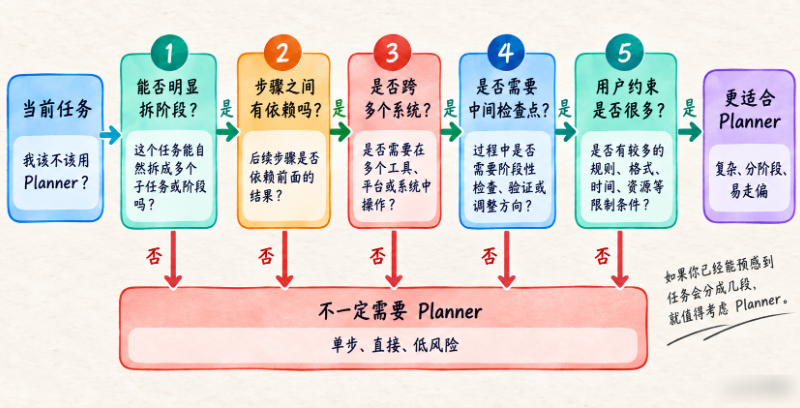
小节二:什么任务适合 Planner——复杂度、依赖、阶段性和风险才是真正判断标准
这一小节最容易陷入“凭感觉判断”。但真到工程里,最好还是有个顺手的判断框架。下面这张流程图,就是一个非常实用的快速判断标准:从能否拆阶段、是否有依赖、是否跨系统、是否需要中间检查点...
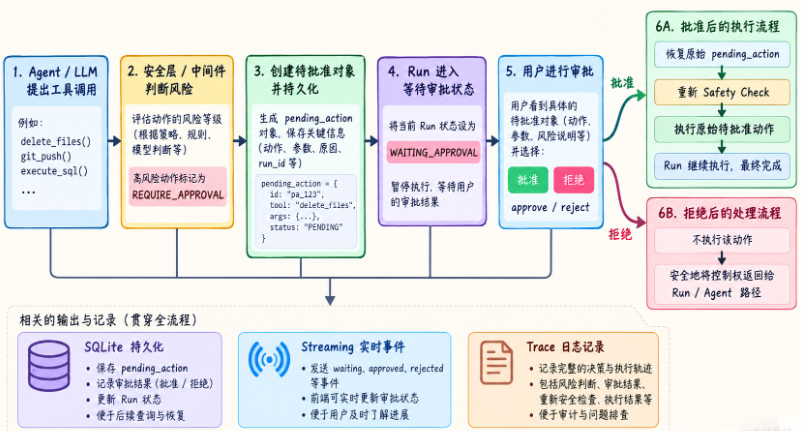
Human in the Loop:高风险动作必须人工确认
上一节,我们已经在 Agent 与 Tool 之间真正加了一道墙: Agent ↓ Tool Request ↓ Middleware ↓ Permission ↓ Safety Check ↓ Tool Middleware 可以把一次 Tool Request 判断为: ALLOW DE...

3.3 核心命令与日常使用
掌握 Claude Code 的日常使用,就像学会开车的基本操作 —— 方向盘、油门、刹车、倒车镜。 3.3.1 启动与基本交互 # 最基本的启动方式(在当前目录启动)$ claude# 指定项目目录启动$ claude ...
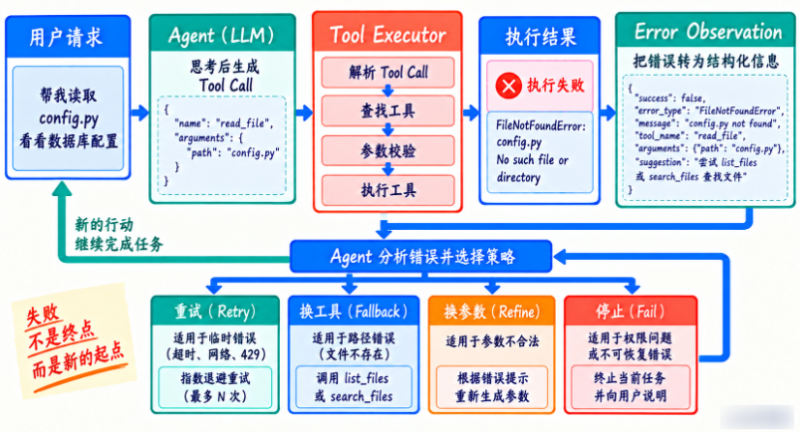
案例分析二:外部 API 连续超时,什么时候 Retry,什么时候 Fallback?
假设 Data Analysis Agent 需要调用: query_metric_api 正常请求内部指标服务。 第一次: TimeoutError 这类错误和 FileNotFoundError 不一样。 因为服务可能只是短暂抖动。 第一次处理 Harnes...
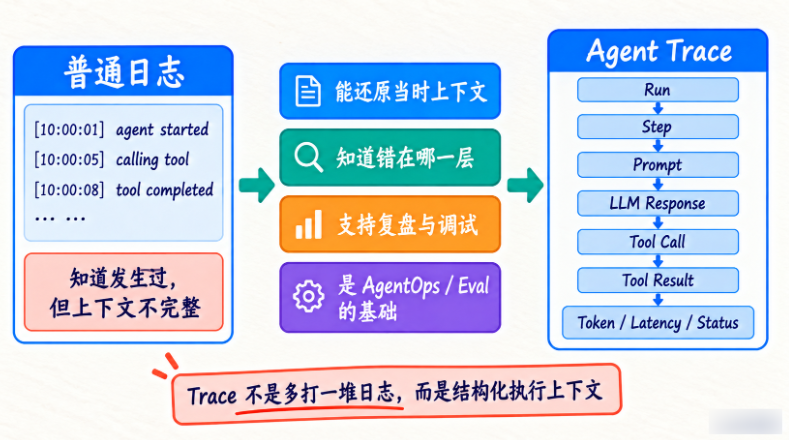
小节一:为什么普通日志不够——Agent Trace 需要“结构化执行上下文”
比如 calling tool 这行日志只能告诉我们调用发生过,却不一定能还原模型当时收到的 Prompt、工具参数和结果之间的关系。把普通日志与 Trace 放在一起看,差别会更直观。 右侧强调的是可以沿...
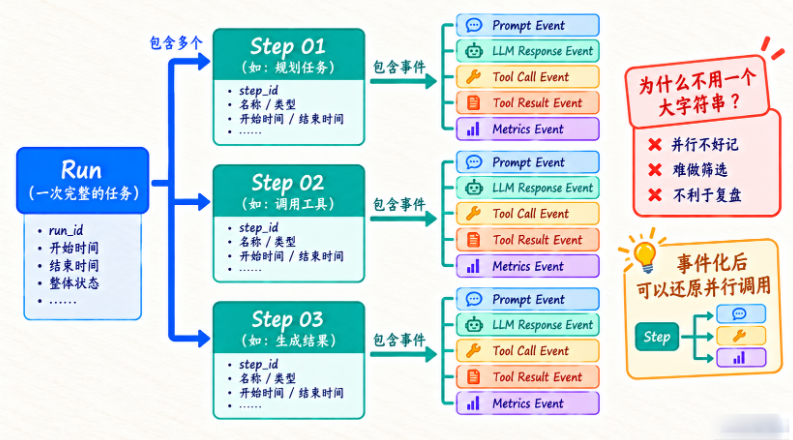
小节三:设计 Trace 数据结构——Run、Step、LLM Event、Tool Event 应该怎么组织
图里可以看到 Run、Step 与其内部 Event 的层级:一次任务下面会有多个步骤,一个步骤里又可能产生 Prompt、LLM Response、Tool Call、Tool Result 和 Metrics 等事件。 这样拆开以后,排查时可...
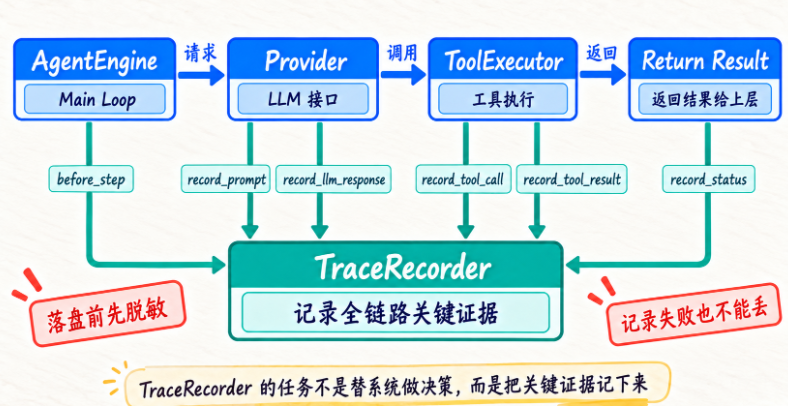
小节四:实现 TraceRecorder——真正把 AgentEngine、Provider、ToolExecutor 串起来
到代码实现时,最关键的问题是“在哪个组件记录什么”。把 Recorder 的接入点放进一次完整调用链,比单独记住几个 record_*() 方法更容易理解。 Engine 负责步骤与状态,Provider 负责模型请...
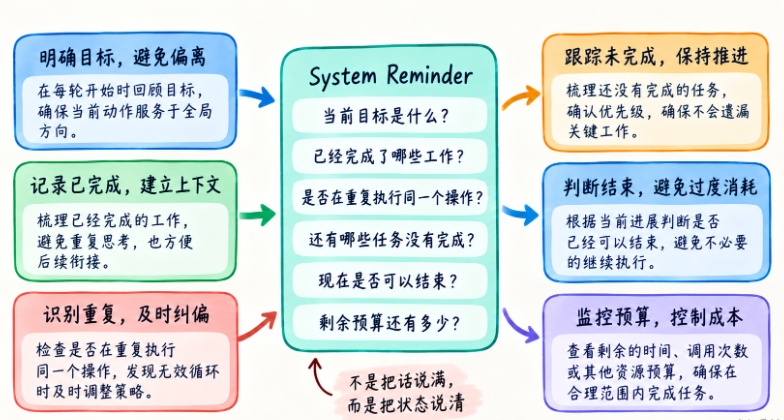
小节一:为什么 Agent 会“跑偏”——不是忘了 Prompt,而是长 Run 中局部信息不断覆盖全局目标
很多人会说,“System Prompt 里不是已经写了目标吗?为什么还要 Reminder?” 因为,有一次写进去,不等于几十轮以后仍然保持同样注意力。 尤其 Agent 每一轮都在新增: Tool Result 日志 错误...
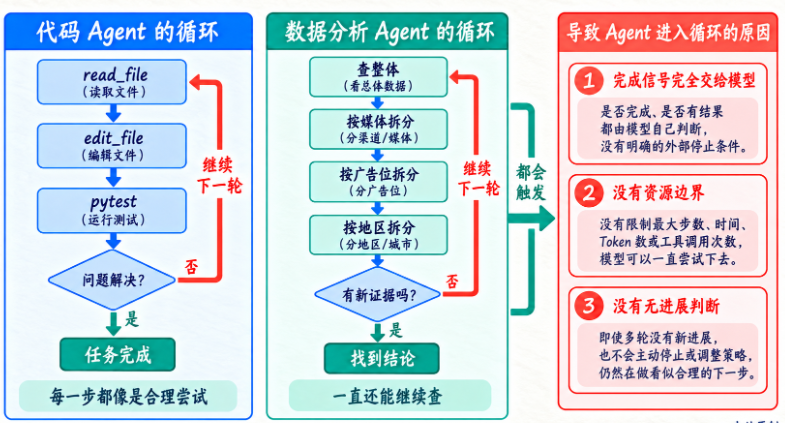
核心小节二:MAX_STEPS 为什么是第一道保险丝——最简单,但一定要有
这一节最想让大家记住的一句话就是:高级策略可以慢慢加,但第一道保险丝不能没有。 MAX_STEPS 不是最聪明的机制,却往往是最先该补上的安全边界。你可以先看看下面这张图,它把“为什么要有...
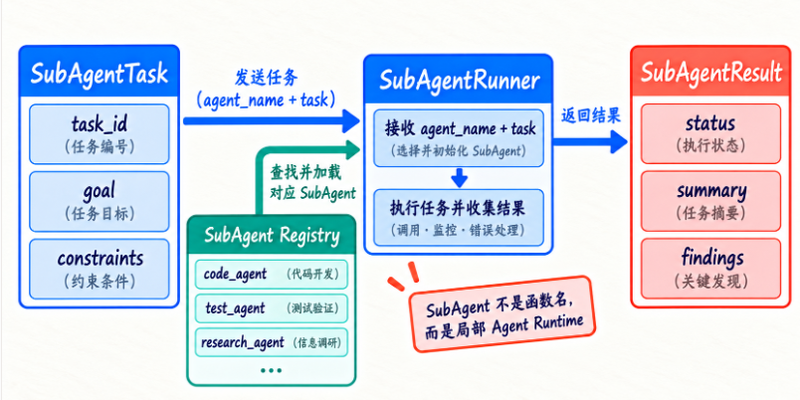
小节三:实现一个最小 SubAgentRunner——SubAgent 不是函数名,而是局部 Agent Runtime
到了实现层面,建议大家不要一上来就写得太复杂。先把最小结构搭出来,你对 SubAgent 这一套的理解会快很多。下面这张图就对应这一节代码里的几个核心对象。 它把 SubAgentTask、SubAgentR...

