

图里可以看到 Run、Step 与其内部 Event 的层级:一次任务下面会有多个步骤,一个步骤里又可能产生 Prompt、LLM Response、Tool Call、Tool Result 和 Metrics 等事件。
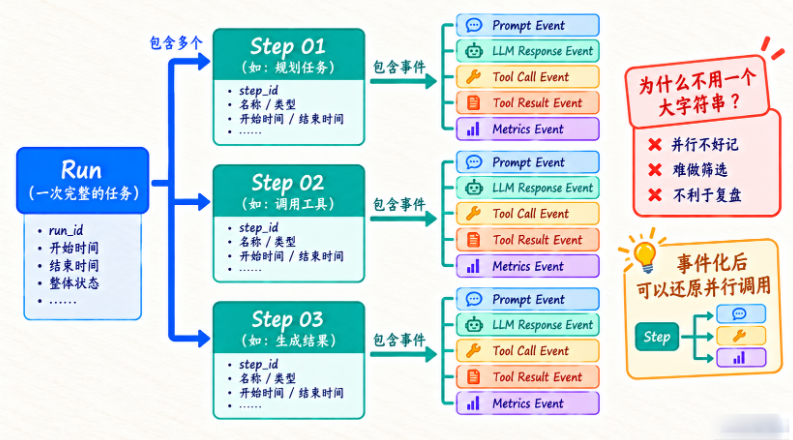
这样拆开以后,排查时可以先定位 Step,再查该 Step 里的具体事件;若存在并行调用或重试,还要结合正文介绍的 event_id、tool_call_id 等标识关联,不能仅靠图中的先后排列判断真实执行顺序。
一个实用第一版,可以定义:
TraceStep包含:
run_id
step_no
prompt
llm_response
tool_name
tool_arguments
tool_result
latency_ms
input_tokens
output_tokens
status
error
这对教学足够。
更成熟以后可以拆成:
steps
llm_calls
tool_calls
middleware_events
approval_events
第一版 TraceStep
from __future__ import annotations
from dataclasses import dataclass
from typing import Any, Optional


@dataclass
class TraceStep:
    run_id: str
    step_no: int
    prompt: list[dict[str, Any]]
    llm_response: Optional[dict[str, Any]]
    tool_name: Optional[str]
    tool_arguments: Optional[dict[str, Any]]
    tool_result: Any
    latency_ms: float
    input_tokens: int
    output_tokens: int
    status: str
    error: Optional[str] = None
    event_id: str = ""
    sequence: int = 0
    event_type: str = "combined"
    llm_call_id: Optional[str] = None
    tool_call_id: Optional[str] = None
    parent_event_id: Optional[str] = None
这个结构已经很完整。
为什么 Prompt 用 list[dict]?
因为现代 Chat API 往往输入:
messages而不是单一字符串。
例如:
[
  {"role": "system", "content": "..."},
  {"role": "user", "content": "..."}
]
这样记录更接近真实 Provider 输入。
为什么 llm_response 不直接字符串?
因为 Tool Calling 场景里返回的是:
结构化动作。为什么 Tool Result 用 Any?
因为可能:
文本
字典
列表
结构化表格摘要
不过落 SQLite 时要:
json.dumps更成熟的事件模型
以后可以:
Step
 ├─ llm.started
 ├─ llm.completed
 ├─ middleware.checked
 ├─ tool.started
 ├─ tool.completed
 └─ step.completed
这种事件流很适合:
Streaming
Trace
Metrics
共享。
用事件关系还原一次并行调用
可以把一次真实 Step 想成下面这条链:
run event
└── llm.started        llm_call_id=llm_7
    └── llm.completed  llm_call_id=llm_7
        ├── policy     tool_call_id=call_a
        ├── tool       tool_call_id=call_a
        ├── policy     tool_call_id=call_b
        └── tool       tool_call_id=call_b
其中 event_id 标识每条记录,parent_event_id 表示直接来源,llm_call_id 与 tool_call_id 表示跨阶段的逻辑调用。三者解决的问题不同,不建议只保留一个万能 ID。
重试也不要覆盖旧事件。第二次尝试使用新的调用 ID,并在 metadata 记录 attempt=2、重试原因和上一尝试 ID。最终指标可以按逻辑操作聚合,但审计数据必须保留每次实际尝试。否则一次“重试后成功”会被写成普通成功,真正的抖动和额外成本就消失了。
Trace Step 与 Span 怎么对应
教学项目仍用 TraceStep 这个名字承载事件,便于和 Main Loop 对照。接入分布式追踪系统时,可以把 Run 看作根 Span,LLM 和 Tool 调用看作子 Span,Policy、Approval、状态变化看作 Span Event。这里是课程采用的映射,不需要把某个字段命名当作唯一行业标准;真正重要的是上下游 ID 能贯通,开始与终态能配对。
















请登录后查看评论内容