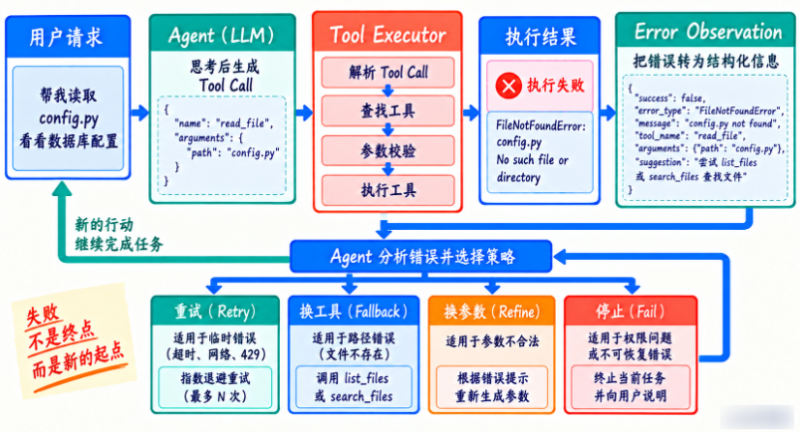


假设 Data Analysis Agent 需要调用:
query_metric_api正常请求内部指标服务。
第一次:
TimeoutError这类错误和 FileNotFoundError 不一样。
因为服务可能只是短暂抖动。
第一次处理
Harness 判断:
retryable = true自动 Retry。
第二次:
TimeoutError再 Retry。
第三次:
TimeoutError达到:
max_retries=2Harness 不再继续自动重试。
形成 Error Observation:
{
  "ok": false,
  "tool": "query_metric_api",
  "error_type": "TimeoutError",
  "attempts": 3,
  "error": "指标服务连续超时"
}
Agent 下一轮怎么办?
模型可以判断:
主指标服务不可用如果系统还有:
query_metric_cache可以 Fallback。
于是:
Action:
query_metric_cache(...)
如果缓存也失败?
再返回 Observation。
如果已经没有合理数据源,Agent 应该:
FAILED / PARTIAL并明确告诉用户:
当前无法获得实时指标,
主服务连续 3 次超时,
缓存数据也不可用。
而不是继续无限重试。
这个案例为什么重要?
它清楚区分了:
Retry:
同一动作短暂失败

Fallback:
换数据源继续完成目标
而且说明,Retry 由 Harness 自动做更合适,Fallback 往往需要 Agent 结合任务语义决定。
把外部 API 场景画出来以后,这个分工会更清楚:前几次 Timeout 可以在预算内自动 Retry;一旦达到上限,就应该形成 Error Observation 交回 Agent,再由它判断缓存、备用数据源是否仍满足原任务。
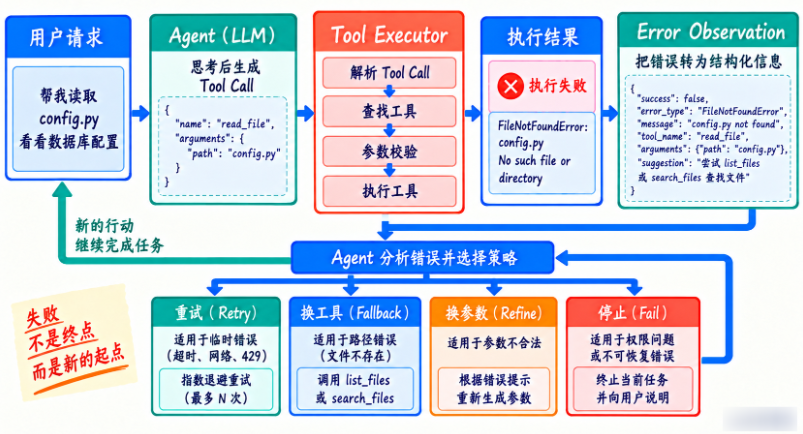
如果 Fallback 改变了数据时效性或精度,最终回答里也要把这个变化说清楚。缓存能让任务继续,并不意味着它和实时服务语义完全相同;没有可靠替代方案时,明确返回 PARTIAL / FAILED 反而更加专业。
迁移
这个模式适用于:
网页抓取
外部搜索 API
数据库连接
模型 Provider
对象存储
第三方服务
后面 LLM Provider Fallback 也会用到类似思想。
常见误区
误解: Tool Error 就代表 Agent 失败,应该立刻把 Run 标成 FAILED。
正解: Tool Error 只是某一步动作失败。FileNotFoundError、SQL 空结果、测试失败、网络超时都可能成为下一轮非常有价值的 Observation。只有确认错误不可恢复、触发安全边界、超过预算或没有合理后续动作时,才应该把整个 Run 标记为 FAILED。否则会丢掉 Agent 最重要的恢复能力。
误解: Retry 就是失败以后重复同一个 Tool Call,次数多一点总能成功。
正解: Retry 只适合那些“下一次有可能自然恢复”的错误,例如 Timeout、短暂网络异常、服务限流。对于 FileNotFoundError、参数错误、PermissionError,重复原动作通常没有意义。真正的错误恢复第一步应该是错误分类,再决定 Retry、Fallback、重新规划还是终止,而不是盲目重复。
误解: 为了让 Agent 更自主,Tool 内部应该自动完成所有 Fallback。
正解: Tool 应尽量保持职责清晰。read_file 只负责读取给定路径;找不到时返回明确 Error Observation。至于下一步是 list_files、search_files 还是放弃,属于 Agent 任务层决策。如果 Tool 自己偷偷做复杂恢复,行为会变得难追踪、难审计,也会削弱 Main Loop 的决策意义。
误解: 只要有 max_retries,就不会出现死循环。
正解: max_retries 只能限制某一个 Tool Call 内部的自动重试。Agent 仍然可能在多个 Tool 之间循环,例如 read_file → list_files → read_file → list_files。因此还需要 Agent 级的 MAX_STEPS、重复 Tool Call 检测、错误预算和后续 System Reminder。恢复机制必须分层治理。
误解: Error Observation 越详细越好,直接把完整 traceback 全塞给模型最有帮助。
正解: Traceback 对开发者调试很有价值,但给模型的 Observation 更适合结构化、精简并保留关键语义,例如 error_type、message、retryable、suggestion。完整 traceback 可以写入 Tracing。否则几十上百行异常栈会消耗 Context,并可能掩盖真正关键的信息。给模型的是决策信息,给 Trace 的是完整证据。
误解: Agent 能纠错以后,就应该尽最大可能继续执行,不要轻易失败。
正解: 自主纠错不是无限尝试。真正成熟的系统应该有明确失败边界:最大重试次数、最大 Tool Error 数、最大 Step、超时、安全策略、用户取消等。能恢复时继续,不能恢复时清楚结束,比“永远尝试”更可控。Agent Harness 的价值之一,就是让模型的自主性始终受资源和安全边界约束。
















请登录后查看评论内容