

比如 calling tool 这行日志只能告诉我们调用发生过,却不一定能还原模型当时收到的 Prompt、工具参数和结果之间的关系。把普通日志与 Trace 放在一起看,差别会更直观。
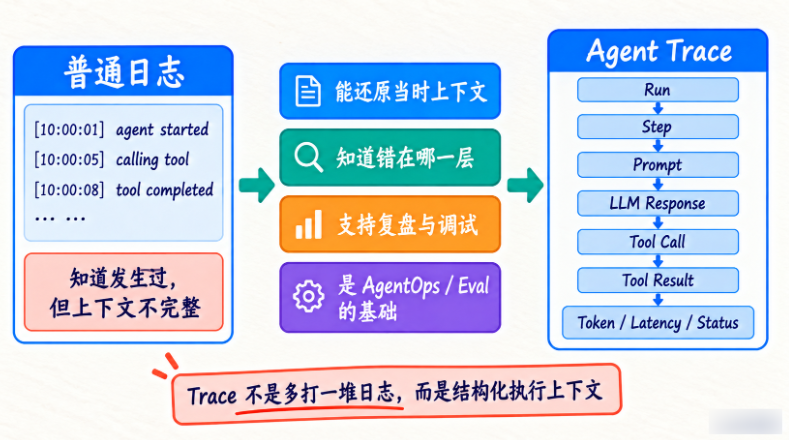
右侧强调的是可以沿着一次 Run 追溯上下文的结构化记录,而不是单纯把日志写得更长。后面谈字段和关联 ID,都是为了让这种复盘真正可行。
很多项目一开始会写:
print("agent started")
print("calling tool")
print("tool completed")
或者:
logger.info(...)这当然有用。
但它更像:
应用日志。而不是:
Agent Trace。普通日志擅长什么?
例如:
服务启动
数据库连接失败
HTTP 500
进程异常
某接口耗时
这些都很适合普通日志。
Trace 擅长什么?
Trace 更关注,一次 Agent Run 内部发生了什么。
比如:
当前 Step 是多少
Prompt 组装后是什么
LLM 返回了什么可见响应
模型选择哪个 Tool
参数是什么
Middleware 是否拦截
Tool Result 是什么
下一步为什么发生
Trace 是按 Run 组织的
普通日志通常按:
时间
进程
服务
组织。
Trace 更自然:
run_id
step_id
例如:
run_abc
 ├─ step_001
 ├─ step_002
 ├─ step_003
这样你打开一个 Run,就能从头看到尾。
为什么 Step 是核心?
因为 Agent 是循环。
一个 Run 不是一次函数调用。
而是:
Reason
Action
Observation
Reason
Action
Observation
...
所以最自然的 Trace 粒度就是:
Step每个 Step 对应一次:
模型决策
或 Tool 执行
或系统状态变化
Step 和 RunStep 有什么区别?
前面我们已经有:
RunStep它是轻量过程索引。
例如:
Step 3:
running tests
Tracing 会更细。
例如同一个 Step 可能记录:
Prompt
LLM Response
Tool Request
Middleware Decision
Tool Result
Latency
Token
Status
可以这样理解:
Run
→ 生命周期

RunStep
→ 过程索引

Trace
→ 详细证据
为什么 Trace 要结构化?
不要把一切都写成:
一大段 JSON 字符串最好让重要字段能直接查询。
例如:
run_id
step_no
event_type
tool_name
status
latency_ms
input_tokens
output_tokens
这样后面才能统计:
平均 Step
Tool Error Rate
LLM Latency
Token Cost
这正是后面 AgentOps 的基础。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容