



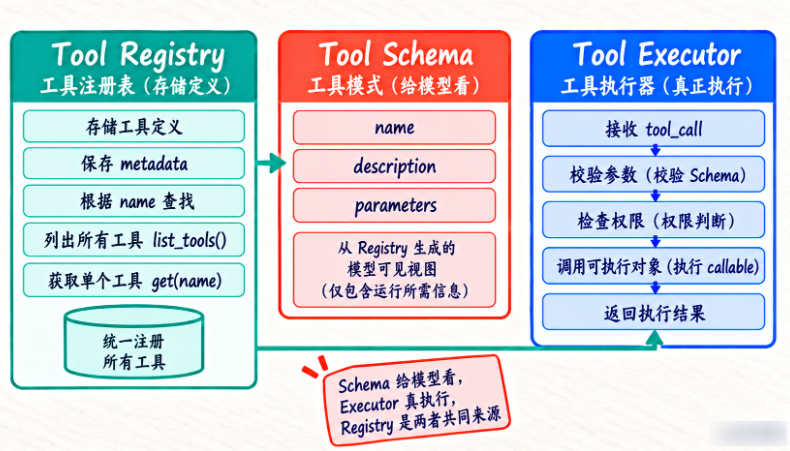
案例分析一:Coding Agent 从 2 个工具扩展到 12 个工具,为什么没有 Registry 很快会失控?
到了案例部分,前面讲过的“维护成本”和“统一入口”就会一下子变得特别具体。工具少的时候,硬写几个 if / elif 似乎还能忍;工具一旦从 2 个涨到 12 个,复杂度会很快失控。 左边那种写法...
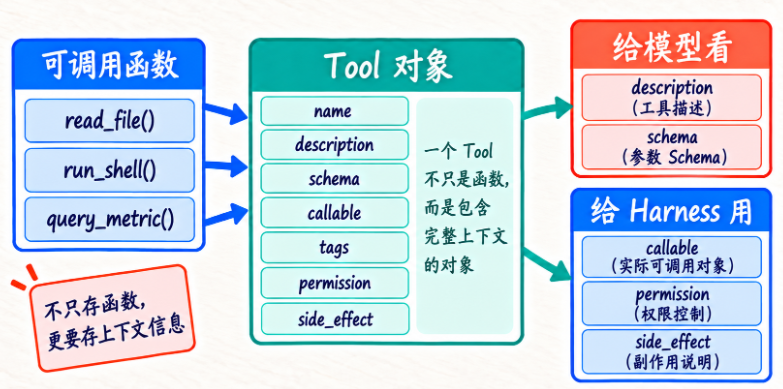
小节四:把 Registry 接入 Agent Harness——让模型看到的 Tool 和 Harness 能执行的 Tool 来自同一个地方
这一节的核心思想就一句话:模型能看到什么工具,Harness 就应该从同一个来源里去执行什么工具。只要来源分裂,后面就很容易出现“模型看得到但系统调不到”,或者“系统能执行但模型根本不知道...
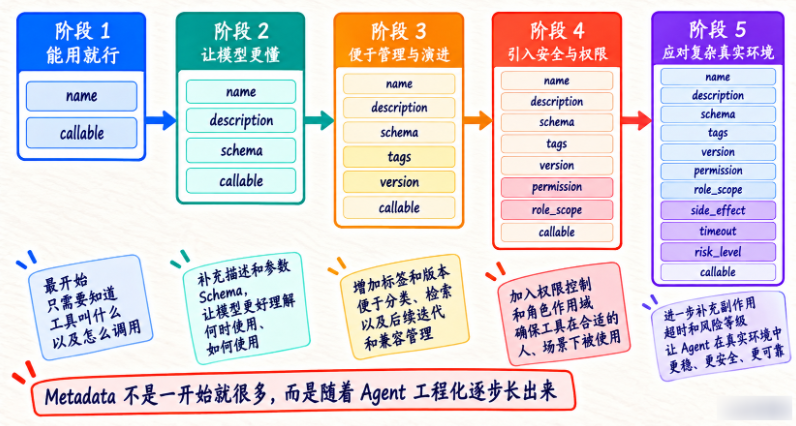
小节三:实现 @tool 自动注册——让“定义工具”和“注册工具”变成一件事
如果每次定义 Tool 都要: def read_file(...): ... registry.register( Tool( name='read_file', description='...', func=read_file, ) ) 当然没问题。 但工具多了以后,会出现一个很常见的问...
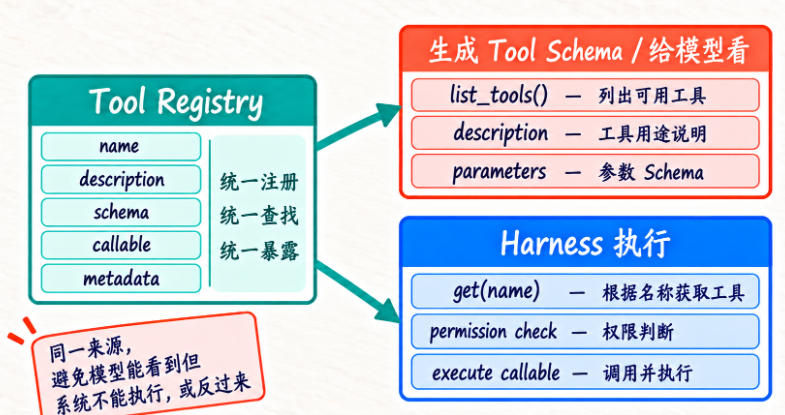
核心小节二:Tool 不只是函数——为什么 Registry 最好保存 Tool 对象和 Metadata
上一小节我们保存的是: name → function 够不够? 短期够。 但很快你会想知道: 这个 Tool 是干什么的? 有没有副作用? 属于哪一类? 是否需要审批? 超时多少? 后面 Schema 怎么生成? 如...
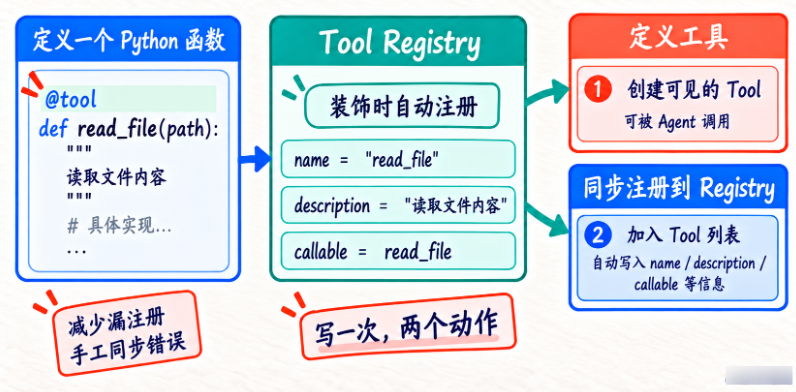
核心小节一:为什么一定要有 Registry——从“函数集合”升级成“Agent 能力目录”
先从最简单的写法开始。 假设现在有三个工具: def read_file(path: str) -> str: return f'读取文件:{path}' def write_file(path: str, content: str) -> str: return f'写入文件:{path}' d...
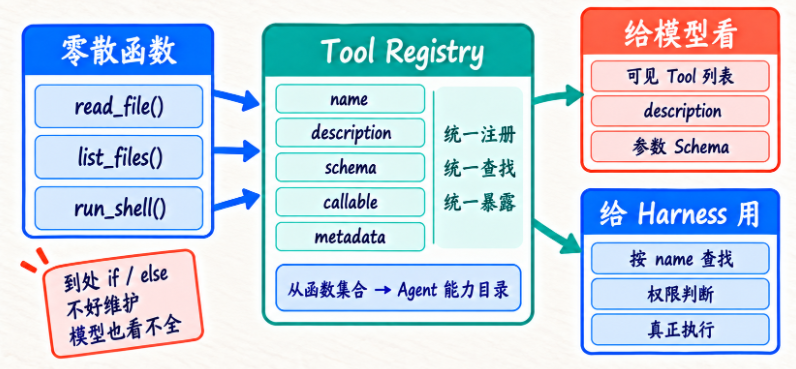
自己实现 Tool Registry
上一节我们已经把 Tool Calling 的边界讲清楚了。 模型输出: { 'name': 'read_file', 'arguments': { 'path': 'app.py' } } 并不意味着文件已经被读取。 真正的链路是: 模型产生 Tool Call ↓...

章末自测
题目 1:为什么说“大模型没有真的执行函数”? 假设模型返回 read_file(path='app.py'),请从模型输出、Harness、Python 运行时、真实环境四个层次解释整个过程,并说明如果 Harness 拒绝...
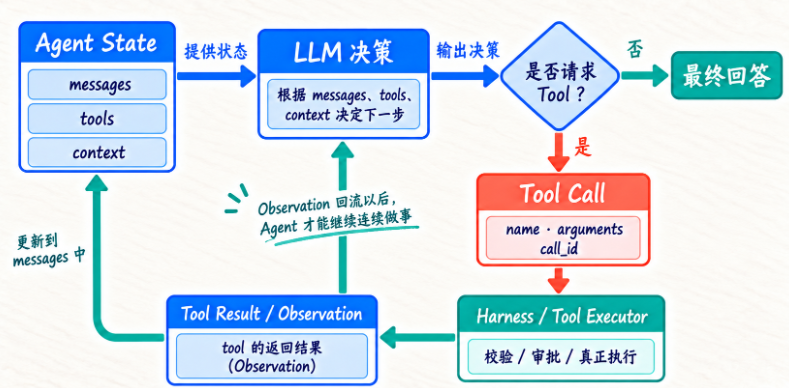
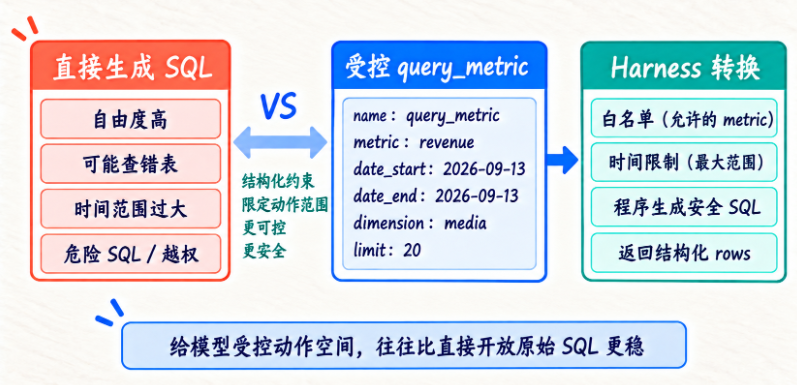
案例分析二:Data Analysis Agent 生成查询动作,为什么 Tool Calling 比直接生成 SQL 更好控制?
这个案例最适合用对比图来看。因为一旦把“直接给 SQL”与“先产生受控查询动作”并排摆出来,安全边界和工程治理的差别会一下子清楚很多。 换句话说,Tool Calling 的价值并不只是让模型输出得...
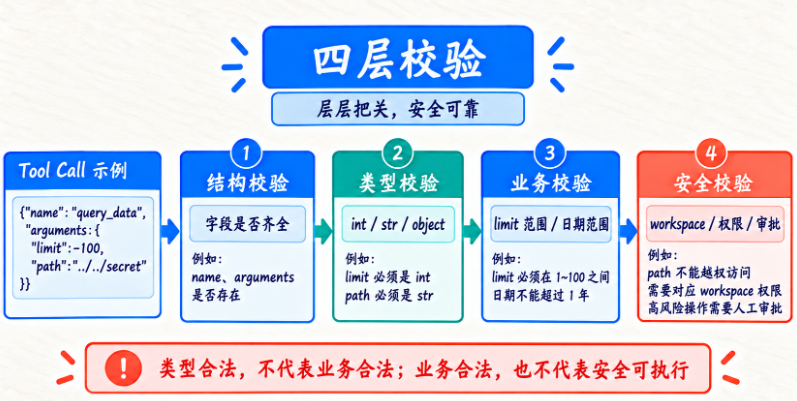
小节四:Tool Calling 真正容易踩坑的地方——不是“会不会调用”,而是“能不能可靠执行”
很多 Demo 做到: 模型会输出 Tool Call 就结束了。 但真实工程最难的是,Tool Call 能不能被可靠执行。 至少有六类问题。 先把常见问题集中看一眼,会更容易建立排查顺序。很多时候不是 Tool C...
小节三:把 Tool Calling 接回 Main Loop——Agent 为什么终于可以连续“做事”了?
现在把前几节串起来。 我们已经有: Main Loop State Provider Tool Executor 接下来真正的 Agent Loop 应该长这样: while True: response = provider.chat( state.messages, tools=tool_schem...

