

到了案例部分,前面讲过的“维护成本”和“统一入口”就会一下子变得特别具体。工具少的时候,硬写几个 if / elif 似乎还能忍;工具一旦从 2 个涨到 12 个,复杂度会很快失控。
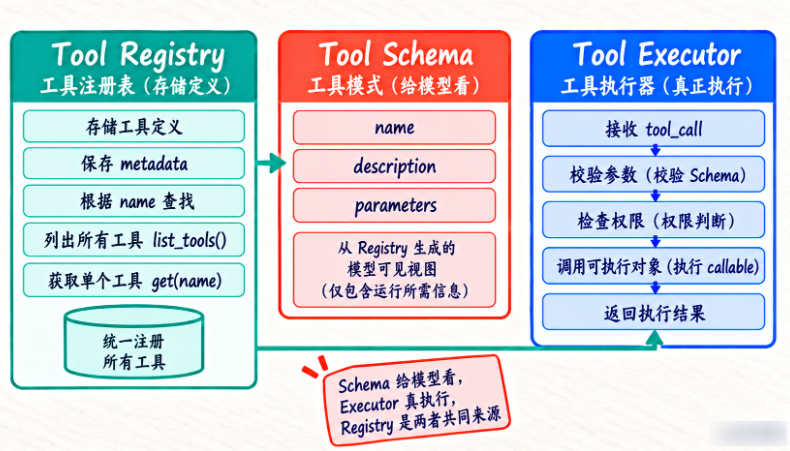
左边那种写法的问题非常典型:判断分散、模型看不全、扩展时容易漏。右边收进 Registry 以后,模型侧通过 list_tools() 看全量能力,Harness 侧通过统一入口查找和执行,整个系统一下就顺了很多。
场景背景
一个 Coding Agent 第一版只有:
read_file
run_test
Executor:
if name == "read_file":
    ...
elif name == "run_test":
    ...
非常清楚。
后来产品提出需求,“让 Agent 能真正修改项目。”
新增:
write_file
edit_file
list_files
search_files
run_python
run_shell
git_diff
之后还需要:
read_project_rules
check_dependency
工具达到十几个。
问题矛盾
如果继续用 if/elif:
执行逻辑越来越长
工具描述散落
Prompt 列表要手改
权限配置要手改
Tracing 分类又手改
某次开发者加了:
def search_files(...):
    ...
但忘了在 Executor 加分支。
模型已经能看到 search_files 的描述,却执行时报:
Unknown Tool另一次则相反:
Executor 已经支持:
git_diff但 Prompt 忘了告诉模型。
于是模型永远不会调用。
改造过程
第一步,所有 Tool 统一:
@tool()
def read_file(...):
    ...

@tool()
def search_files(...):
    ...
第二步,Registry 自动收集:
read_file
write_file
edit_file
list_files
search_files
run_python
run_shell
run_test
git_diff
第三步,Provider 的 Tool Schema 从 Registry 生成。
第四步,Executor 也只:
registry.execute(call)结果
新增工具时,只需要:
@tool()
def inspect_dependency(...):
    ...
后续 Schema、执行、Tracing 都能围绕 Registry 接入。
复盘与迁移
这个案例说明 Tool Registry 真正解决的是,能力定义只有一个事实来源。
这和大型后端系统里的 Route Registry、Plugin Registry、Command Registry 很像。
它不是“为了少写代码”,而是为了让系统边界稳定。
案例分析二:Data Analysis Agent 如何根据不同角色动态暴露不同 Tool?
第二个案例更能体现 Registry 的“工程味”。它不是单纯把工具堆在一起,而是能根据不同角色动态裁剪可见能力。
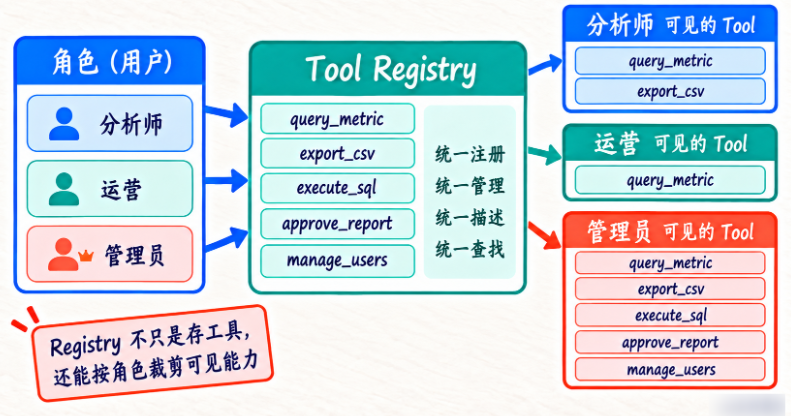
这样设计的好处很直接:分析师只看到分析师该用的能力,运营看到更偏业务操作的能力,管理员再拥有更高权限的工具集合。对模型来说,可见范围更清晰;对系统来说,安全边界也更明确。
场景背景
假设 Data Analysis Agent 有:
get_schema
query_metric
query_by_dimension
execute_sql
export_csv
普通业务用户只能:
get_schema
query_metric
query_by_dimension
高级分析师可以:
execute_sql
export_csv
如果工具列表写死在 Prompt 里,就很难按角色动态控制。
输入与约束
Registry 保存所有工具。
但不同 Session 可以生成不同可见集合。
例如:
role = business_user只允许:
low_risk工具。
实现思路
Registry 可以进一步支持:
list_tools(
    predicate=...
)
或者让 Tool 有:
roles
risk_level
例如:
query_metric
roles = ["business", "analyst"]

execute_sql
roles = ["analyst"]
用户登录以后:
当前角色
 ↓
过滤 Registry
 ↓
只生成允许的 Tool Schemas
 ↓
模型根本看不到其他工具
执行时再做一次权限校验。
为什么还要执行时再校验?
因为,模型不可见不等于安全。
Harness 仍然应该以 Registry / Middleware 的真实权限为准。
结果
业务用户问,“帮我直接执行任意 SQL。”
即使模型想做,也没有 execute_sql Tool Schema。
而且就算伪造 Tool Call,执行时仍会被权限层拒绝。
复盘与迁移
Registry 不仅是工具目录。
它还会成为:
动态能力暴露
权限
租户隔离
环境隔离
的基础。
比如生产环境可以注册:
read-only tools开发环境再额外开放:
write_file
run_shell
同一个 Agent Engine,不需要重写。
常见误区
误解: Tool Registry 本质上就是一个 Python 字典,没有必要专门设计。
正解: 最初确实可以从字典开始,但 Registry 很快会承载 Tool Name、Callable、Description、Schema、风险等级、权限、审批、超时、标签等信息。更重要的是,它会同时服务“模型能看到哪些工具”和“Harness 能执行哪些工具”。如果没有统一 Registry,这两套能力列表很容易失去同步,产生隐蔽 Bug。
误解: 只要 Python 中存在同名函数,就可以让模型直接调用。
正解: Agent Tool 应该采用白名单思路,只有显式注册到 Registry 的能力才允许执行。直接通过 globals() 或反射寻找任意函数,会让模型有机会触达原本不该暴露的内部能力。Registry 本质上也是一个 Capability Boundary,定义了 Agent 当前究竟拥有哪一组可执行权限。
误解: Registry 只负责 get(),真正执行仍然写一堆 if/elif 更直观。
正解: 如果执行器仍然按 Tool Name 写分支,那么新增 Tool 时依然需要改中心代码,Registry 的价值只发挥了一半。更合理的是由 Registry 返回 Tool 对象或直接统一 execute()。这样新增 Tool 不需要修改 Main Loop 或中心 Executor,真正符合开放扩展、核心稳定的设计目标。
误解: @tool 装饰器越自动越好,最好扫描项目里所有函数自动注册。
正解: 过度自动发现会降低可见性和安全性。一个函数为什么成为 Agent Tool,应该是明确的工程决策。@tool 很适合,因为代码上能直接看到注册意图;而“扫描所有 callable 自动暴露”可能把内部函数、调试函数甚至敏感操作暴露给模型。自动化不应该牺牲边界透明度。
误解: 模型能看到的 Tool 列表和 Executor 真正支持的 Tool 列表可以分开维护。
正解: 分开维护非常容易不一致。模型可能调用不存在的 Tool,或者系统已经实现某 Tool 但模型永远不知道。更稳的设计是 Registry 成为单一事实来源:Tool Schema 从 Registry 生成,执行也从 Registry 查找。这样工具的定义、发现和执行围绕同一套元数据展开。
误解: 工具重名时直接覆盖最方便,反正后注册的版本更新。
正解: 静默覆盖会让 Agent 行为悄悄变化,尤其在大型项目、插件加载、测试环境中非常危险。更安全的默认策略是发现重名立即报错。如果确实需要替换,应使用显式 replace=True 或版本机制,让“替换 Tool”成为可见操作,而不是隐藏副作用。
















请登录后查看评论内容