

上一节我们已经把 Tool Calling 的边界讲清楚了。
模型输出:
{
  "name": "read_file",
  "arguments": {
    "path": "app.py"
  }
}
并不意味着文件已经被读取。
真正的链路是:
模型产生 Tool Call
  ↓
Harness 解析
  ↓
找到真正的 Python 函数
  ↓
参数校验
  ↓
执行
  ↓
Tool Result
  ↓
Observation这一节,我们就专门解决其中一个非常关键的问题,Harness 到底去哪里“找到真正的 Python 函数”?
如果工具只有两个,当然可以直接写:
if name == "read_file":
    return read_file(**arguments)

if name == "list_files":
    return list_files(**arguments)
但很快我们的 Agent 会拥有:
read_file
write_file
edit_file
list_files
search_files
run_python
run_shell
run_test
query_sql
get_schema
...
如果继续往 if/elif 里堆,整个 Harness 会越来越难维护。
所以这一节我们要真正搭一个自己的工具注册中心:
registry.register(read_file)
registry.register(write_file)
registry.register(run_python)
registry.register(run_shell)
最终支持:
registry.get("read_file")
registry.list_tools()
registry.execute(...)
再进一步,让工具能够:
@tool
def read_file(path: str):
    ...
定义完成以后自动注册。
这节课的重点不是“写一个字典”,而是建立一个后面会一直使用的工程抽象,Agent 所有可执行能力,都应该先进入 Registry。
读这一节时,可以把 Registry 想成一份受控目录。register() 决定哪些能力有资格进入目录,get() 根据名字找到工具,schemas() 决定怎样把能力描述给模型,execute() 才真正触发调用。四个动作连在一起,但风险完全不同:列出工具不会修改环境,执行写文件或 Shell 却可能产生真实副作用。
开场引入
刚开始看这一章时,很多同学容易把 Registry 理解成“多写了一层封装”。其实它更像一个统一的工具目录:一边给模型暴露清晰的能力边界,一边给 Harness 提供稳定的查找入口。先看下面这张图,整体骨架会更容易建立起来。
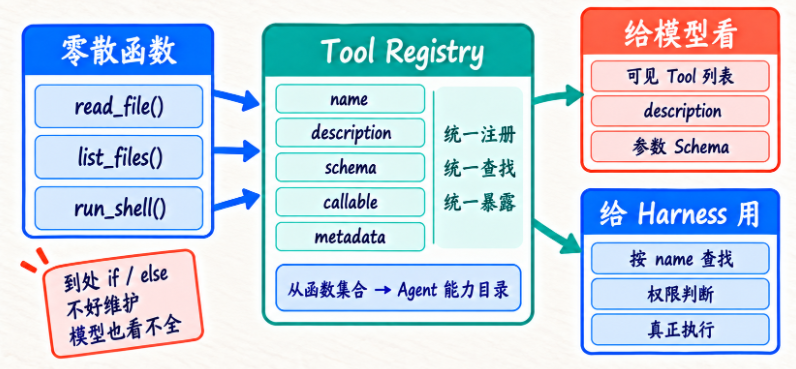
这张图可以先抓住一个主线:左边是零散函数,中间是统一注册,右边分别服务于“模型可见能力”和“Harness 实际执行”。也就是说,Registry 不是为了“好看”,而是为了把工具系统真正组织起来。
我们先看一个非常典型的 Agent Demo。
最开始只有两个 Tool:
def execute_tool(name, arguments):
    if name == "read_file":
        return read_file(**arguments)

    if name == "list_files":
        return list_files(**arguments)

    raise ValueError("unknown tool")
很正常,也没什么问题。
过两天,我们加:
write_file于是:
elif name == "write_file":
    ...
再加:
run_python继续。
后来 Coding Agent 逐渐完整:
read_file
write_file
edit_file
list_files
search_files
run_python
run_shell
run_test
git_diff
Data Analysis Agent 又需要:
get_schema
query_metric
query_by_dimension
execute_sql
generate_chart
然后你会看到一个越来越夸张的函数:
def execute_tool(name, arguments):

    if name == "read_file":
        ...

    elif name == "write_file":
        ...

    elif name == "run_python":
        ...

    elif name == "run_shell":
        ...

    elif name == "query_metric":
        ...

    elif name == "generate_chart":
        ...

    elif name == "send_report":
        ...
这时真正的问题还不是“代码长”。
更麻烦的是,工具相关信息开始散落。
例如:
- 工具函数定义在一个文件;
- 工具名写在执行器里;
- 工具描述写在 Prompt 里;
- Tool Schema 又写在另一个 JSON 文件;
- 权限规则写在 Middleware;
- Tracing 里还要自己判断工具类型。
加一个 Tool,需要改 4~5 个地方。
删一个 Tool,也可能漏删。
于是出现非常常见的问题,模型以为有 search_files,但 Executor 里根本没注册。
或者反过来,Python 里明明实现了 run_python,但 Provider 发给模型的 Tool 列表里没有它。
这就是工具管理失去“单一来源”的后果。
我们真正希望的是:
Tool Registry
     ↓
保存所有 Tool
     ↓
Agent 从这里知道有哪些 Tool
     ↓
Executor 从这里找到真正函数
     ↓
后续 Schema、权限、Tracing 都围绕它扩展
所以 Tool Registry 的价值,绝对不只是,“省几个 if/elif。”
它更重要的作用是,成为 Agent 工具能力的统一事实来源。
也就是说,如果一个工具没进 Registry,我们就认为,Agent 没有这个能力。
如果一个工具进入 Registry,我们就可以围绕它继续附加:
name
description
callable
schema
risk_level
timeout
category
requires_approval
后面 Tool Schema、Middleware、Human Approval、Tracing,全部可以挂在这里。
因此,这一节其实是在为后面一整套工具系统打地基。
知识地图
这一节的位置可以理解成:
上一节:
模型已经会产生 Tool Call
  ↓
本节:
Harness 有一个统一 Tool Registry
  ↓
下一节:
Registry 中每个 Tool 再生成 Tool Schema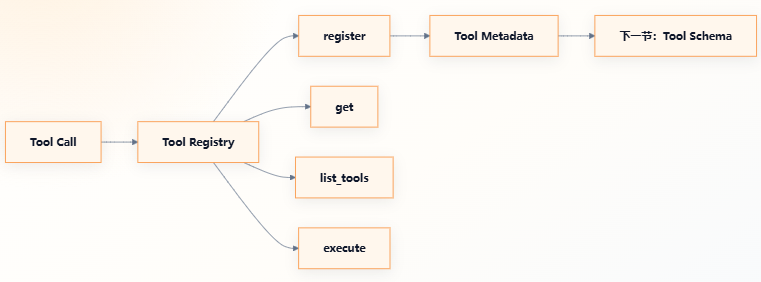
















请登录后查看评论内容