

先从最简单的写法开始。
假设现在有三个工具:
def read_file(path: str) -> str:
    return f"读取文件:{path}"


def write_file(path: str, content: str) -> str:
    return f"写入文件:{path}"


def run_python(code: str) -> str:
    return f"执行 Python:{code}"
我们可以放进字典:
TOOLS = {
    "read_file": read_file,
    "write_file": write_file,
    "run_python": run_python,
}
其实这已经是最原始的 Registry。
为什么?
因为它建立了:
字符串 Tool Name
   ↓
真正 Python Callable
的映射。
模型输出:
{
  "name": "read_file",
  "arguments": {
    "path": "app.py"
  }
}
Harness 可以:
func = TOOLS["read_file"]
result = func(path="app.py")
这一步非常关键。
因为模型世界里的 Tool 是:
name + argumentsPython 世界里的 Tool 是:
function objectRegistry 就是两者之间的桥。
为什么不直接用 globals()?
这一段最关键的,不是语法能不能写出来,而是工程上稳不稳。直接用 globals() 或反射去扫函数,写 Demo 很快,但工具一多以后,暴露范围、安全边界、名字冲突都会一起冒出来。
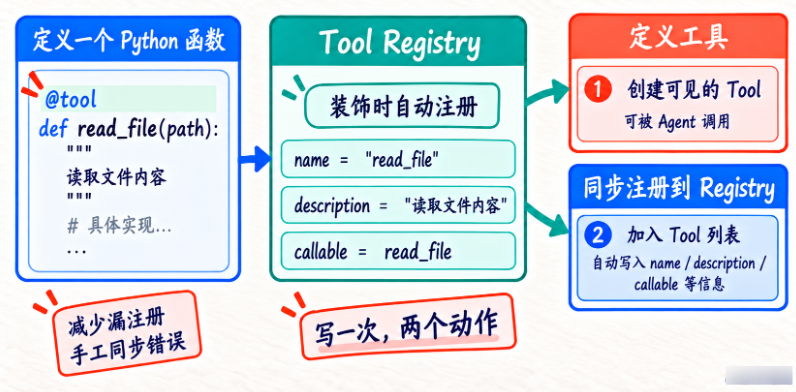
你可以把它理解成一次“从开放搜索到白名单注册”的收口。这样模型看到的能力、系统允许执行的能力,都会更可控,后面扩展时也不容易漏。
有同学可能会想到:
func = globals()[name]这样也能按字符串拿函数。
但这在 Agent 场景里非常危险。
因为 globals() 里可能有:
- 你根本不想暴露的函数;
- 内部辅助函数;
- 配置对象;
- 调试函数;
- 其他可调用对象。
如果模型只要猜到名字就能执行:
风险会非常大。
Registry 的价值就在于,只注册允许 Agent 看见和执行的能力。
这是一种 Capability Boundary。
例如:
Python 程序里有 100 个函数
  ↓
只注册 8 个 Tool
  ↓
Agent 只能使用这 8 个
这就是可控性。
Registry 是白名单,而不是函数搜索器
这个理解特别重要。
我们不会写:
模型想调用什么
 ↓
去 Python 里找有没有同名函数
而是:
只有提前注册的函数
 ↓
才属于 Agent Tool
所以:
registry.get("read_file")本质上是在问,“Agent 当前是否拥有这个能力?”
而不仅仅是,“这个函数存不存在?”
这里的“白名单”只说明工具必须显式进入能力目录,并不等于任何用户、任何 Run 都自动获得执行权限。真正调用时仍要结合身份、工作区、风险等级和 Middleware 再判断一次。可以把它理解成两道门:Registry 决定“系统有没有这项能力”,授权层决定“当前请求能不能使用它”。
最小 ToolRegistry
我们先实现最基本的版本:
from __future__ import annotations
from typing import Any, Callable


class ToolRegistry:

    def __init__(self):
        self._tools: dict[
            str,
            Callable[..., Any]
        ] = {}

    def register(
        self,
        func: Callable[..., Any],
        name: str | None = None,
    ) -> None:
        tool_name = (
            name
            or func.__name__
        )

        if tool_name in self._tools:
            raise ValueError(
                f"工具已存在:{tool_name}"
            )

        self._tools[tool_name] = func

    def get(
        self,
        name: str,
    ) -> Callable[..., Any]:
        if name not in self._tools:
            raise KeyError(
                f"工具不存在:{name}"
            )

        return self._tools[name]

    def list_tools(self) -> list[str]:
        return list(
            self._tools.keys()
        )

    def execute(
        self,
        name: str,
        **arguments: Any,
    ) -> Any:
        func = self.get(name)

        return func(
            **arguments
        )


def read_file(path: str) -> str:
    return f"读取:{path}"


def write_file(
    path: str,
    content: str,
) -> str:
    return (
        f"写入:{path},"
        f"内容长度:{len(content)}"
    )


if __name__ == "__main__":
    registry = ToolRegistry()

    registry.register(
        read_file
    )

    registry.register(
        write_file
    )

    print(
        registry.list_tools()
    )

    result = registry.execute(
        "read_file",
        path="app.py",
    )

    print(result)
这个版本已经支持:
register
get
list_tools
execute
为什么 register() 要检查重名?
如果后面某个模块又注册:
def read_file(...):
    ...
如果直接覆盖,Agent 行为可能悄悄变化。
尤其大型项目里,最危险的是,程序还能跑,但执行的是另一份 Tool。
所以默认更稳的是:
if name already exists:
    raise
如果确实要覆盖,可以显式设计:
replace=True而不是静默覆盖。
为什么 list_tools() 很重要?
很多人一开始只关心 get(name),觉得能查到工具就够了。但从 Agent 的视角看,list_tools() 才是把“整个能力面”展示给模型和调试系统的入口。
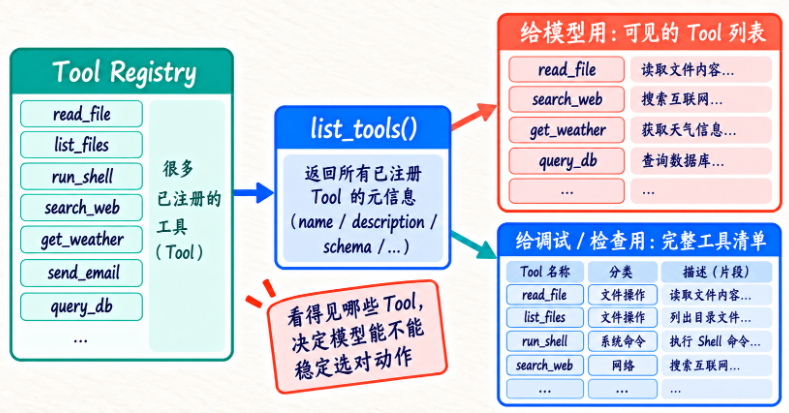
换句话说,模型能不能稳定挑对动作,前提是它先要看见一份完整、结构清楚、描述足够的工具列表。调试时也是一样,完整清单能让我们很快核对到底注册了什么、缺了什么。
因为模型需要知道,当前可以调用什么。
后面的 Tool Schema 就会基于 Registry 生成:
read_file
write_file
run_python
...
所以 list_tools() 不只是给开发者打印。
它会成为:
Registry
 ↓
Tool Schemas
 ↓
Provider
 ↓
LLM
的重要入口。
这就是为什么我们说 Registry 是“能力目录”。
















请登录后查看评论内容