

很多 Demo 做到:
模型会输出 Tool Call就结束了。
但真实工程最难的是,Tool Call 能不能被可靠执行。
至少有六类问题。
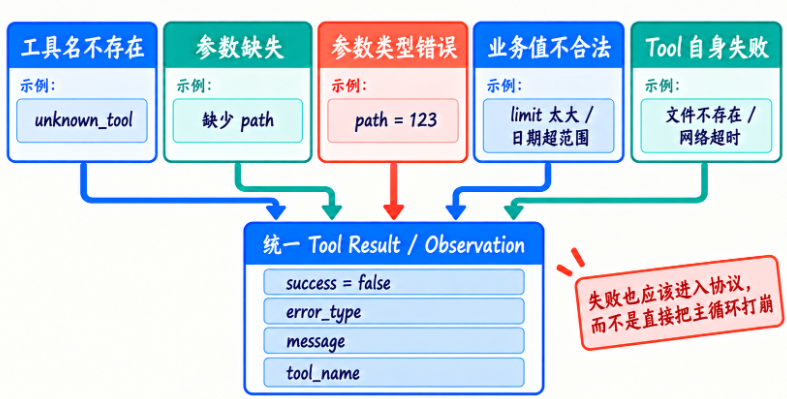
先把常见问题集中看一眼,会更容易建立排查顺序。很多时候不是 Tool Calling 本身不会写,而是不同类型的错误混在一起,导致你不知道该从哪下手。
这张图能帮你迅速判断:是工具名问题、参数问题、业务规则问题,还是工具自身执行失败。把失败统一进协议里,后面的恢复与重试才有基础。
1. 工具名不存在
模型可能输出:
{
  "name": "read_python_file",
  "arguments": {
    "path": "app.py"
  }
}
但我们的工具只有:
read_file这时不能:
TOOLS[name]直接抛 KeyError。
应该形成:
UnknownTool然后作为 Observation 返回。
模型可能下一轮修正成:
read_file2. 参数缺失
例如:
{
  "name": "read_file",
  "arguments": {}
}
如果直接执行:
read_file()会:
TypeError更好的做法是先校验。
3. 参数类型不对
例如:
{
  "name": "read_file",
  "arguments": {
    "path": 123
  }
}
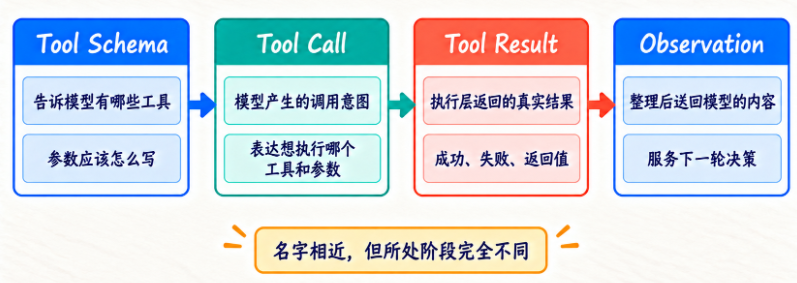
后面 Tool Schema 会帮助模型更少犯错。
但 Harness 仍然要校验。
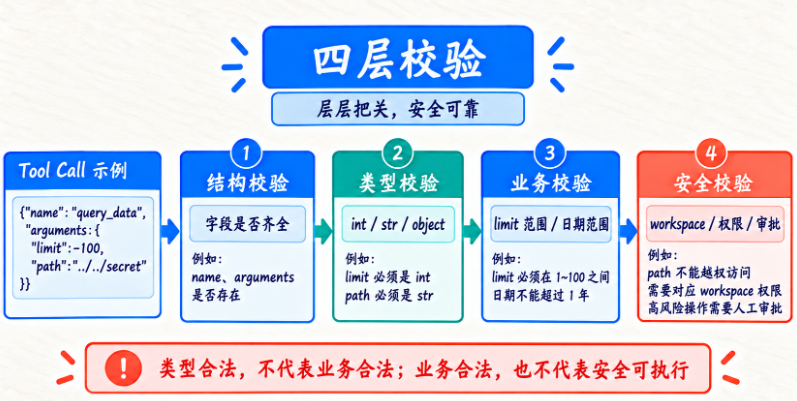
4. 参数业务值不合法
例如:
{
  "name": "query_data",
  "arguments": {
    "limit": 999999999
  }
}
类型是 int。
但业务不允许。
所以 Schema 只是第一层,Middleware / Tool 内部还需要业务约束。
5. Tool 自身失败
例如:
网络超时
数据库不可用
文件不存在
权限不足
这些都应该结构化。
6. Tool 有副作用
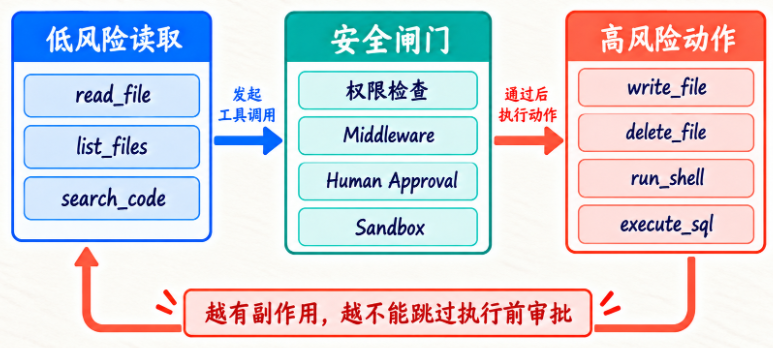
讲到这一类 Tool,最好单独多看一眼执行边界。因为 write_file、run_shell、execute_sql 这类动作,一旦过线,现实环境就真的被改掉了。
所以这里的重点不是“模型会不会调用”,而是“系统愿不愿意放行”。权限、Middleware、人工审批和 Sandbox,都是在保护这条边界。
这是最危险的。
例如:
write_file
delete_file
run_shell
send_email
execute_sql
这些 Tool 不是“读一下”。
它们会真的改变世界。
所以后面必须有:
Permission
Middleware
Human Approval
Sandbox
一个带参数检查的完整最小工具系统
下面我们用 inspect.signature() 做一层简单结构校验。
signature.bind(**arguments) 只能检查参数是否缺失、多余,以及调用形状是否匹配,** 不会自动验证 path: str 中的值真的是字符串**。所以上面的 read_file() 仍然保留了 isinstance() 检查。下一节和 Tool Schema 章节会继续把结构校验、类型校验与业务校验分开。
这个系统还很小,但已经有:
Tool Registry
Tool Lookup
Argument Binding
Tool Execution
Error Result
下一节我们会正式把 Tool Registry 抽出来。
再下一节,会继续解决,模型怎么知道每个 Tool 有哪些参数?
答案就是,Tool Schema。
配套的第 03 阶段项目可以先验证“注册、暴露 Schema、统一执行”这条短链路:
cd agent_harness_course_projects
python3 projects/03_tool_registry_schema/main.py
离线版本跑通后,我们再把同一个闭环交给真实模型:
export DEEPSEEK_API_KEY='替换为自己的 Key'
export DEEPSEEK_MODEL='deepseek-flash'  # 可省略,课程默认值
python3 projects/03_tool_registry_schema/deepseek_tool_demo.py
这次 double 是否被调用,不再由脚本提前写死,而是 DeepSeek 阅读 Tool Schema 后决定。请把注意力放在 tool_history 上:模型先生成调用意图,Harness 校验并执行,Observation 回到下一轮,模型最后才组织答案。真实模型偶尔会选择不同表达,这种不确定性恰好让我们看清 Harness 为什么需要 Schema、预算和 Trace。
DeepSeek 返回的 function.arguments 仍然只是 JSON 字符串,不能直接视为可信参数。Harness 必须先解析 JSON,再按 Tool Schema、业务规则和权限边界验证;只有通过验证后才能调用真实函数。Tool Result 回传时还要携带原始 tool_call_id,否则并行调用或多轮调用会失去对应关系。
预期先看到 add 工具的 Schema,再看到执行结果 5。这里要留意一个边界:当前 ToolRegistry.execute() 负责查找并调用函数,parameters 主要用于向模型描述工具,还没有在执行前自动运行完整 JSON Schema 校验。也就是说,“Schema 已经展示出来”和“参数已经被执行层验证”不是一回事,后续仍要补校验层。
当前通用 AgentEngine 遇到 Registry 抛出的未知工具或执行异常时,也会先把整个 Run 标记为失败;本节手写的 ToolResult 则展示了“把可恢复错误送回模型”的目标形态。读代码时不要把这两个阶段混为一谈:Registry 解决统一查找和调用,Error Recovery 还需要在 Engine 与执行器之间补上错误分类、结构化回传和重试边界,第 10 节会专门完成这部分设计。
请求超时后,我们还能再执行一次吗
读取文件超时后,通常可以再次读取;创建工单超时就需要停下来确认。可能工单尚未创建,也可能服务器已经创建成功,只是响应没有回来。这两个状态在客户端看起来都是“超时”,后续处理却不同。我们不能仅凭一个错误字符串确定外部结果。
幂等键需要执行端或外部服务配合。第一次请求将键与动作绑定并记录结果,重复请求才能查询或复用同一结果。如果只是给 ToolCall 增加一个 idempotency_key 字段,而工具根本不检查它,重复执行仍然会发生。对于不支持幂等的服务,我们可以先查询状态;仍然无法确认时,应保留“结果未知”,避免自动再次提交。
工具调用的消息关联同样重要。模型发出的调用标识、Harness 执行记录和回传结果,应指向同一个请求。批量调用时,不能依靠列表位置碰巧对齐。副作用与风险元数据帮助选择策略,但最终的校验和去重仍要在执行路径生效。
超时这一节如果只看文字,很多同学会下意识觉得“没收到响应 = 没执行成功”。实际上并不是这样。下面这张图把读操作和有副作用操作分开以后,处理逻辑就会清楚很多。
读操作往往可以直接重试;副作用动作则要先确认状态,再谈幂等和去重。否则系统表面上是在“补救”,实际上可能是在重复制造副作用。
动手复现:成功了,却没有收到响应
用一个本地计数器模拟创建操作:首次执行增加一次计数,然后故意抛出超时。先观察直接重试会发生什么,再加入以业务动作键保存结果的记录。参考结果是,同一业务动作最多增加一次;换用相同键却改变参数时,应拒绝复用,而不是返回另一项任务的结果。
案例分析一:模型说“读取 app.py”,为什么真实系统却必须经过 5 层处理?
在真正进入案例之前,先看一下这条链路的全貌。它非常适合拿来理解“模型说要读文件”和“系统真的把文件打开”之间到底隔着什么。
把这张图记住以后,后面的案例细节会顺很多。你会发现,工程里并不是多做了几件无关紧要的事,而是每一层都在解决一个真实风险点。
场景背景
Coding Agent 接到任务,“帮我检查 app.py 为什么报错。”
模型第一轮输出:
{
  "name": "read_file",
  "arguments": {
    "path": "app.py"
  }
}
很多 Demo 到这里就说,“模型调用了 read_file。”
但工程里还远远没结束。
真实约束
假设 Tool:
read_file(path)并且系统要求:
只能读 workspace/
不能读隐藏密钥目录
路径必须是字符串
文件最大 1 MB
实际处理
Harness 第一层:
解析 Tool Call得到:
name = read_file
path = app.py
第二层:
Registry 查找确认:
read_file 存在第三层:
Schema / 参数校验确认:
path 存在
path 是字符串
第四层:
安全检查把:
app.py解析到:
workspace/app.py并确认没有逃逸。
第五层:
真正打开文件最后得到:
from flask import Flask
...
再形成:
{
  "ok": true,
  "tool": "read_file",
  "result": "..."
}
回到 Agent。
结果
下一轮模型看到文件内容后,才真正开始分析。
复盘
这个案例说明,模型只是“动作发起者”。
而 Agent Harness 才是真正“动作执行控制器”。
所以以后看到:
Tool Calling不要把它脑补成,“模型拥有系统权限。”
更准确的是,“模型向 Harness 提交一个执行请求。”
这个理解会直接决定后面安全架构是否靠谱。
















请登录后查看评论内容