



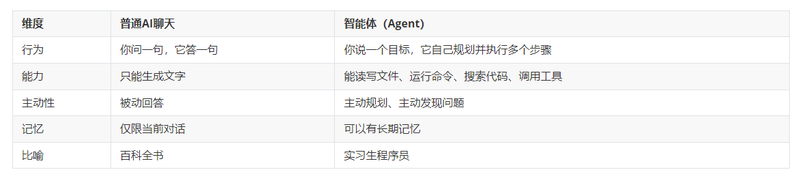
1.2 Agentic Engineering:工程化升级范式
1.2.1 为什么纯 Vibe Coding 在大项目中不够用 Vibe Coding 对于做小项目、快速原型非常好用,但当项目变大变复杂时,纯粹的'跟着感觉走'会遇到麻烦: 代码质量不可控:AI可能写出能跑但很乱的...

章末自测
题目 1:Data Analysis Agent 与普通 Text-to-SQL 最大的区别是什么?请用“为什么昨天收入下降?”说明。 Text-to-SQL 通常把一个自然语言问题转换成一次 SQL,然后根据结果回答,更适合“昨天...
案例分析二:如果第一步发现请求量下降 40%,Agent 为什么不应该继续照固定流程去查 eCPM?
场景背景 另一天。 用户同样问,“为什么收入下降?” Query 1: income -38% request -41% impression -39% eCPM +2% 如果系统是固定 Workflow: 总指标 → 媒体 eCPM → 广告位 eCPM 就会走错...
案例分析一:收入下降约 25.4%,我们如何定位到 Media A 的 position_102,并继续核查 eCPM 变化?
场景背景 用户,“为什么昨天收入突然下降?” 第一步,Agent 不应该马上猜: 某个媒体挂了。 而是先查整体。 Query 1: date request impression click income ecpm Observation: 收入 -25.4%...
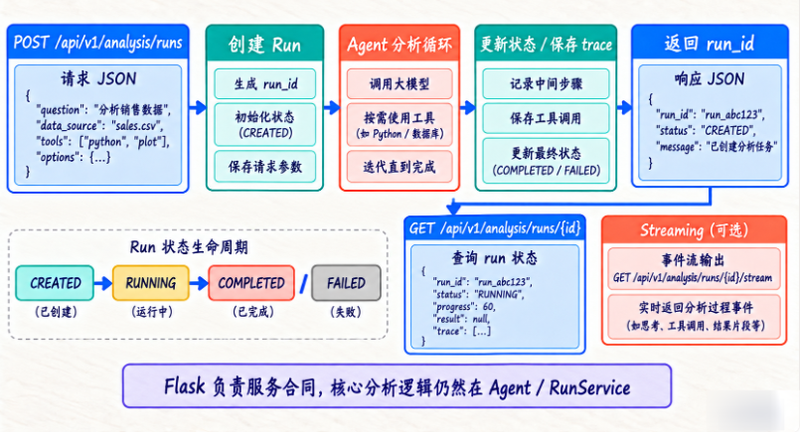
小节六:用 Flask 封装 Data Agent——让“为什么下降”变成真正可以调用的分析服务
前面的分析链路能在脚本中运行以后,还要解决请求如何提交、Run 如何记录,以及客户端怎样查询任务状态。把这些职责拆开,Flask 接口就不用承担全部分析逻辑。 图示将创建 Run、分析循环、状态...
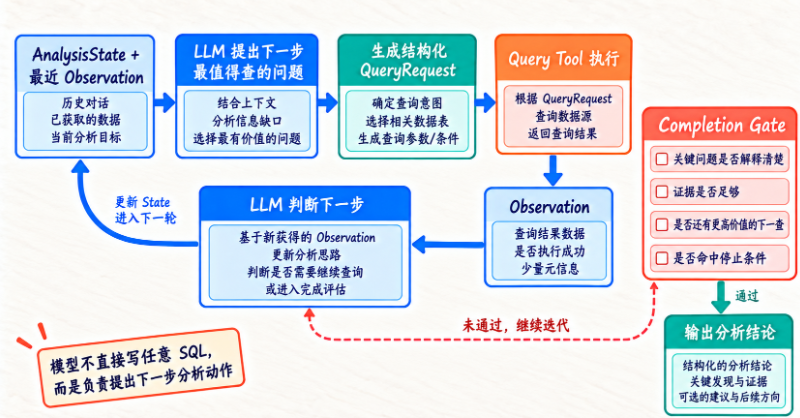
小节五:把 LLM 接进分析循环——模型负责提出“下一步最值得查的问题”,Query Tool 负责安全执行
模型接入之后,真正发生变化的是下一步分析动作由谁提出,而不是把查询校验和执行也交给模型。下面的循环图把它与 Query Tool 的执行职责拆开了。 模型结合最新 Observation 和当前状态产生 Que...
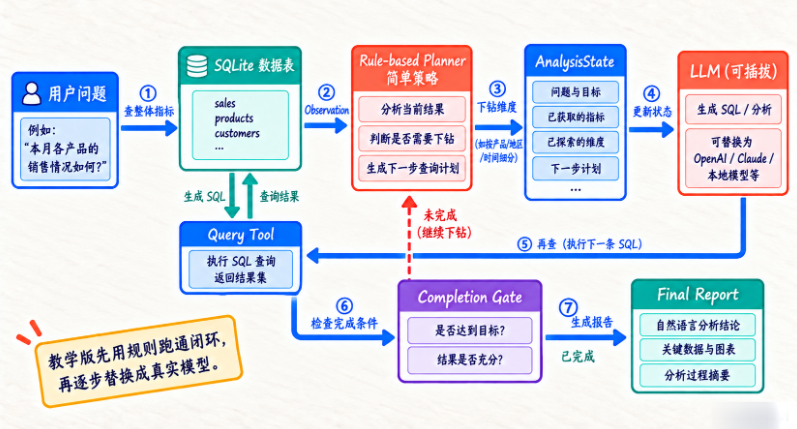
小节四:实现一个真正可运行的最小 Data Analysis Agent——用 SQLite 模拟完整异常分析闭环
到了可运行示例,最值得抓住的是任务怎样从一次查询转成下一次查询。教学版先用 SQLite 和明确的决策规则走通完整链路,再把决策组件替换为真实模型。 注意观察每次 Query Result 怎样更新 Anal...
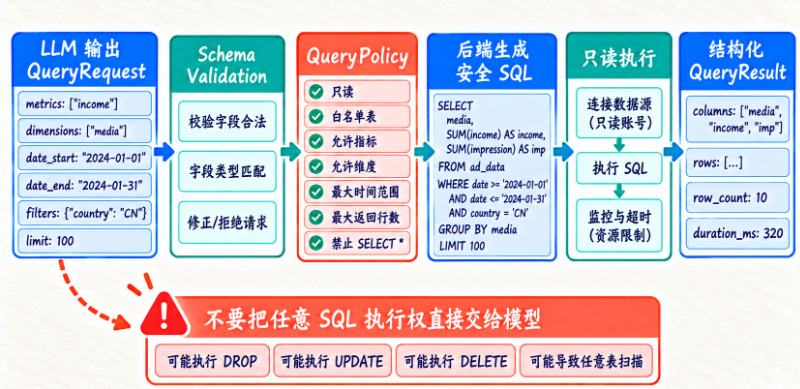
小节三:Query Tool 怎么设计——不要把“任意 SQL 执行权”直接交给模型
接下来把模型提出查询意图、后端检查策略与真正执行分开看。模型应提出结构化请求,而不是因为能写出 SQL 就自动获得数据库执行权。 图里的 Schema Validation、Query Policy 和只读执行是不同...
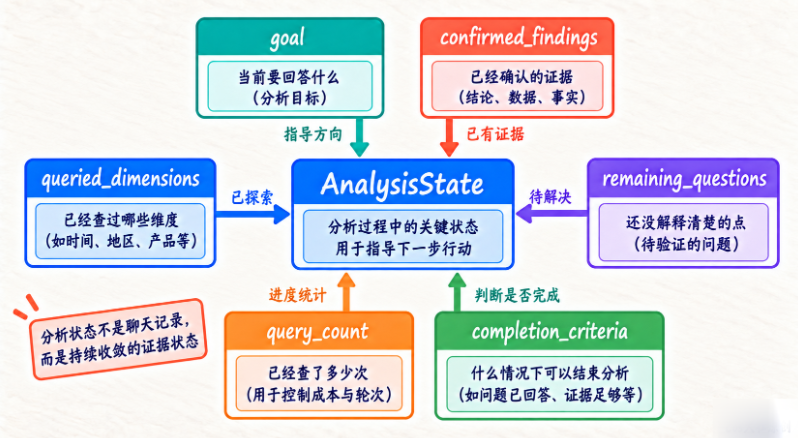
小节二:Data Agent 需要怎样的 Analysis State——分析不是聊天记录,而是一个不断收敛的证据状态
在连续分析中,真正需要承接的不是逐句聊天记录,而是已经回答了什么、哪些结论有证据支持、查过哪些维度,以及还剩哪些问题。下面这张图把这些字段与中心状态放在了一起。 confirmed_findings&...
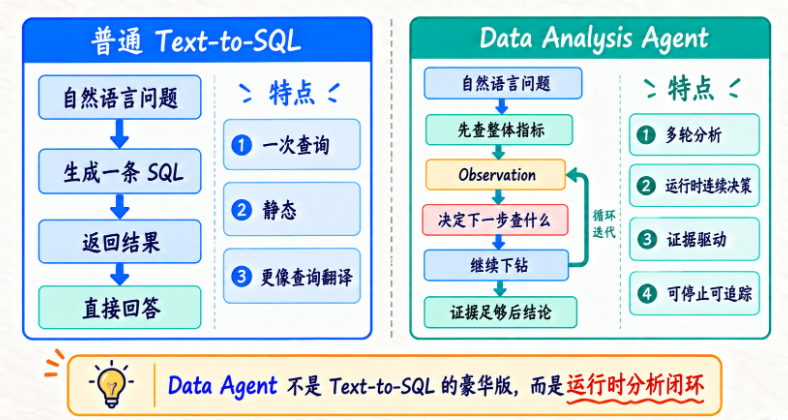
小节一:为什么 Data Agent 不是 Text-to-SQL 的“豪华版”——最大的区别是运行时连续决策
把普通 Text-to-SQL 与 Data Analysis Agent 并排看,会更容易理解这一节讨论的并不是模型能不能生成 SQL,而是查询结果是否会改变后续决策。 左边完成单次翻译、执行和回答;右边根据本轮结果...

