

- 正规方程法介绍
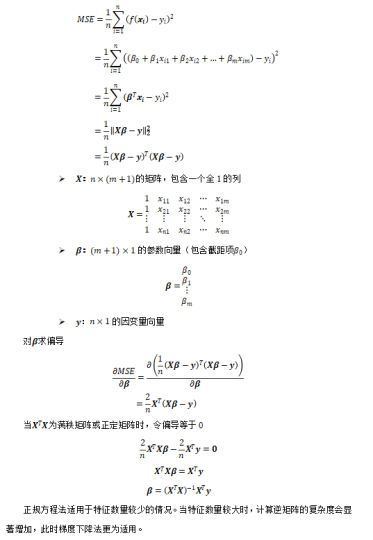
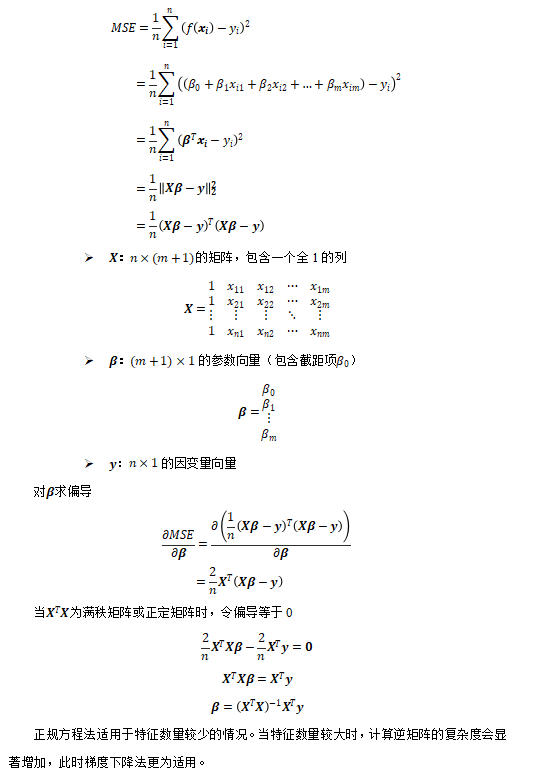
正规方程法(Normal Equation)是一种用于求解线性回归的解析解的方法。它基于最小二乘法,通过求解矩阵方程来直接获得参数值。
将损失函数转换为矩阵形式:
2.API使用
# fit_intercept: 是否计算偏置
model = sklearn.linear_model.LinearRegression(fit_intercept=True)
model.fit([[0, 3], [1, 2], [2, 1]], [0, 1, 2])
# coef_: 系数
print(model.coef_)
# intercept_: 偏置
print(model.intercept_)
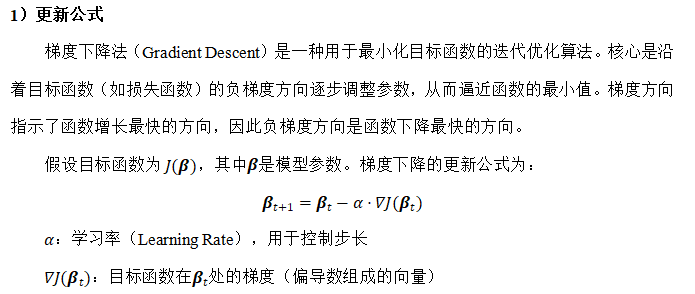
4.2.4 梯度下降法
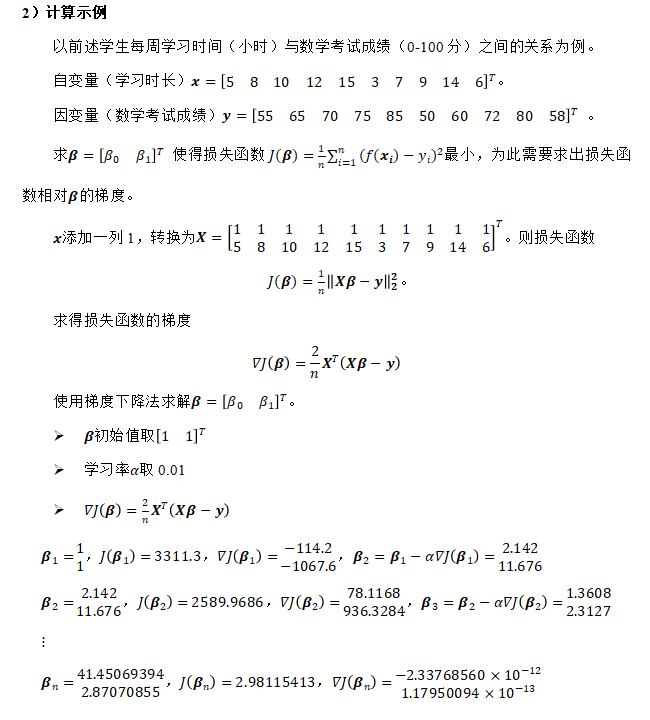
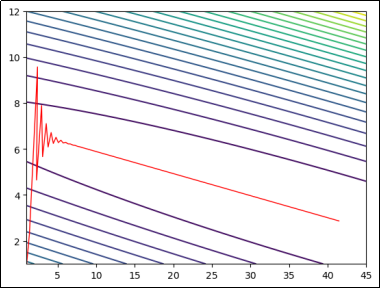
示例代码:
import numpy as np

def J(beta):
    """目标函数"""
    return np.sum((X @ beta - y) ** 2, axis=0).reshape(-1, 1) / n

def gradient(beta):
    """梯度"""
    return X.T @ (X @ beta - y) / n * 2

X = np.array([[5], [8], [10], [12], [15], [3], [7], [9], [14], [6]])  # 自变量,每周学习时长
y = np.array([[55], [65], [70], [75], [85], [50], [60], [72], [80], [58]])  # 因变量,数学考试成绩
beta = np.array([[1], [1]])  # 初始化参数
n = X.shape[0]  # 样本数
X = np.hstack([np.ones((n, 1)), X])  # X添加一列1,与偏置项相乘
alpha = 1e-2  # 学习率
epoch = 0  # 迭代次数
while (j := J(beta)) > 1e-10 and (epoch := epoch + 1) <= 10000:
    grad = gradient(beta)  # 求解梯度
    if epoch % 1000 == 0:
        print(f"beta={beta.reshape(-1)}\tJ={j.reshape(-1)}")
beta = beta - alpha * grad # 更新参数3)学习率的选择
学习率过大:可能导致跳过最优解,甚至发散。
学习率过小:收敛速度慢,易陷入局部极小。
自适应学习率:高级优化器(如Adam、Adagrad)动态调整学习率以提升性能。
4)梯度下降法常见问题
1.特征缩放
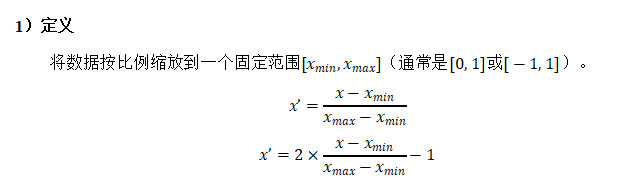
通常需要提前对特征进行缩放(如标准化或归一化),以加快收敛速度。
2.局部极小值、鞍点问题
可能陷入局部极小值(非全局最优解),或遇到鞍点(梯度为零但非极值点)。
解决方案:使用动量(Momentum)、自适应优化器(如Adam)或二阶方法(如牛顿法)。
5)API使用
model = sklearn.linear_model.SGDRegressor(
    loss="squared_error",  # 损失函数,默认为均方误差
    fit_intercept=True,  # 是否计算偏置
    learning_rate="constant",  # 学习率策略
    eta0=0.1,  # 初始学习率
    max_iter=1000,  # 最大迭代次数
    tol=1e-8,  # 损失值变化量小于tol时停止迭代
)
model.fit([[0, 3], [1, 2], [2, 1]], [0, 1, 2])
# coef_: 系数
print(model.coef_)
# intercept_: 偏置
print(model.intercept_)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END










请登录后查看评论内容