

3.3.1 概述
在分词完成之后,文本被转换为一系列的 token(词、子词或字符)。然而,这些符号本身对计算机而言是不可计算的。因此,为了让模型能够理解和处理文本,必须将这些 token 转换为计算机可以识别和操作的数值形式,这一步就是所谓的词表示(word representation)。
词表示的发展经历了从稀疏的one-hot编码,到稠密的语义化词向量,再到近年来的上下文相关的词表示。不同的词表示方法在表达能力、语义建模、上下文适应性等方面存在显著差异。
3.3.2 One-hot编码
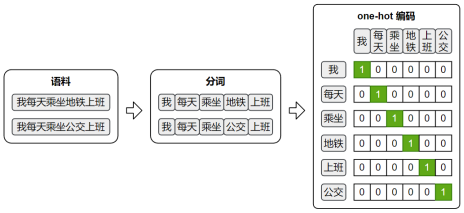
最早期的词向量表示方式是 One-hot 编码:它将词汇表中的每个词映射为一个稀疏向量,向量的长度等于整个词表的大小。该词在对应的位置为1,其他位置为0。
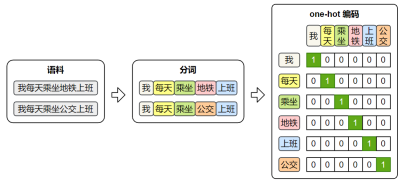
one-hot虽然实现简单、直观易懂,但它无法体现词与词之间的语义关系,且随着词表规模的扩大,向量维度会迅速膨胀,导致计算效率低下。因此,在实际自然语言处理任务中,one-hot表示已经很少被直接使用。
3.3.3 语义化词向量
传统的
one-hot表示虽然结构简单,但它无法反映词语之间的语义关系,也无法衡量词与词之间的相似度。为了解决这个问题,研究者提出了Word2Vec模型,它通过对大规模语料的学习,为每个词生成一个具有语义意义的稠密向量表示。这些向量能够在连续空间中表达词与词之间的关系,使得“意思相近”的词在空间中距离更近。
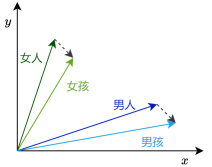
3.3.3.1 Word2Vec概述
Word2Vec的设计理念源自“分布假设”——即一个词的含义由它周围的词决定。
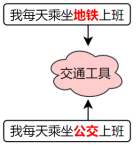
基于这一假设,Word2Vec构建了一个简洁的神经网络模型,通过学习词与上下文之间的关系,自动为每个词生成一个能够反映语义特征的向量表示。
Word2Vec提供了两种典型的模型结构,用于实现对词向量的学习:
- CBOW(Continuous Bag-of-Words)模型
输入是一个词的上下文(即前后若干个词),模型的目标是预测中间的目标词。
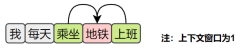
- Skip-gram模型
输入是一个中心词,模型的目标是预测其上下文中的所有词(即前后若干个词)。
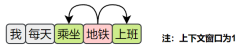
只要按照上述目标训练模型,就能得到语义化的词向量。
3.3.3.2 Word2Vec原理
- 数据集
Word2Vec 不依赖人工标注,而是直接利用大规模原始文本(如书籍、新闻、网页等)作为数据源,从中自动构造训练样本。
由于两种模型的输入和输出都是词语,因此首先需要对原始文本进行分词,将连续文本转换为 token 序列。
此外,模型无法直接处理文本符号,训练时仍需将词语转换为 one-hot 编码,以便作为模型的输入和输出进行计算。
2.Skip-Gram
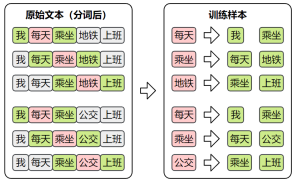
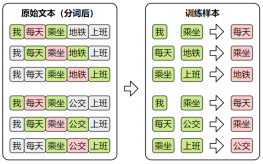
1)训练数据集
Skip-Gram的目标是根据中间词预测上下文,所以其训练样本为:
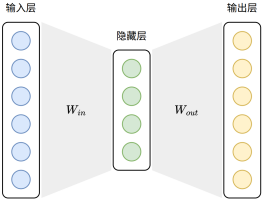
2)模型结构
Skip-Gram模型结构如下图所示:
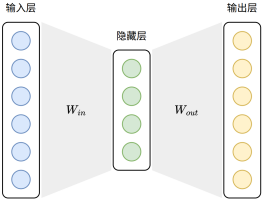
Skip-Gram
模型损失值的计算图如下图所示:
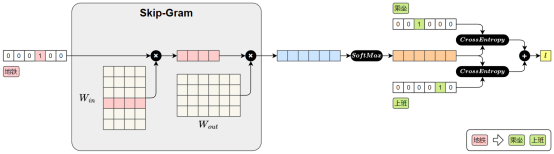
前向传播过程如下:
1.输入中心词(地铁)
“地铁”用 one-hot 向量表示
2.查找词向量()
与参数矩阵相乘,取出“地铁”对应的词向量。(
实际上就是词向量矩阵,每一行表示一个词的向量)
3.预测上下文
将中心词向量与参数矩阵 相乘,得到对整个词表的预测得分。
4.Softmax 输出
得分通过 Softmax 转为概率分布,表示各词作为上下文的可能性。
5.计算损失
与真实上下文词“乘坐”、“上班”进行比对,计算交叉熵损失并求和,得到总损失。
3)CBOW
(1)训练样本
CBOW的目标是根据上下文预测中间词,所以其训练样本为:
(2)模型结构
CBOW模型的结构如下图所示:
CBOW模型损失值的计算图如下图所示:
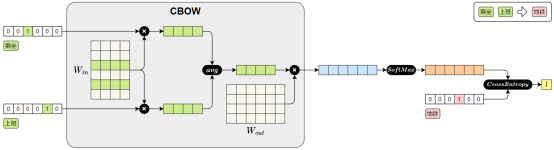
CBOW 模型的前向传播过程如下:
1.输入上下文词(乘坐、上班)
每个词用 one-hot 向量表示。
2.查找词向量()
每个 one-hot 向量与参数矩阵 相乘,查出对应的词向量。
( 实际上就是词向量矩阵,每一行表示一个词的向量)
3.平均上下文向量
将多个上下文词向量取平均,得到一个整体的上下文表示。
4.预测中心词
将平均后的上下文向量与参数矩阵相乘,得到对整个词表的预测得分。
5.Softmax 输出
将得分输入Softmax,得到每个词作为中心词的概率分布。












请登录后查看评论内容